
优化器:从SGD、AdamW到Muon与SOAP
- 符号约定
- 引言:被遗忘的设计轴
- 一阶优化器:从SGD到动量
- 自适应时代:AdaGrad、RMSProp、Adam与AdamW
- Lion:程序搜出来的极简主义
- 看图说话:为什么需要预条件
- 矩阵优化器:Shampoo、SOAP与Muon
- 代码实验:病态峡谷里的五强争霸
- 统一视角:预条件的阶梯
- 冷静一下:独立基准的真实账
- 成绩单:水与CDP的正面对决
- 稀疏监督下的分水岭
- 结语
- 参考
符号约定
本章公式密集,符号统一约定如下,供随时查阅。
基本量
| 符号 | 含义 |
|---|---|
| $w$ | 参数向量 |
| $\nabla\mathcal{L}(w)$ | 梯度(不另设简写) |
| $\eta$ | 学习率 |
| $\mathcal{L}$ | 损失函数 |
| $H$ | Hessian 矩阵 $\nabla^2\mathcal{L}$ |
| $\lambda_i$ | $H$ 的第 $i$ 个特征值(下标区分于权重衰减 $\lambda$) |
| $\kappa=\lambda_{\max}/\lambda_{\min}$ | 条件数 |
| $\mu$ | 动量系数(heavy-ball) |
| $d$ | 参数空间维度 |
| $\sigma$ | 梯度噪声标准差(实验中) |
Adam 家族
| 符号 | 含义 |
|---|---|
| $m_t$ | 一阶矩(动量缓冲),贯穿动量法、Adam、Lion |
| $v_t$ | 二阶矩(梯度平方的滑动平均),用于 AdaGrad/RMSProp/Adam |
| $\beta_1,\beta_2$ | Adam 衰减系数($\beta_1$ 管 $m$,$\beta_2$ 管 $v$) |
| $\hat{m}_t,\hat{v}_t$ | 偏差修正后的 $m_t,v_t$ |
| $\epsilon$ | 数值稳定小常数 |
| $\lambda$ | 权重衰减系数(AdamW,无下标以区分特征值 $\lambda_i$) |
矩阵优化器
| 符号 | 含义 |
|---|---|
| $W$ | 权重矩阵 $m\times n$($m,n$ 为行/列维度) |
| $G$ | 梯度矩阵 |
| $P$ | 预条件矩阵 |
| $L,R$ | 左/右预条件子(行空间/列空间) |
| $p$ | Kronecker 预条件指数($p{=}1/4$ Shampoo,$p{=}1/2$ 投影) |
| $Q_L,Q_R$ | $L,R$ 的特征向量矩阵 |
| $U,\Sigma,V$ | $G$ 的 SVD 分解 |
| $O^\ast=UV^{\mathsf T}$ | 半正交投影(Frobenius 范数最近) |
| $M_t$ | Muon 的动量矩阵(矩阵版 $m_t$,大写区分) |
| $\mathrm{msign}(M)$ | 矩阵符号函数 $=UV^{\mathsf T}$ |
| $\Phi$ | 范数约束优化中的更新方向矩阵 |
范数与运算
| 符号 | 含义 | ||
|---|---|---|---|
| $\ | \cdot\ | _2$ | 谱范数(最大奇异值) |
| $\ | \cdot\ | _F$ | Frobenius 范数 |
| $\ | \cdot\ | _*$ | 核范数(奇异值之和) |
| $\otimes$ | Kronecker 积 | ||
| $\mathrm{vec}(\cdot)$ | 矩阵按列拉直为向量 |
引言:被遗忘的设计轴
这个专栏到目前为止讲的其实都是”喂什么”和”用什么装”:通用势的数据集版图 提供燃料,通用势的竞技场:MatBench Discovery与OC20 制定规则,通用势模型巡礼:从MACE-MP-0到UMA 盘点选手。还有一个环节始终隐身于幕后——这些模型到底是怎么训出来的。
答案出奇地无聊:Adam,或者它的近亲AdamW。从2015年Kingma和Ba提出至今,Adam家族统治深度学习优化十年有余,MLIP社区更是把它焊死在了默认配置里——即便是 通用势模型巡礼:从MACE-MP-0到UMA 里UMA、SevenNet-Omni这种亿级构型起步的基础势训练,公开的训练配方里依然是Adam家族。架构卷出了花,数据堆到了天文数字,优化器却十年如一日。
转机来自隔壁的LLM战场。大模型scaling竞赛的白热化让一批矩阵结构优化器强势复兴:显式结构化预条件的Shampoo、SOAP、Kron、SPlus,做正交化更新的Muon、Scion、Gluon,以及SOAP-Muon、COSMOS这类混合方案。它们在语言模型上展示了更快的收敛速度。2026年7月,NequIP的”娘家”——哈佛Kozinsky组把Muon、SOAP、SOAP-Muon系统地搬进了自己的nequip训练框架(arXiv:2607.02499, “Beyond Adam”),第一次严肃地回答了那个所有MLIP从业者都默认不需要回答的问题:换个优化器,值得吗?
剧透:非常值得。但在展开实验之前,我们得先把优化的原理从头捋一遍——这恰好也是一堂不错的深度学习优化课。全文其实只有一条主线:所有现代优化器都在做同一件事——把朴素梯度改造成某种意义下的”等曲率更新”;它们的分歧,仅仅在于对损失景观几何做了多强的假设。
一阶优化器:从SGD到动量
优化器的发展史,本质上就是研究者不断给”下山找最低点”这个动作打补丁的过程。我们按补丁出现的顺序,一张一张拆给你看。一切从最朴素的想法开始。训练就是最小化损失函数$\mathcal{L}(w)$,负梯度方向是局部下降最陡的方向,于是参数沿着它挪一小步:
这就是随机梯度下降(SGD),深度学习的祖师爷级算法。它有多挑地形?在最简单的二次型目标$\mathcal{L}(w)=\frac{1}{2}w^{\mathsf T}Hw$上就能看清楚,其中$H$是对称正定的Hessian,特征值$\lambda_1\ge\lambda_2\ge\dots\ge\lambda_d>0$。把更新规则逐坐标展开,误差按等比数列衰减:
要让每个坐标都稳定不发散,必须$|1-\eta\lambda_1|<1$,即学习率存在硬上限:
矛盾由此而来:步长上限由最陡的方向$\lambda_1$决定,收敛速度却由最平的方向$\lambda_d$决定——沿第$i$个方向把误差压缩到$\epsilon$需要$t\approx(\eta\lambda_i)^{-1}\ln(1/\epsilon)$步,取满上限也有$O!\big(\kappa\ln\frac{1}{\epsilon}\big)$的复杂度,其中$\kappa=\lambda_1/\lambda_d$是损失面的条件数。更难堪的是,当$\eta$逼近临界值时$(1-\eta\lambda_1)\to-1$,符号逐轮翻转——这正是SGD锯齿形轨迹的来源:在陡峭方向来回横跳,净进展几乎全靠平坦方向一步一步蹭。
第一个经典修补是动量:不再直接使用当前梯度,而是维护历史梯度的指数滑动平均,用它作为更新方向。这笔”让小球记住惯性”的旧账可以追溯到Polyak 1964年提出的heavy-ball方法,资历比深度学习本身还老,但至今仍是基础组件:
在梯度方向一致的分量上,历史梯度不断累加,等效学习率放大约$\frac{1}{1-\mu}$倍;而在来回震荡的方向上,正负交替的分量在平均中相互抵消——对二次型做动力学分析可知,此时更新的特征方程$r^2-(1+\mu-\eta\lambda)r+\mu=0$具有共轭复根,震荡包络以每步$\sqrt{\mu}$的比率衰减。物理系的读者会心一笑:这就是欠阻尼运动,$\mu$扮演摩擦系数。值得一提的是,把$\mu$和$\eta$调到最优时,heavy-ball在二次型上的收敛复杂度能从$O(\kappa\ln\frac1\epsilon)$改善到$O(\sqrt\kappa\ln\frac1\epsilon)$——有效条件数从$\kappa$开方降到$\sqrt\kappa$,这是动量法在理论上”真的更快”的依据,也是它六十年来没被淘汰的底牌。Nesterov变体再多走半步——先按惯性前瞻一段距离,再在前瞻点处计算梯度:
相当于提前”踩刹车”,收敛分析可以证明它对光滑凸问题的复杂度比普通动量更优。这些修补治好了震荡,但没有触及病根:整个更新过程仍然只有”梯度方向×统一标量”这一个自由度,对曲率的结构依然一无所知。
自适应时代:AdaGrad、RMSProp、Adam与AdamW
对症的药方是承认不同方向就该有不同的步长。对损失面在当前点做二阶泰勒展开:
对$\delta$求极小,立刻得到牛顿步$\delta^\ast=-H^{-1}\nabla\mathcal{L}(w)$。习惯上把它写成预条件化(preconditioning)的一般形式:
其中$P$是刻画局部曲率的正定矩阵。牛顿法的威力仍可用二次型一眼看穿:若$P=H$精确成立,则$w_1=w_0-H^{-1}Hw_0=0$——一步直达极小点,条件数再大也无所谓。代价是存储并求逆一个$d\times d$的矩阵,$d$到千万乃至亿级时纯属天方夜谭。于是所有实用优化器都在做同一件事:用便宜得多的$P$逼近$H$。不同选择就是不同优化器——这条公式是全章的”总公式”:
| 选 $P$ 为 | $P^{-1}\nabla\mathcal{L}$ 变成 | 对应优化器 |
|---|---|---|
| $I$(单位阵) | $\nabla\mathcal{L}(w)$(裸梯度) | SGD |
| $\mathrm{diag}(\hat v)^{1/2}$(对角) | $\nabla\mathcal{L}(w)/\sqrt{\hat v}$(逐元素缩放) | Adam |
| $L\otimes R$(Kronecker) | $L^{-1}\nabla\mathcal{L}(w)\,R^{-1}$(矩阵缩放) | Shampoo |
| $H$(Hessian) | $H^{-1}\nabla\mathcal{L}(w)$(牛顿步) | 牛顿法(不可行) |
几何上也有一个直观读法。裸梯度 $\nabla\mathcal{L}(w)$ 是欧氏范数($L_2$ 球)下的最速下降——但如果损失面是个扁椭圆($\kappa\gg1$),欧氏最速方向偏向最陡那头、在谷底反复横跳。$P^{-1}\nabla\mathcal{L}(w)$ 是 $P$-范数 $|x|_P=\sqrt{x^{\mathsf T}Px}$ 下的最速下降:它换了”距离”的定义。若 $P\approx H$,在这个范数下椭圆面看起来像圆球,条件数 $\approx1$,梯度下降不再横跳、径直走谷底。一句话:$P$ 是”曲率地图”,$P^{-1}$ 把梯度转进等曲率空间再走——$P$ 越接近 $H$ 越准越直,代价是 $P$ 越大越贵。按这个补丁的演化史走一遍:
AdaGrad(Duchi, Hazan & Singer, 2011)是第一个规模化方案:给每个参数维护历史梯度平方的累加,更新时用它的平方根做逐参数缩放
经常更新的参数步子自动变小,很少更新的参数步子变大——“每个参数自己掌握步幅”的时代由此开启。致命伤也随之而来:平方和单调不减,步幅一路衰减到趋近于零,训练后半段基本走不动。
RMSProp(Tieleman & Hinton, 2012)修的就是这一点:把累加换成指数滑动平均$v_t=\beta_2 v_{t-1}+(1-\beta_2)\big[\nabla\mathcal{L}(w_t)\big]^2$,既保留”看历史幅度”的思想,又再也不必担心步幅衰竭。它还是课代表式的一小步——真正的集大成者是下一位。
Adam(Kingma & Ba, 2015)把上面两条线缝在了一起:一阶矩$m_t$承担动量,二阶矩$v_t$沿用RMSProp的滑动平均,再各配一个偏差修正,保证训练初期估计不偏。它开箱即用、几乎不碰超参,把深度学习优化带进了”默认即正确”的十年。于是十年来,它的几乎每个坐标都长这样:
比值$\hat{m}_t/\sqrt{\hat{v}_t}$还有一个漂亮的统计解读:它是信噪比$\nabla\mathcal{L}/\mathrm{std}(\nabla\mathcal{L})$的经验估计——某坐标的历史梯度持续同号且幅度稳定,就大步前进;梯度忽正忽负、噪声主导,就自动刹车。这让Adam在mini-batch噪声浓重的深度网络训练里如鱼得水。
轴对齐的二次型能把这里的道理看透:$\nabla\mathcal{L}(w)_i=\lambda_i w_i$,所以$v_i$的稳态正比于$\lambda_i^2\langle w_i^2\rangle$,于是$\sqrt{\hat v_i}\propto\lambda_i$、更新$\hat m_i/\sqrt{\hat v_i}$里的$\lambda_i$恰好约掉——各坐标的有效衰减率被拉到同一量级,条件数从$\kappa$压到接近1。下一节”看图说话”里Adam几乎走直线,根子就在这里。
AdamW(Loshchilov & Hutter, 2019)修的是 Adam 的一个隐疾。原始 Adam 把权重衰减以 L2 正则的形式混入梯度:$\nabla\mathcal{L}(w)+\lambda w$,然后被 $\hat v^{-1/2}$ 逐元素缩放。问题在于,不同坐标的 $\hat v_i$ 差异巨大——梯度大的坐标 $\hat v_i$ 大、$1/\sqrt{\hat v_i}$ 小,权重衰减被削弱;梯度小的坐标反而被加重。这等于让权重衰减”看人下菜碟”,完全失去了均匀正则的意义。AdamW 的修法干净利落:把权重衰减从梯度里拿出来,单独施加
衰减率 $(1-\eta\lambda)$ 对所有坐标一视同仁,学习率 $\eta$ 与衰减强度 $\lambda$ 也能独立调参。这一字之差如今已是几乎所有现代训练配方——从 GPT 到 通用势模型巡礼:从MACE-MP-0到UMA 里的 UMA、MACE-MP——的标准配置。
不过必须清醒:无论动量还是对角缩放,消费的都是梯度的一阶统计量(均值与平方均值),曲率的耦合结构被完全丢弃,所以Adam/AdamW本质上仍是一阶优化器——只带了一点对角化的二阶经验。对角预条件的极限在于它只会”缩放”不会”转轴”:如果峡谷斜躺在参数坐标系里($H$的非对角元不可忽略),Adam依然要在歪斜的等高线间挣扎。
说了一堆”步幅衰竭””滑动平均””集大成”,不如让四法在同一条赛道上跑一遍。取$d=20$维、条件数$\kappa=400$的随机旋转二次型(比二维更贴近真实训练的各向异性),让AdaGrad、RMSProp、Adam、AdamW各跑500步,同时记录损失与每步的更新范数$|\Delta w|$:
import numpy as np |
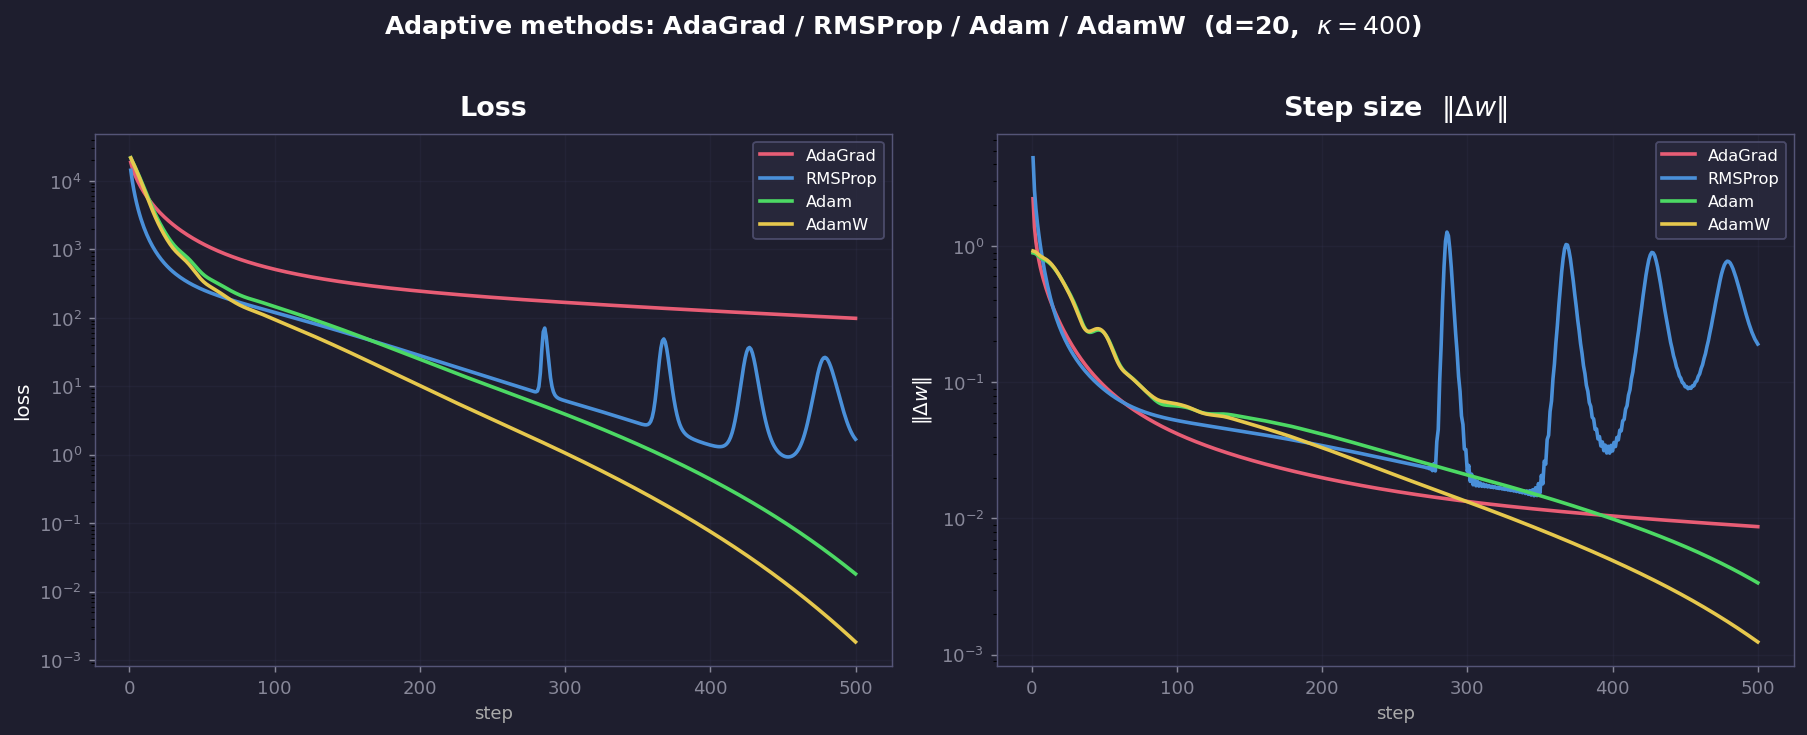
两幅图各说一件事:
左图(loss):500步后,AdaGrad仍停在$10^{2}$量级,比另三个差了近两三个数量级——$v$全程累加,步子越缩越小,loss还高着就走不动了。RMSProp稳步降到$O(1)$,Adam到$10^{-2}$量级,AdamW再快一个数量级到$10^{-3}$——在最小值恰为原点的二次型上,权重衰减额外帮了一把。
右图(步长)$|\Delta w|$才是根因。AdaGrad的步长从$0.09$单调衰减到$0.009$——$v$只增不减,分母越来越大,但loss还高着就先停步了,这正是上文”步幅衰竭”的具象。RMSProp的步长不再坍缩:$v$的滑动平均稳住后,步长维持在一个稳定水平,能持续下降。Adam的步长开局最大(一阶矩$m_t$的累积放大到$0.23$),随后随收敛自然减小;AdamW的步长与Adam相仿,但末期掉得更快——权重衰减的$(1-\eta\lambda)$因子多踩了一脚刹车。不过要注意:本题最小值恰在原点,权重衰减只是锦上添花;AdamW的真正价值——让权重衰减不被$\sqrt{\hat v}$扭曲——在带L2正则、最小值不在原点的真实训练里才显现,这正是上一段”解耦”的用意。四法的差距,归根到底是$v_t$的统计方式与权重衰减的施加方式:累加 vs 滑动平均 vs 滑动平均$+$动量 vs 滑动平均$+$动量$+$解耦衰减——一字之差,两个数量级。
Lion:程序搜出来的极简主义
2023年,Google Brain的研究者换了个思路:不再人肉设计优化器,而是把它当超参数,在算法空间里用进化搜索自动挖——挖出来的算法叫Lion(EvoLved Sign Momentum,Chen et al., 2023, arXiv:2302.06675)。它的更新规则极简:只维护一个动量缓冲、更新方向只取符号:
两个缓冲变一个,优化器显存直接减半;sign把每一步的幅度钉成$\pm1$,等于无条件相信方向、彻底放弃幅度信息。代价也在这一锤子里:要与AdamW的更新尺度对齐,学习率得缩小约10倍、权重衰减相应放大10倍,否则一律等长的步子会把模型踹得太狠。
为什么”只留符号”反而是价值?苏剑林在他那篇流传很广的Muon赏析里给过一个直觉:梯度小的坐标未必不重要,可能只是恰好没初始化好或刚路过高曲率区。逐元素缩放(Adam)会让这些坐标一直趴着,sign则一视同仁地给每个坐标同等的力度,给它们”复活力”乃至”再创辉煌”的机会。当然,若是某个坐标的梯度长期都小,那它大概率真的不重要——sign只是在两类错误之间重新做了取舍。
把这几节串起来看,一个清晰的对仗就出现了:Adam在向量(逐元素)层面做归一化,Lion把同一件事推到极致(只留符号);那么矩阵层面的”sign”是什么?——把所有奇异值压平到1、只保留方向结构的正交化。这正是下一节矩阵优化器的主角Muon的答案。回到引言的主线:sign之于向量,恰如正交化之于矩阵。
看图说话:为什么需要预条件
讲了半天条件数$\kappa$,不如让四代优化器在同一条峡谷里赛跑一圈。取最简单的病态二次型$f(x,y)=\frac12(\lambda_1 x^2+\lambda_2 y^2)$,令$\lambda_1=40$、$\lambda_2=1$——等高线是竖立的狭长椭圆,沿$x$是陡峭山壁、沿$y$是平缓谷底,条件数$\kappa=40$。四个选手从同一点出发:裸SGD、SGD+动量、对角自适应的Adam,以及”按$1/\sqrt v$预条件”的对角预条件法(Shampoo家族在轴对齐情形下的退化版)。代码很短:
import numpy as np |
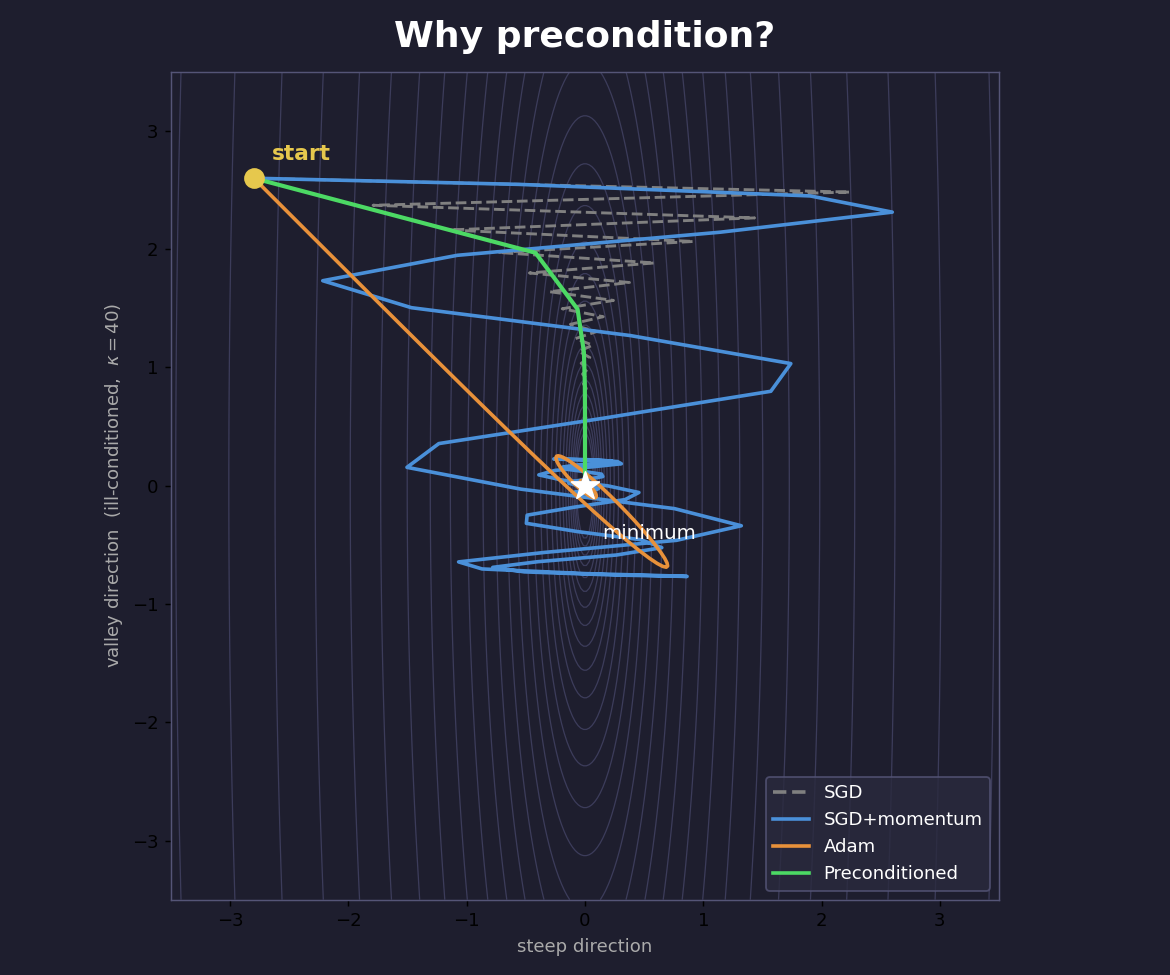
读图:
SGD(灰虚线)在$x$方向剧烈锯齿——$\eta=0.045$逼近临界值$2/\lambda_1=0.05$,$(1-\eta\lambda_1)\to-1$符号逐轮翻转,于是左右来回横跳;沿$y$方向却因$\eta\lambda_2=0.045$极小而龟速爬行。120步仅把损失压到$6\times10^{-5}$。
SGD+动量(蓝)的锯齿被惯性抹平了一些,但$\eta\lambda_1=0.8$仍在大步震荡;好在一致方向上的累积放大让它最终 loss 反而最低($1.4\times10^{-5}$)——干净二次型上heavy-ball的$O(\sqrt\kappa)$优势在这里兑现了。
Adam(橙)走的是最直的线——对角预条件把$x$方向的狂躁治好了。但”除以$\sqrt v$”也给一致的下降方向踩了刹车:120步末态 loss $3.8\times10^{-4}$,反而不及动量法。这不是Adam的失败,而是它的定位——在噪声浓重、曲率未知的真实训练里,”稳”比”快”值钱,下一节加上梯度噪声的五强实验就会看到Adam反超。
预条件(绿)最快:30步就把 loss 压到$2\times10^{-7}$。注意它前10步是”预热”——预条件子$v$得先累积几步梯度才能估准曲率,这正是后文warmup公案的伏笔;$v$一旦校准,更新方向几乎就是牛顿步。
这张图把本文的核心论点一张说尽:梯度方向不是问题,步长沿各方向如何分配才是。SGD/Momentum只调”方向×标量”,Adam调”方向×逐元素标量”,预条件法调”方向×矩阵”。后者几何信息最丰富,所以最快——代价是得维护和估计那个矩阵。下一节就正式走进矩阵预条件器的世界。
矩阵优化器:Shampoo、SOAP与Muon
丢弃的信息到底值多少?看看神经网络参数长什么样就知道了。线性层的权重天然是一个矩阵$W\in\mathbb{R}^{m\times n}$,输入维度与输出维度之间存在结构性关联;而Adam把$\mathrm{vec}(W)$当成$mn$个互不相干的标量。完整的预条件子本该是$mn\times mn$的庞然大物,唯一的出路是找有结构的近似——假设它可分解为分别管辖参数矩阵行空间与列空间的两个小矩阵的Kronecker积:
Kronecker积的妙处在于两条代数恒等式:$(R\otimes L)^{-1}=R^{-1}\otimes L^{-1}$,以及$\mathrm{vec}(AXB)=(B^{\mathsf T}\otimes A)\,\mathrm{vec}(X)$。两式联立,巨型预条件更新立刻坍缩成一次优雅的”三明治”乘法:
存储从$O(m^2n^2)$骤降到$O(m^2+n^2)$,求逆变成两次小矩阵运算。一般化地写出来,就是本文反复出现的核心更新式:
这条思路下诞生了一整族矩阵优化器,本文的三位主角都在其中:
Shampoo(Gupta et al., 2018, arXiv:1802.09568)是这条路线的鼻祖。它用历史梯度外积的累积量估计左右预条件子:
并取$p=1/4$而非直觉上的$1/2$——这来自Shampoo对随机最小二乘类问题的理论分析:累积协方差正比于Fisher信息矩阵,其四分之一次幂恰好给出期望意义下最优的白化。数学上漂亮,工程上头疼:累积、周期性求逆、特征分解的维护样样都是负担,这让它沉寂了好几年,直到2023年的分布式PyTorch实现(arXiv:2309.06497)问世才重新翻红,并一举拿下AlgoPerf——迄今最严肃的独立训练算法对比基准——外部调优赛道的首名(详情见后文”独立基准的真实账”)。
观念的转折出现在2024年:Bernstein和Newhouse指出,如果干脆不做累积、直接取$p=1/2$,Shampoo型的更新恰好等价于如下投影问题的解:
即把梯度矩阵替换为Frobenius范数下最近的半正交矩阵。由SVD理论,设$G=U\Sigma V^{\mathsf T}$,则解为$O^\ast=UV^{\mathsf T}$:所有奇异值被拉平为1,而承载方向信息的奇异向量原封不动。翻译成人话:与其纠结每步走多远,不如规定每步都走同样远的距离——只信任梯度的方向结构,剥掉不可靠的幅值信息。这条”投影线”稍后由Muon兑现;而”预条件线”先迎来了它的集大成者。
SOAP(Vyas et al., 2024, arXiv:2409.11321)从另一个角度切入。写出左右预条件子的特征分解$L=Q_L\Lambda_LQ_L^{\mathsf T}$、$R=Q_R\Lambda_RQ_R^{\mathsf T}$,把参数与梯度都旋转到特征基里:
在这个坐标系里,Shampoo的更新变成$\Lambda_L^{-p}G’\Lambda_R^{-p}$——一个纯粹的对角缩放。也就是说,论文作者的观察可以总结为:Shampoo等价于在特征空间里运行Adafactor(一种只用行/列低秩统计量的廉价自适应方法)。SOAP顺理成章地推进一步:既然到了特征空间,何不把Adafactor换成更强的AdamW?具体做法是在特征基里维护$G’$的逐元素动量与平方滑动平均,跑一套完整的AdamW得到$U’$,再旋转回原空间:
一句话总结:Adam的自适应 + Shampoo的二阶几何。特征基每隔若干步重算一次,动量统计随之迁移;由于真实网络的梯度分布确实带有稳定的几何结构,SOAP等于把Shampoo的二阶几何免费打包进了Adam的自适应框架里。论文在660M参数的语言模型上报告,相对调好的AdamW迭代数减少约40%、wall-clock时间约35%。顺便替化学读者排个雷:此SOAP非彼SOAP——它与GAP势里的Smooth Overlap of Atomic Positions描述符毫无关系,纯粹是Shampoo(洗发水)梗的自然延伸:洗完头发,总得抹点肥皂。
Muon(Jordan et al., 2024, arXiv:2402.18463)兑现的是那一条”投影线”,也把Lion”幅度统一”的直觉搬进了矩阵世界:Lion对向量取符号,矩阵版的”sign”自然就是把奇异值全部归一为1的半正交化,
实现上先对梯度做Nesterov动量得到$M_t$,再用Newton–Schulz迭代逼近$UV^{\mathsf T}$。后者是一个精巧的多项式迭代,不依赖特征分解、只含矩阵乘法:
系数$(a,b,c)=(3.4445,\,-4.7750,\,2.0315)$经过精心整定,使每轮迭代都把奇异值向1压缩,五轮之后谱已相当平坦(下一节会亲眼看到),且全程无开方运算,对bf16等低精度算力极其友好。
从范数的视角看,Muon还有一个比”省掉SVD”更本质的身份。考虑约束最速下降:在谱范数球$|\Delta W|_2\le 1$内最小化一阶损失近似$\langle G,\Delta W\rangle_F$。由对偶范数关系(谱范数的对偶是核范数$|G|_*=\sum_i\sigma_i(G)$),最优解恰好落在$G$的SVD上——设$G=U\Sigma V^{\mathsf T}$,则
作为对照,SGD是在Frobenius球$|\Delta W|_F\le 1$内取最速下降,解为$-G/|G|_F$(归一化梯度)。由于$|\cdot|_2\le|\cdot|_F$恒成立,谱范数球是Frobenius球的子集——约束更紧,方向结构利用更充分,这或许正是Muon在矩阵权重上普遍更稳的深层原因。
关于学习率,还有个容易被讲错的地方值得掰直。裸的正交化动量矩阵逐元素RMS约为$1/\sqrt{\max(m,n)}$——矩阵越大,每个元素摊到的更新越小,不同形状的权重其实”自带不同的有效步幅”。Muon论文补上的那个$\sqrt{\max(m,n)}$缩放,正是在把不同形状拉回同一个有效尺度(更新RMS≈全局$\eta$),而不是什么可有可无的常数——这是它能说”同一份学习率跨层复用”的真正底气;讲究的实践(例如苏剑林介绍过的”把更新RMS对齐到0.2”的Adam超参迁移法)还会对不同形状再做一次精调。理解了这一层,下面病态峡谷里Muon对幅值无感、横跳不落地的表现就不会让人意外了——红利与代价,是同一枚硬币的两面。实战中Muon还有两条铁律:只对2D隐层权重使用,embedding、输出头与一切1D参数继续挂在AdamW上;月之暗面把它推进到1T参数的Kimi K2时,也正是配合权重衰减与逐参数更新缩放在工作,报告的计算效率约为AdamW的两倍。
SOAP-Muon(2026)更进一步,在标准SOAP步骤之后再叠加一步Muon式的正交化,让更新同时享有自适应预条件与谱归一化,是这套思路的集大成者。
代码实验:病态峡谷里的五强争霸
公式看一百遍,不如让五个优化器在同一条峡谷里赛跑一圈。可视化设计有三点考量:其一,把参数空间压到二维,损失函数取主轴相对坐标轴旋转30度、条件数为20的椭圆碗$\mathcal{L}(w)=\frac{1}{2}w^{\mathsf T}Aw$,再叠加高斯噪声模拟mini-batch的随机梯度——麻雀虽小,各向异性、坐标耦合、梯度噪声三个真实训练的核心困难一样不缺;其二,五种优化器共用同一接口(输入梯度、返回更新量)、同一套预热+余弦学习率日程,唯一变量就是更新量的生成方式;其三,除轨迹图外再画一张奇异值谱图,亲眼看Newton–Schulz对梯度做了什么。完整代码如下,numpy即可运行:
import numpy as np |
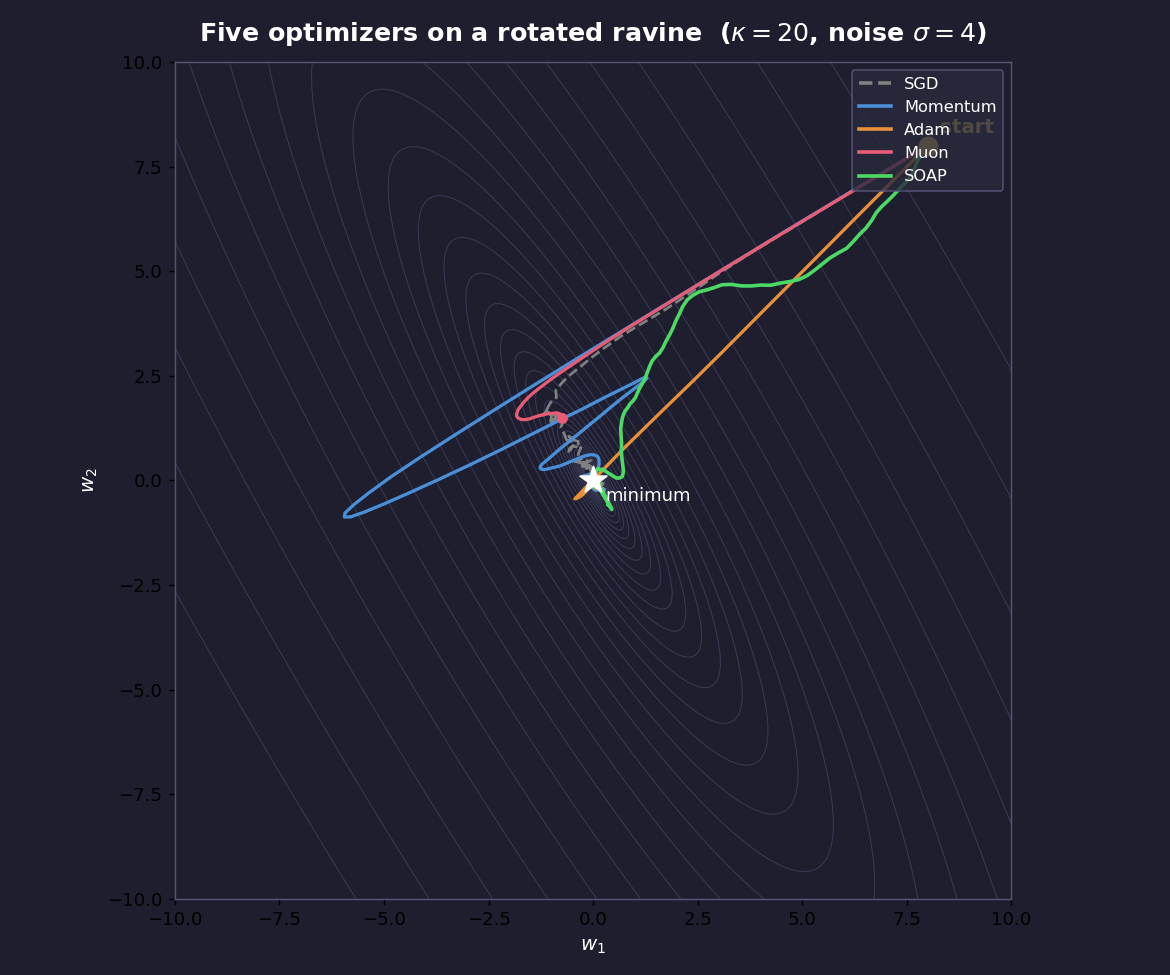
画图部分只剩常规操作:contourf画对数间隔等高线、把每条轨迹叠上去;再构造一张奇异值按幂律衰减、横跨四个数量级的128×64随机矩阵(模拟真实网络梯度的谱),跑一遍newton_schulz后用SVD对比前后奇异值。跑起来之后值得一张一张读:
轨迹图是主角。SGD沿陡峭方向剧烈锯齿、沿谷底龟速爬行——正是前面$O(\kappa)$复杂度的具象化;Momentum的震荡被惯性抹平,但爬行速度只是略有改善;Adam几乎不震荡,径直切向谷底,逐坐标自适应把两个方向的进度解耦了。最有趣的是Muon:步长范数被谱归一化钉死,对梯度幅值完全无感,于是在狭窄谷底反复横跳、迟迟无法减速停靠——谱归一化买来跨张量的稳健性,代价却是单条峡谷内的曲率失明。SOAP先花十几步积累梯度协方差、学出特征基,随后轨迹紧贴谷轴收敛;在这个二维玩具里它并不比Adam快多少——因为$1\times2$的”矩阵”只有一个奇异值,玩具吃不到高维关联结构的红利,真正的战场在下面的水与CDP实验里。
谱压扁图解释Muon的一切:原始梯度矩阵的奇异值横跨四个数量级,五轮Newton–Schulz后被整体压缩到不足两个数量级,多数奇异值聚拢到1附近——梯度被”洗”成了一个近似纯方向。(越小的奇异值恢复得越慢,这正是Muon在实践中只跑五轮、接受近似的工程折衷。)这张图也顺手回答了一个常见疑问:为什么二维情形下Muon看起来就是”归一化梯度下降”?因为一维”矩阵”只有一个奇异值,正交化退化成除以模长;维度越高、谱越宽,谱压扁与逐元素缩放的差异就越大。
损失曲线给出定量注脚:到达$10^{-2}$以下,Adam约50步、SGD约110步、Momentum约200步、SOAP约175步(含基学习期),而Muon在整段训练里横跳不落地——把这个现象记在心里,下一节的实验里它会再次登场。
顺带补一段预热(warmup)的公案。教科书的说法是”让动量统计稳定下来”,但从几何角度看,预热期那几十个小步长还有第二重身份:给SOAP的特征基累积、Muon的动量缓冲这些”几何测量仪器”预留校准窗口。有趣的是,这个效应在二维玩具里根本测不出来——删掉预热重跑,SOAP反而更快(首达173→102步);可一旦把同样的实验搬进十维、条件数200的斜轴峡谷(代码见本专栏Optimizer目录),SOAP立刻还以颜色:无预热时首达步数从377涨到492,Adam却几乎无感(497→445)。几何越复杂,校准越不可省——这与前文”玩具吃不到高维结构红利”恰是同一课的两面。
读者可以自行折腾的扩展:把条件数调到100再看Muon的惨状;去掉坐标旋转对比SOAP与Adam(此时它们几乎重合,因为特征基退化为标准基);或者把这套接口搬进PyTorch的真实训练循环,在loss.backward()之后替换optimizer.step()。
统一视角:预条件的阶梯
回头看,从SGD到SOAP的全部剧情可以用一句话收拢:大家都在近似同一个东西——把更新投进”等曲率”的空间。理想的终点是牛顿步$-H^{-1}\nabla\mathcal{L}(w)$,分歧只在于各自愿意为损失景观的几何付出多大的假设与代价。把这些假设排成一列,就得到一架从简陋到精细的阶梯:
| 阶梯 | 代表 | 有效预条件子 | 几何假设 | 主要代价 |
|---|---|---|---|---|
| 朴素下降 | SGD | $I$(无) | 各方向用统一步长 | 病态地形下$O(\kappa)$收敛 |
| 加惯性 | Momentum | $\approx I$ | 沿历史方向累积,缓解震荡 | 仍感知不到曲率结构 |
| 符号步 | sign/Lion | $\mathrm{diag}(\pm 1)$ | 各坐标最优步长相同 | 丢弃一切幅度信息 |
| 对角自适应 | AdamW | $\mathrm{diag}(\hat v)^{-1/2}$ | 曲率各向异性,且恰好沿坐标轴 | 丢弃轴间耦合 |
| Kronecker矩阵 | Shampoo | $L^{-1/4}\otimes R^{-1/4}$ | 曲率可分解为行×列结构 | 维护两个累积矩阵 |
| 特征基Adam | SOAP | $Q\,\mathrm{diag}(\cdot)\,Q^{\mathsf T}$ | 梯度统计有稳定的特征结构 | 周期性特征分解+矩迁移 |
| 完整二阶 | 牛顿法 | $H^{-1}$ | 不设限(全知) | $d\times d$存储与求逆 |
每上一层,几何刻画更精细,单位参数的内存与计算开销也更贵——天下没有免费的预条件子。实践中真正流行的也不是”选一个”,而是混搭:Muon的官方配方只接管2D隐层权重矩阵,embedding、输出头和所有1D参数仍然挂在AdamW上;”先用AdamW探路、后期切矩阵优化器收敛”的分段调度也有人尝试。优化器正在从单选题变成组合题,而组合的依据,正是每一层参数所处的几何。放到LLM业的2026年现状:默认仍是AdamW,前沿大模型(Kimi K2、GLM-4.5等)把Muon作为2D权重上的混合替换标配,SOAP与Shampoo则在”想要二阶加速又怕Muon太激进”的场景里找到自己的位置。
冷静一下:独立基准的真实账
纸面上的几何故事讲得越漂亮,越需要跟现实对账。2026年7月,Qminers量化团队的reading group用七篇论文加一篇博客复盘了这个领域(见文末参考),结论扎心而坦诚:当矩阵优化器对阵认真调过的AdamW,整体加速通常只有1.1–1.4倍,远达不到原论文动辄宣称的2倍——那些漂亮的数字大多来自没有认真调优的弱基线。具体地:
- 红利随规模收缩:520M参数以下约1.3×,到了1.2B参数、以8× Chinchilla数据配比训练时,只剩约1.1×;
- 早期损失曲线会骗人:优化器排名在衰减段可能整个翻转,拿中间checkpoint判高下不可靠;
- 超参不跨优化器通用:这让几乎所有已发表的跨优化器对比都”结构性不公平”。
但同一篇复现也留下一个非常实用的细节:最优选择随数据-模型配比移动——1× Chinchilla附近Muon占优,8×及以上由Kron与SOAP接管。”谁更快”不是常数,而是山的形状的函数——这恰好就是本文从头到尾的几何观。
顺带交代两件背景。其一,Shampoo的翻红不是情怀:2023年的分布式PyTorch实现(arXiv:2309.06497)让它拿下AlgoPerf——迄今最严肃的独立训练算法对比基准——外部调优赛道的首名,是矩阵预条件阵营少有的硬核第三方背书。其二,学习率日程本身也在被挑战:《The Road Less Scheduled》(arXiv:2405.15682)论证,理论上最优学习率应当是常数、最终答案取全部迭代的平均;实践中人见人爱的cosine衰减只是线性衰减的一种粗糙近似,而线性衰减又不过是在模拟迭代平均——作者们甚至直接喊出”stop using cosine”。本文玩具代码沿用预热+余弦只为图省事与惯例,并不代表它是终点。
那么,分子力场这一章的证据就该出场了。值得挑明的是,”Beyond Adam”的实验设计恰好是上述所有批评的反面教材:每个配置做系统的超参搜索、五个随机种子取均值、对比对象是自己认真调过的AdamW。正因为基线扎实,接下来那几个”快4.9倍””提升24%”才谈得上有分量。
成绩单:水与CDP的正面对决
理论讲完,照例看疗效——而且是在上一节那盆冷水的注视之下。”Beyond Adam”的实验设计在一开始就选择了正面迎战此类质疑:不追热点刷通用势榜单,而是选了两个物理上饶有趣味、规模适中的体系——液态水(用 NequIP:等变消息传递的开山之作 建模)和固体酸电解质CsH$_2$PO$_4$(CDP,磷酸二氢铯,质子导体,燃料电池电解质的候选材料,用 Allegro:为十亿原子而生的严格局域等变势 建模)。每个配置都做了系统的超参搜索,五个随机种子报均值。全监督(能量+力)下的测试集MAE:
| 任务 | 优化器 | CDP 能量 [meV/atom] | CDP 力 [meV/Å] | 水 能量 [meV/atom] | 水 力 [meV/Å] |
|---|---|---|---|---|---|
| E+F | AdamW | 0.628 | 32.2 | 0.773 | 25.7 |
| E+F | Muon | 0.581 | 29.6 | 1.53 | 26.6 |
| E+F | SOAP | 0.569 | 29.6 | 0.604 | 20.9 |
| E+F | SOAP-Muon | 0.582 | 27.8 | 0.590 | 21.0 |
三条结论值得咀嚼:
其一,矩阵优化器全面占优。CDP上三位挑战者全部击败AdamW:SOAP把能量MAE压低9%,SOAP-Muon把力MAE压低14%。水上SOAP与SOAP-Muon的能量误差降低约24%、力误差降低约19%。
其二,Muon不是万能药。它在CDP上确实有效,但在水上能量MAE不降反升(0.773→1.53),全面劣于AdamW——上一节病态峡谷里那个横跳不落地的Muon,在这里现身说法了:裸的谱归一化在不同体系间稳定性差异很大,而SOAP里的Adam成分恰好能缓解这一点。顺带说明,水上SOAP-Muon的成绩也需要额外调试动量系数才能达到,SOAP则是开箱即用。
其三,精度优势直接兑换成了时间优势。以AdamW所能达到的最优验证力误差为及格线,SOAP在CDP上快4.9倍、在水上快5.8倍抵达同一水平——而且这是wall-clock时间,已经扣掉了矩阵优化器每一步额外的预条件开销。换句话说,epoch层面的加速比只会更大:改善的条件数完全补偿了每步的代价。
稀疏监督下的分水岭
真正拉开差距的是稀疏力监督实验,这也是这篇文章对力场领域最有想象空间的部分。
先交代背景。在DFT框架下,Hellmann–Feynman定理让力几乎是能量的免费赠品,所以MLIP训练默认能量+力一起喂。可一旦参考数据的理论水平升级到耦合簇(CCSD(T))或扩散蒙特卡洛(DMC),力的计算成本就变得难以承受——在这些场合,energy-only或只保留一小部分力标签才是常态。优化器若能在力标签稀缺时守住精度,就等于为超越DFT精度的高阶参考数据打开了大门。
结果分层非常清晰:
- energy-only训练:CDP上SOAP-Muon把能量/力MAE相对AdamW砍掉47%/60%,水上SOAP砍掉26%/23%。没有力监督时,优化质量直接决定学到的势能面还能不能给出物理上合理的梯度;
- 半量力标签:CDP上只用50%力帧训练的SOAP-Muon,精度追平了用100%力帧训练的AdamW——省下了一半昂贵的标签;
- 极限压力测试(5%力标签):AdamW训出的势函数在MD中灾难性失稳,轨迹几乎立刻发散,O–H径向分布函数完全非物理;SOAP-Muon的轨迹却保持稳定,结构与动力学性质复现AIMD,测得的质子扩散活化能0.42 eV正好落在实验区间0.39–0.43 eV之内。
最后一条值得单独咀嚼:同样的数据、同样的架构,仅仅换一个优化器,产物一个是废品、一个能与实验定量对上。误差表上几个meV的差异,经过MD这个非线性放大器,变成了”可用”与”不可用”的定性之别——这也算是给 通用势的竞技场:MatBench Discovery与OC20 结尾那句”榜单分数不等于实际可用性”补了一个正面注脚:势函数的真正考场在动力学里,而优化器恰恰在那里说了算。
结语
回到系列的叙事线。我们从不变网络讲到等变网络,从专用模型讲到通用基础模型,竞争的主战场一路从架构转向数据。而”Beyond Adam”想说的是:优化器应该成为与架构、数据并列的一等设计轴——它便宜到不用改一行模型代码,又立竿见影到收敛快数倍、精度提升两位数百分比,还能在标签稀缺时雪中送炭。
给实践者的建议很直接:今天就想换,选SOAP,它是所有测试里跨体系最稳健的选择;愿意花心思调参,SOAP-Muon的上限更高;至于裸Muon,至少在力场这件事上请三思。
还需要对齐一次量纲。LLM圈的独立复现通常只报1.1–1.4×的整体加速,而本文报出4.9×、5.8×与两位数的百分比提升,矛盾吗?并不。那份复现自己承认,520M参数以下才是矩阵优化器红利最大的区间,而水与CDP的训练体量恰好落在这里;何况本文衡量的是”抵达同一精度的wall-clock时间”,而非”同epoch的损失差”,前者会放大后期指数级收敛的差距。规模再往上,红利会收敛——但这门课的结论在分子力场这个量级上依然成立。
当然也要说清局限:这项研究只覆盖两个体系、两种等变架构,基础势级别的系统验证仍是空白。但方向已经清晰——当领域的下一个瓶颈从”数据够不够”滑向”标签贵不贵、训练快不快”,被冷落了十年的优化器,终于要走到聚光灯下了。回到那架预条件的阶梯:选优化器,本质上是在为你所相信的损失景观几何买单。分子力场的景观究竟长什么样、哪一级台阶的性价比最高,正是接下来几年值得每个实践者亲手试一试的事。
参考
延伸阅读(博客与行业复盘):
- 不会魔法的小圆:《Muon》——矩阵层面的sign与谱范数视角的分析。anti-entrophic.github.io/posts/10047.html
- Lonae:《优化器的几何学:2026年大模型训练的Lion-2、Muon与Shampoo复兴》。blog.lonae.com/posts/2026-lion-2muon-shampoo-curkzT
- Qminers Reading Group 13:《After 10 years of Adam: what actually trains neural networks faster》。qminers.com/en/blog/after-10-years-of-adam-what-actually-trains-neural-networks-faster
原典与独立基准(按正文出现顺序):
- AdaGrad:Duchi, Hazan & Singer (2011), JMLR 12. jmlr.org/papers/v12/duchi11a.html
- Adam:Kingma & Ba (2015). arXiv:1412.6980
- AdamW:Loshchilov & Hutter (2019). arXiv:1711.05101
- Lion:Chen et al., 2023. arXiv:2302.06675
- Muon:Jordan et al., 2024. arXiv:2402.18463、作者博客kellerjordan.github.io/posts/muon
- Shampoo:Gupta, Koren & Singer, 2018. arXiv:1802.09568;分布式实现arXiv:2309.06497
- SOAP:Vyas et al. (2024). arXiv:2409.11321
- Fantastic Pretraining Optimizers and Where to Find Them. arXiv:2509.02046
- The Road Less Scheduled. arXiv:2405.15682
- Beyond Adam(本文主题):Harari et al. (2026). arXiv:2607.02499




