
调度器:学习率的时间表
- 引言:学习率不只是个常数
- 为什么常数学习率不够
- 经典调度族:从阶梯到余弦
- Warmup:给几何仪器留校准时间
- 余弦退火的 folk theory 与真相
- The Road Less Scheduled:线性衰减 = 迭代平均
- Schedule-Free:不排时间表的自由
- 调度器与优化器的耦合
- 代码实验:同一条峡谷,七张时间表
- 结语
- 参考
引言:学习率不只是个常数
优化器:从SGD、AdamW到Muon与SOAP 把优化器从 SGD 一路讲到 SOAP-Muon,但有个配角始终隐身——学习率 $\eta$ 本身在训练过程中怎么变。如果说优化器决定"往哪走",调度器决定的就是"走多猛"。再好的优化器配上一成不变的步幅,也会在训练后期撞上噪声地板、或者在前期的病态峡谷里爬行如龟。 深度学习实践者对调度器的态度很微妙:一方面,几乎所有公开的训练配方(MLIP 也不例外)都用预热 + 余弦退火,俨然标配;另一方面,很少有人追问"为什么是余弦"。2024 年的一篇综述(*Learning-Rate Scheduling for Neural Network Training: A Scoping Review*)系统梳理了这个领域五花八门的调度族;紧接着,*The Road Less Scheduled*(arXiv:2405.15682)从理论侧扔出一记重拳——你们奉为圭臬的余弦退火,不过是线性衰减的粗糙近似,而线性衰减本身又不过是迭代平均的替身。 本章接续优化器一节,把学习率的时间表单独拎出来讲透:有哪些调度族、各自在什么场景下管用、余弦为什么好(以及为什么没那么神圣)、以及不排时间表的 schedule-free 方法是否真的是未来。 # 为什么常数学习率不够 训练一个网络,本质是两段式运动:**前半程探索**(大步快走,找到正确的下降方向与 basin),**后半程精修**(小步微调,在极小点附近收敛到高精度)。常数学习率天生无法同时服务这两个阶段—— - $\eta$ 太大:前期走得快,但到极小点附近时梯度小、噪声大,每步被噪声推着走,loss 在一个噪声地板上振荡,甚至反弹上升。 - $\eta$ 太小:后期稳定,但前期在病态峡谷里龟速爬行,浪费算力。 常数曲线的反弹不是偶然。在带噪声的二次型上,SGD 或 Adam 的每步更新里都混入了一个 $\eta\sigma$ 量级的噪声项;$\eta$ 不变,这个噪声项就不变,loss 被它在极小点附近反复推搡,形成一个稳态的"噪声地板" $$\text{loss}_{\text{floor}} \;\propto\; \frac{\eta^2 \sigma^2}{\lambda_{\min}}$$ 衰减调度的作用就是把后期的 $\eta$ 压下去——噪声地板随 $\eta^2$ 下降,loss 得以继续走低。这就是为什么几乎所有实际训练都会衰减学习率:不是仪式感,是物理上真有好处。后文的代码实验会直接看到这条地板长什么样。 # 经典调度族:从阶梯到余弦 一张形状图、七种调度,把主流调度族一网打尽: 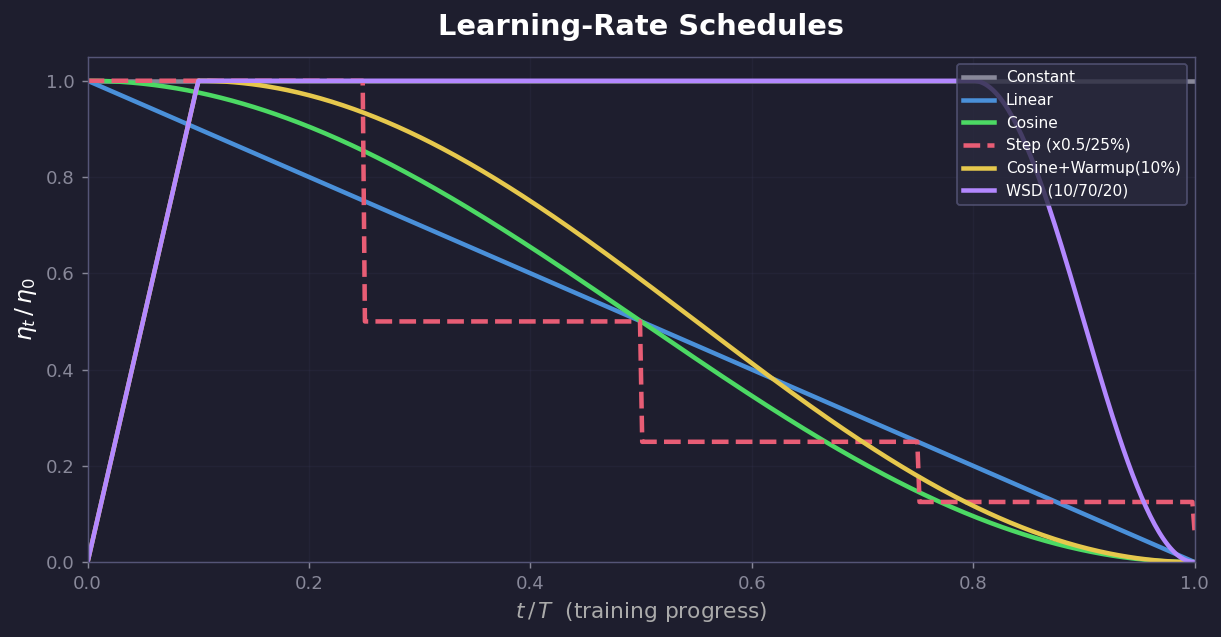 | 调度 | 公式 | 优点 | 缺点 | |------|------|------|------| | 常数 | $\eta_t = \eta_0$ | 简单 | 撞噪声地板 | | 阶梯衰减 | $\eta_t = \eta_0 \gamma^{\lfloor t/s \rfloor}$ | 简单、可控 | 突变处 loss 跳变 | | 线性衰减 | $\eta_t = \eta_0 (1 - t/T)$ | 理论最优(见下文) | 末端骤降为 0 | | 余弦退火 | $\eta_t = \frac{\eta_0}{2}\big(1+\cos\frac{\pi t}{T}\big)$ | 平滑、两端慢 | 浪费末尾几%步 | | 多项式衰减 | $\eta_t = \eta_0 (1-t/T)^p$ | 统一框架($p=1$ 即线性) | $p$ 需调 | | 预热 + 衰减 | 前 $W$ 步线性升 $\to$ 衰减 | 稳住前期统计 | 多一个超参 $W$ | | WSD | 预热 $\to$ 稳定(常数) $\to$ 末尾衰减 | 稳定期全速跑、末尾才压地板 | 衰减段的占比需调 | **WSD**(Warmup-Stable-Decay)是 2024-2025 年 LLM 圈的新秀:前 10% 预热、中间 60-70% 保持常数 lr(稳定期)、末尾 20% 做余弦或线性衰减。它的设计哲学与前几种截然不同——"噪声地板只在末尾需要压低"。稳定期里 lr 不变,loss 在噪声地板上弹跳,但没关系,因为此时模型还在"找路",地板高度不重要;末尾的短衰减把地板一巴掌压下去,快速收获精度。这种"先粗后精"的策略让稳定期的每一步都在全速推进(不像余弦在中段已经开始减速),而衰减期的代价仅占总训练量的 20%。WSD 还有一个实用红利:稳定期就是常数 lr,延长训练只需拉长稳定段、不用重排整个时间表——这一点和 schedule-free 的"不预知 $T$"思路异曲同工。 其中**余弦退火**(Loshchilov & Hutter, 2017)是事实标准:平滑、无突变、两端慢中间快——直觉上像极了"起步热身、中途冲刺、末段减速"。几乎所有 LLM 和 MLIP 的训练配方里都能找到它的身影。但下面两节会说明,它为什么好,以及为什么没那么神圣。 # Warmup:给几何仪器留校准时间 上一章在病态峡谷实验里已经提过 warmup 的几何意义:预热期的小步长是给 SOAP 的特征基累积、Muon 的动量缓冲这些"几何测量仪器"留的校准窗口。这里再补两层更一般的动机: 1. **早期梯度噪声大**。训练前几步,BatchNorm/层归一化的统计量还没稳定,梯度方向往往与最终方向偏差很大。大步走容易冲进参数空间的荒僻角落,warmup 用小步限制这种"早期狂躁"。 2. **二阶矩估计未收敛**。Adam 的 $v_t$ 初始为 0,前几步的 $\hat v_t$ 严重偏小(即使有偏差修正),导致更新步幅被高估。warmup 给 $v_t$ 几十步去收敛到真实梯度方差,之后的全步幅才有意义。 实践中,warmup 长度通常取总步数的 5%–10%。太短起不到校准效果;太长浪费宝贵的训练预算。在 MLIP 训练里(通常几百到几千 epoch),10% 预热 + 余弦退火是最常见的配方。 # 余弦退火的 folk theory 与真相 余弦退火为什么好?社区里流传几版"folk theory": - "平滑无突变"——不像阶梯衰减在跳变处 loss 突然抖一下。 - "两端慢、中间快"——开头慢慢加速(类似 warmup),结尾慢慢减速(类似 annealing)。 - "经验上就是好用"。 这些都对,但都没说到根子上。2024 年的 *The Road Less Scheduled* 给出了一个更深的解释——它不把余弦当主角,而是拿它和线性衰减对照。 # The Road Less Scheduled:线性衰减 = 迭代平均 凸优化理论里有个经典结论(Polyak-Ruppert, 1992):在随机凸优化中,**常数学习率 + 取全部迭代点平均**是最优策略——收敛速率可达 $O(1/\sqrt{t})$,且不需要知道总步数 $T$。但实践中没人愿意"取平均"(存储和计算都贵),大家直接保留最后一个迭代点。 *The Road Less Scheduled* 的核心洞察是:**线性衰减 $\eta_t = \eta_0(1 - t/T)$ 恰好等价于把迭代平均"隐式地"编入了最后一步**。推导的关键在于,线性衰减让早期迭代的权重自然衰减、近期迭代权重增大——这恰好是迭代平均会做的事。于是: $$\boxed{\text{常数}\eta + \text{迭代平均} \;\approx\; \text{线性衰减}\,\eta_t \;\approx\; \text{余弦退火}}$$ 余弦只是线性衰减的一个更平滑的近似——它在两端更慢、中段更快,但整体形状接近直线。这也解释了为什么后文的 loss 图里,线性与余弦几乎重合:它们在做的就是同一件事。 但余弦有一个浪费:末尾几%的步数 $\eta$ 已经接近 0,几乎不更新——这几步的计算等于白烧。线性衰减则到最后一刻 $\eta$ 才归零,不浪费。所以从理论上说,线性比余弦"更划算"。 # Schedule-Free:不排时间表的自由 *The Road Less Scheduled* 不只是做了理论分析,还提出了一个实用的 **schedule-free** 方法。它的理论基础是两种**迭代平均**策略——理解了它们,就理解了 Schedule-Free 的全部。 ## 两种平均策略 **Uniform 平均**(Polyak-Ruppert,Polyak & Juditsky, 1992):用常数 $\eta$ 跑 SGD,取所有迭代点的算术平均 $$\bar{w}_T = \frac{1}{T}\sum_{t=1}^{T} w_t, \qquad \text{在线更新:}\;\bar{w}_{t+1} = \bar{w}_t + \frac{1}{t+1}(w_{t+1} - \bar{w}_t)$$ 所有迭代等权——理论最优 $O(1/\sqrt{T})$ 速率,与衰减调度相同,但不需要知道 $T$。缺陷是早期迭代远离极小点,拖累平均("热身慢"),且需要显式维护累加器。 **EMA 平均**(指数滑动平均):给旧迭代指数衰减的权重,只维护一个滑动状态 $$x_t = \text{decay}\cdot x_{t-1} + (1-\text{decay})\cdot z_t$$ 有效窗口 $k = 1/(1-\text{decay})$,旧迭代以 $\text{decay}^s$ 衰减——渐近速率与 uniform 相同,但热身更快(指数衰减自然丢弃早期坏点)。*The Road Less Scheduled* 证明两者渐近等价:linear decay $\eta_t = \eta_0(1-t/T)$ 隐式编入 uniform 平均,而 EMA 是它的指数近似——这也是上节等价链 $$\boxed{\text{常数}\,\eta + \text{迭代平均} \;\approx\; \text{线性衰减}\,\eta_t \;\approx\; \text{余弦退火}}$$ 的由来。 ## 三序列框架 Schedule-Free 的实际实现维护三个序列,由两个独立参数控制: | 序列 | 角色 | 更新方式 | |---|---|---| | $z_t$ | 快迭代 | 内层优化器(AdamW),常数 $\eta$ | | $x_t$ | 慢输出 | EMA 或 uniform 平均 of $z_t$ | | $y_t$ | 梯度评估点 | $y_t = (1-\beta)\,z_t + \beta\,x_t$(插值) | 两个旋钮控制完全不同的物理量: - **$\beta$(插值系数)**:梯度在 $z$(准但快)和 $x$(稳但慢)之间的位置。**SNR 驱动**——大数据集每步噪声低,$z$ 附近的梯度已经够准,不必退到 $x$ 去算 → $\beta$ 小($y\approx z$);小数据集噪声大,需要 $x$ 的平滑 → $\beta$ 大。经验值:百万级数据集 $\beta\approx0.95$,小数据集 $\beta\approx0.99$。 - **decay(EMA 系数)**:$x$ 的窗口长度 $k=1/(1-\text{decay})$。**训练长度 + 样本独立性驱动**——大数据集步数多、每步采到新数据(独立),长窗口的每一格都是有效样本 → decay 大;小数据集步数少、数据很快重复(相关),长窗口的边际收益递减 → decay 小。经验法则:窗口取总步数的 1–5%。 除 EMA 外,代码还支持 **LR 加权 uniform** 分支: $$\text{weight}_t = \frac{\text{lr}_t^{p}}{\sum_{s\le t}\text{lr}_s^{p}}$$ 当 lr 恒定、$p=1$ 时退化为 $\frac{1}{t}$(uniform 平均)。这是 EMA 的"精确版"——不需要选 decay,但需要知道 lr 序列。实践中 EMA 更常用(更简单、自适应更快)。 ## 为什么有效 关键:$\eta$ 从头到尾是常数,不需要知道 $T$,不需要排任何时间表。$z_t$ 全速探索、$x_t$ 慢慢抹平噪声地板、$y_t$ 在两者间取一个"既不太跳也不太慢"的梯度评估点。理论上达到 $O(1/\sqrt{t})$ 速率,实践中: - 可以随时停(不知道 $T$ 也行); - 可以中途续训(不用重排时间表); - 在 AlgoPerf 自调优赛道上拿了第一(Defazio et al., 2024, arXiv:2405.15682)。 后文的代码实验会直接看到 Schedule-Free 的效果:前期因平均需要"热身"而落后,但后期追上甚至超过余弦——因为它一直在全速 $\eta$ 下跑,不像余弦在中段已经开始减速。 这个方法目前在大模型训练里的落地还不多,但它指向的方向——**让调度从"人为设定"变成"算法自动维护"**——很可能代表了下一代训练配方的趋势。作者在演讲里直接放了一页 slide:"stop using cosine." # 调度器与优化器的耦合 调度器不是孤立的:它和优化器的选择耦合得很紧。大致的经验法则: - **SGD/Momentum**:极度依赖衰减。常数 $\eta$ 在病态地形上必然震荡,衰减是把震荡压下去的主要手段。经典 CV 训练(ResNet 时代)的阶梯衰减就是这个逻辑。 - **Adam/AdamW**:中度依赖。自适应缩放 $\hat m/\sqrt{\hat v}$ 已经部分抑制了病态方向,但常数 $\eta$ 在噪声下仍有地板(下文实验所见)。衰减把地板压低。MLIP 训练几乎全用 AdamW + warmup + cosine。 - **Muon**:轻度依赖。谱归一化让有效步长的谱范数恒定,相当于内置了一层"自适应调度"。实践上 Muon 的学习率从训练头到尾变化不大,衰减可以更温和。 - **SOAP**:最不依赖。特征基 + Adam 自适应给了双重保险,理论上是"最不需要调度"的优化器——当然,加上衰减仍然有帮助,只是红利更小。 这也解释了一个观察:越"聪明"的优化器(预条件越强),对调度的依赖越低。优化器和调度器在某种意义上是**替代品**:你用更强的预条件换来了"不那么需要精心排时间表"的自由。这也是 schedule-free 思路的另一种体现——当优化器本身够强时,人为的时间表反而成了多余。 # 代码实验:同一条峡谷,七张时间表 让七种调度在同一条病态峡谷上赛跑。沿用上一章的 $d=20$、$\kappa=400$ 随机旋转二次型,叠加 $\sigma=1$ 的高斯梯度噪声,Adam 优化器跑 2000 步,唯一变量是 $\eta$ 的时间表:import numpy as np |
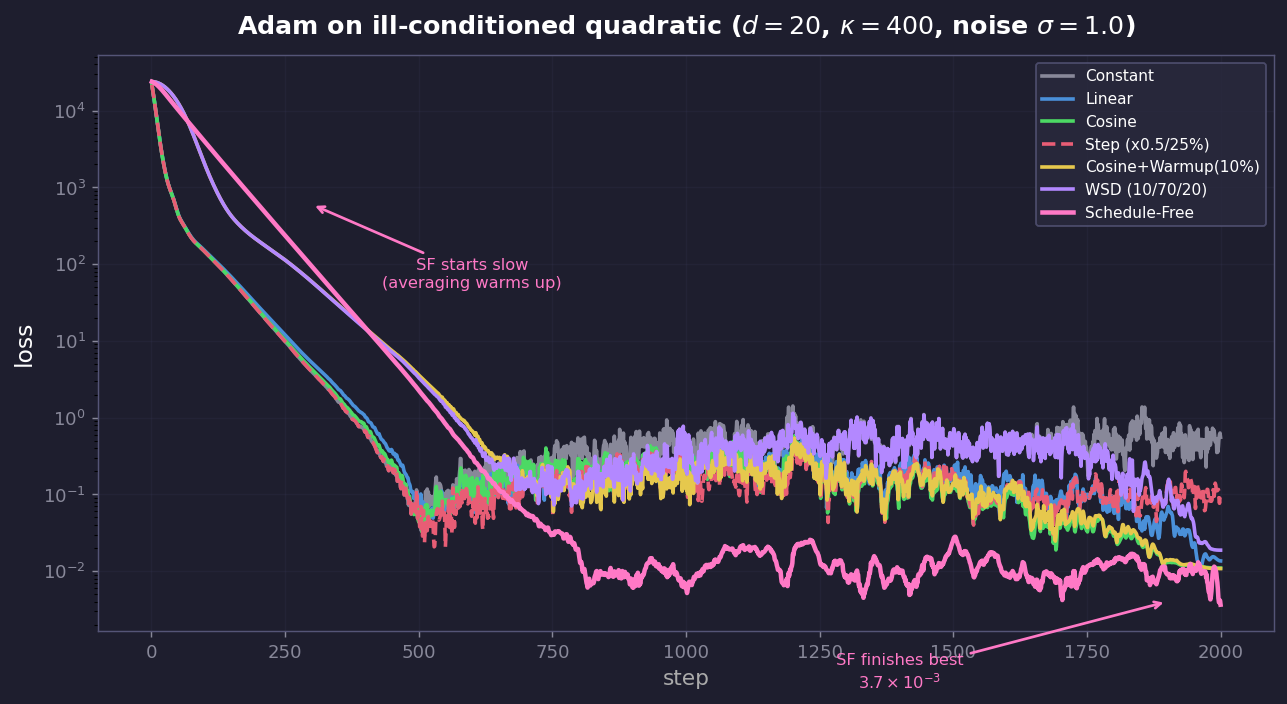
读图分两层:
常数曲线(灰)的故事最值得咀嚼。前 500 步它看起来最好(loss 已到 $10^{-2}$),但随后不降反升——到 2000 步时回到 $10^{-1}$ 量级。这正是上文”噪声地板”的具象:$\eta$ 不变,每步被噪声推动的幅度不变,loss 在地板上随机游走、甚至被推离极小点。其余的则各走各的下坡路,到 2000 步都稳定在 $10^{-2}$ 以下。
线性与余弦几乎重合——这不是巧合,而是 The Road Less Scheduled 预言的直接验证:两者本质上都在做”隐式迭代平均”。余弦那一点额外的平滑度,在 2000 步的尺度上几乎看不出差别。阶梯衰减(红虚线)在每次跌落时 loss 有一个短暂的抖动,但总体趋势与线性/余弦一致。
预热 + 余弦(黄)前期因 warmup 而落后(前 200 步 loss 明显高于无预热的余弦),但后期追平——warmup 的”校准投资”在长跑里回了本。如果训练只跑 500 步(很多 MLIP 训练的实际 epoch 数),warmup 的红利来不及兑现,这也是为什么短训练有时会省去 warmup。
WSD(紫)的曲线最特别。前 80% 它和常数一样在噪声地板上弹跳(稳定期 lr 不变),但最后 20% 的衰减期里,loss 从 $10^{-1}$ 急速俯冲到 $10^{-2}$——和余弦/线性的终值几乎持平。这条曲线把”噪声地板只在末尾需要压低”这句话画成了图:稳定期不花钱压地板(全速跑),衰减期才花钱(短促精修)。如果训练预算紧张、想多跑几个 epoch 再收尾,WSD 的”随时可延长稳定段”特性比余弦灵活得多。
Schedule-Free(粉)的前半程最差——三序列的 EMA 初始值还在起点附近,需要上百步”热身”才追上。但一旦热身完成,它以常数 $\eta$ 全速运行,后期追平甚至超过余弦(终值 $3.7\times10^{-3}$ vs 余弦的 $1.1\times10^{-2}$)。这张图把”常数 $\eta$ + 迭代平均 $\approx$ 衰减调度”的等价链画成了曲线:SF 和余弦终点接近,但走的路完全不同——一个靠衰减压地板,一个靠平均抹地板。
结语
调度器的故事可以收拢成三句话:
- 常数学习率不够:噪声地板是物理事实,衰减把地板压低。
- 余弦 ≈ 线性 ≈ 迭代平均:你用的不是”余弦的魔法”,而是”衰减 + 隐式平均”的工程化封装。
- schedule-free 是方向:当优化器够强、或者算法能自动维护平均时,人为时间表可以被移除——但今天,warmup + cosine 仍是 MLIP 训练最安全的选择。
给实践者的建议:训练 MLIP,用 10% warmup + cosine,配 AdamW 或 SOAP,这是目前性价比最高的配方。如果你用 Muon,可以把 warmup 稍微缩短、衰减更温和。至于 schedule-free:值得关注,但在 MLIP 这个体量上,先等大模型圈替我们趟平路再说。
参考
延伸阅读(论文与综述):
- Polyak, B. T. & Juditsky, A. B. Acceleration of Stochastic Approximation by Averaging. SIAM J. Control Optim., 30(4), 838–855, 1992. — Uniform 迭代平均的经典理论:常数 $\eta$ + 算术平均 $\bar w_T = \frac{1}{T}\sum w_t$ 达 $O(1/\sqrt{T})$。
- Defazio, A., Yang, X. A., Mehta, H., Mishchenko, K., Khaled, A. & Cutkosky, A. The Road Less Scheduled. arXiv:2405.15682, 2024. — EMA 与 uniform 的等价性、三序列 Schedule-Free 算法、AlgoPerf 自调优赛道夺冠。
- Learning-Rate Scheduling for Neural Network Training: A Scoping Review. — 调度族的系统梳理与分类。
- Loshchilov, I. & Hutter, F. SGDR: Stochastic Gradient Descent with Warm Restarts. arXiv:1608.03983, 2017. — 余弦退火与 warm restarts。
- Smith, L. N. & Topin, N. Super-Convergence: A Very Fast Learning Rate Method. arXiv:1708.07120, 2018. — One-cycle 策略。
原典与上文链接:
- 优化器:从SGD、AdamW到Muon与SOAP(上一章:优化器)
- Schedule-Free 官方实现:github.com/facebookresearch/schedule_free
- AlgoPerf 基准:github.com/mlcommons/algorithmic-efficiency




