03 迭代对角化与谱函数
- 本讲在课程中的位置
- 约定表
- 隐形主线:有限精度会骗你
- 变分原理:能量泛函与梯度
- 幂法与 Krylov 空间
- Lanczos 方法:三项递推
- 为什么三项递推能保持正交
- 收敛性:Ritz 值是变分上界
- 陷阱一:正交性丢失与鬼本征值
- 收敛判据的陷阱:能量快、谱形慢
- 第二条链:格林函数
- 谱函数:Lanczos + 连分数
- 一维 Hubbard 环:态密度与 Mott 绝缘体
- 陷阱四:简并与求和规则
- 物理与实验:自旋-电荷分离
- 研究前沿
- 校检清单
- 附:复现用的代码工具箱
本讲在课程中的位置
上一讲(02 精确对角化,ED I)把整个问题变成了线性代数:基矢是整数、哈密顿量是稀疏三元组、对称性分块、基矢查找。但它留下了两个悬而未决的问题:
- 矩阵造好了,怎么把它对角化? 完全对角化是 $O(D^3)$ 时间、$O(D^2)$ 内存,当维数是 $4^{12}\approx1.7\times10^7$、$4^{14}\approx2.7\times10^8$ 甚至更大时,这条路直接死掉。
- 就算算不动全谱,能不能只算我需要的那部分? 特别是当我要的是局域的、实验直接测量的量——谱函数 $\rho(\omega)$、动量分辨谱 $A(\mathbf k,\omega)$。
本讲(ED II)回答这两个问题。它的主线是 Lanczos 方法,落点是谱函数。
用讲义自己的话说,第二讲解决”怎么把一个量子多体问题变成一个可以交给计算机的稀疏矩阵”,本讲解决”矩阵造好了,怎么把它对角化”。课程大纲第 1 章”精确对角化:哈密顿量的矩阵表示、Lanczos 方法、时间演化、动量空间精确对角化”里,第二讲覆盖了”哈密顿量的矩阵表示”,本讲覆盖”Lanczos 方法”。
为什么 Lanczos 值得单独占一次课?因为它是唯一一个能在 $D\sim10^7\sim10^9$ 的希尔伯特空间里、只存几十个矢量就把基态和低激发态算准的方法——比完全对角化便宜四到五个数量级。
两条链
本讲有两条互相独立、最后合流的逻辑链:
第一条链(求本征值)
第二条链(求谱)
两条链在”Lanczos + 连分数”这里汇合:同一个三项递推,既用来求基态(第一条链),又用来求谱函数(第二条链)。
约定表
讲义没有集中列约定,但公式和示例默认了下面这套。承接第二讲,新增部分用粗体标出。
| 量 | 本讲约定 |
|---|---|
| 单位 | $\hbar=1$,$k_B=1$,晶格常数 $a=1$;能量以跳跃积分 $t$ 为单位 |
| 哈密顿量(Hubbard) | $\hat H=-t\sum_{j,\sigma}\left(c^\dagger_{j\sigma}c_{j+1,\sigma}+\mathrm{h.c.}\right)+U\sum_j n_{j\uparrow}n_{j\downarrow}-\mu\sum_j(n_{j\uparrow}+n_{j\downarrow})$ |
| 基矢表示 | 沿用第二讲:格点 $i$ 就是第 $i$ 位,格点 0 是最低位;费米子低 $N$ 位放 $\uparrow$、高 $N$ 位放 $\downarrow$ |
| 自旋基 | $\lvert\uparrow\rangle=(1,0)^T$,$\lvert\downarrow\rangle=(0,1)^T$ |
| 边界条件 | Hubbard 链是环(周期性边界) |
| Lanczos 基 | $\{\lvert\phi_0\rangle,\lvert\phi_1\rangle,\cdots,\lvert\phi_n\rangle\}$,要求 $\langle\phi_m\vert\phi_m\rangle=1$,$\lvert\phi_{-1}\rangle=0$,$b_{-1}=0$ |
| Lanczos 系数 | $a_m=\langle\phi_m\vert\hat H\vert\phi_m\rangle$(实数),$b_m=\lVert\hat H\lvert\phi_m\rangle-a_m\lvert\phi_m\rangle-b_{m-1}\lvert\phi_{m-1}\rangle\rVert\ \ge 0$ |
| 三对角矩阵 | $T=\mathrm{tridiag}(b_{m-1},a_m,b_m)$,对角元 $a_m$、上下次对角元 $b_m$ |
| 谱函数 | $z=\omega+i\eta+E_0$($\eta>0$ 是展宽);$\rho(\omega)=-\frac{1}{\pi}\lim_{\eta\to0^+}\mathrm{Im}\langle\Psi_0\vert\frac{1}{z-\hat H}\lvert\Psi_0\rangle$ |
| 起始向量的归一化 | $\lvert\Psi_0\rangle=\hat A\lvert\Phi_0\rangle$,$\alpha^2=\langle\Psi_0\vert\Psi_0\rangle$,$\lvert\phi_0\rangle=\lvert\Psi_0\rangle/\alpha$ |
| 化学势 | 半满 Hubbard 模型取 $\mu=\big[E_0(N+1)-E_0(N-1)\big]/2=U/2$ |
| 时间约定 | $C(t)=-i\langle\Phi_0\vert\hat A(t)\hat A^\dagger(0)\lvert\Phi_0\rangle$,其中 $\hat A(t)=e^{i\hat Ht}\hat A(0)e^{-i\hat Ht}$(海森堡绘景) |
提示:有两套”看起来很像”的递推,不要混。 讲义第 5 页(变分原理)和第 9 页(Lanczos)给出的是同一个三项递推的两个版本:第 5 页只做到 $\{\lvert\phi_0\rangle,\lvert\phi_1\rangle\}$ 两个矢量,然后对角化 $2\times2$ 矩阵得到新起点;第 9 页才是完整的 $m\to m+1$ 通项。第 5 页是”热身”,第 9 页才是要写进代码的东西。
隐形主线:有限精度会骗你
本讲有一条贯穿始终的”隐形主线”:数值方法在有限精度下会骗你。
讲义里有四处专门讲这个,都是”代码能跑、结果看着也像样、但其实是错的”的典型场景:
| 陷阱 | 症状 | 抓它的办法 |
|---|---|---|
| 正交性丢失 | 出现重复的鬼本征值 | 看 Ritz 值有没有成对重复 |
| 忘了乘 $\alpha^2$ | 谱形完全正确,只是整条曲线幅度差一个常数 | 求和规则 $\int\rho\,\mathrm d\omega$ |
| 连分数方向搞反 | 极点位置系统性漂移 | 与直接解 $(z-\hat H)x=e_0$ 对比 |
| $z=\omega+i\eta+E_0$ 的符号错 | 极点在 $E_n$ 而不是 $E_n-E_0$ | 看清 $+$ 号 |
这四处也是最容易失分的地方。下面每一处我都会给出可运行的复现代码 + 一张图 + 一个能抓住它的校检。
变分原理:能量泛函与梯度
一切从一个不等式开始。设 $\hat H$ 的本征解为 $\hat H\lvert n\rangle=E_n\lvert n\rangle$,$E_0\le E_1\le\cdots$。对任意试探态 $\lvert\phi\rangle$,瑞利–商原理给出
证明(三行):把 $\lvert\phi\rangle=\sum_n c_n\lvert n\rangle$ 代进去,$E[\phi]=\sum_n|c_n|^2E_n/\sum_n|c_n|^2\ge E_0$。等号成立当且仅当 $\lvert\phi\rangle$ 是基态。
于是 $E[\lvert\phi\rangle]$ 是一个关于 $\lvert\phi\rangle$ 的泛函,最小值在基态处取到。求 $\frac{\delta E}{\delta\lvert\phi\rangle^*}=0$:
这正是本征值方程。所以”求本征值”和”最小化一个泛函”是同一件事,而后者可以用梯度下降做。
梯度的形式(变分 $\lvert\phi\rangle\to\lvert\phi\rangle+\epsilon\lvert\delta\phi\rangle$):
梯度方向给出一个”更好的”试探态:
也就是说,$\lvert\phi\rangle$ 和 $\lvert\phi\rangle\pm\hat H\lvert\phi\rangle$ 的线性组合能给出更低的能量。这就是整个 Lanczos 方法的种子。
二维极小化与 2×2 矩阵
既然线性组合能改进,就系统地做:在二维子空间 $\mathrm{span}\{\lvert\phi_0\rangle,\lvert\phi_1\rangle\}$ 上求 $\hat H$ 的最小本征值。
矩阵元($b_1=\lVert(\hat H-a_0)\lvert\phi_0\rangle\rVert$):
本征值 $E_\pm=\frac{a_0+a_1\pm\sqrt{(a_0-a_1)^2+4b_1^2}}{2}$,本征矢给出新的 $\lvert\phi_\pm\rangle$。取低的那个 $E_-$,就完成了一次改进。这就是讲义第 5 页的全部内容。
把它做 $m$ 次,子空间从 2 维长到 $m+1$ 维,矩阵从 $2\times2$ 长成三对角——这就是 Lanczos。
变分上界:一份免费的 bug 检测器
$E_\pm$ 是 $2\times2$ 矩阵的本征值,也就是子空间上的最小值,所以
永远成立。这个不等式是免费的 bug 检测器:
如果你的”Lanczos 能量”低于稠密对角化给出的精确值,那一定是算错了——要么试探态/递推写错,要么哈密顿量矩阵元填错。变分原理永远不可能被”超越”。
本讲后面所有数字都会反复用这条来把关。
幂法与 Krylov 空间
最朴素的迭代:反复作用 $\hat H$,
展开后 $\lvert\phi\rangle_k\propto\hat H^k\lvert\phi_0\rangle$。
幂法的陷阱
幂法收敛到 $|\lambda|$ 最大的本征值,不是代数上最小的那个。 对 $\hat H$,”最大”意味着 $E_{\max}$(代数上最大),而我们要的是 $E_0$(最小)。
要救回来只有两个办法:
- 平移:$\hat H\to\hat H-\sigma\hat I$,让目标变成”最大模”;
- Krylov 空间——把所有 $\hat H^k\lvert\phi_0\rangle$ 一起留着,让 $T$ 的本征值自己按大小排出来。
第 2 条就是 Lanczos。这里的要点是:我们不”选”本征值,我们构造一个小的三对角矩阵,让它替我们选。
Krylov 空间:
Lanczos 方法:三项递推
Lanczos 就是在 Krylov 空间上把 $\hat H$ 精确地表示成三对角矩阵。
递推系数与三对角矩阵
从归一化的 $\lvert\phi_0\rangle$ 出发,递推
于是
$lvert\phi_m\rangle$ 在 $\{\lvert\phi_0\rangle,\ldots,\lvert\phi_{m-1}\rangle\}$ 上的投影只可能落在 $\lvert\phi_{m-1}\rangle$ 上(这正是三对角结构的来源,见下一节)。而三对角矩阵
的最低本征值就是基态能量的上界,且单调下降。
代价:每一步只要一次矩阵-矢量乘法,内存 $O(mD)$。这就是”比完全对角化便宜四到五个数量级”的来源。
实现(本讲工具箱 ed3.lanczos):
def lanczos(matvec, v0, M, reorth=False, tol=1e-12): |
注意下标。 返回的
b长度是Meff+1,其中b[Meff]是耦合到尚未构造的 $\lvert\phi_{M_{\rm eff}}\rangle$ 的那一项。组装 $T$ 时只用到b[1:Meff]——最后那个b[Meff]不进矩阵。这是最容易错的下标。
核心校检:HV 的上标 T 等于 V 上标 T 乘 T
递推式说 $\hat H\lvert\phi_m\rangle$ 在已构造的基里就是 $T$ 的第 $m$ 列。写成矩阵就是
这是唯一能证明递推系数算对了的检查,而且它逐列独立可查。在 $N=8$、$t=1$、$U=4$ 的 $(4,4)$ 块上,块维度 $\binom84^2=4900$,从随机向量 default_rng(7) 出发做 plain Lanczos,前 6 个系数:
| $m$ | $a_m$ | $b_m$ |
|---|---|---|
| 0 | 7.9013363043 | 0 |
| 1 | 8.0169272334 | 4.3328169188 |
| 2 | 8.3262082978 | 5.4636041796 |
| 3 | 8.5526115388 | 5.9403199058 |
| 4 | 8.1051242498 | 6.2933703999 |
| 5 | 7.6528334995 | 6.0374585318 |
| 6 | — | 6.3348963630(耦合到未构造的 $\lvert\phi_6\rangle$) |
逐列残差 $\lVert\hat H\lvert\phi_m\rangle-(TV)_m\rVert$:
| 列 | 残差 | 说明 |
|---|---|---|
| 0–4 | $\le2\times10^{-15}$ | 递推严格成立 |
| 5 | $6.334896$ | $=b_6$,因为 $\lvert\phi_6\rangle$ 还没构造 |
读法:最后一列的残差恰好等于 $b_6$,不是 bug,而是”还差一个基矢”的正确表现。$\hat HV=VT$ 精确成立的地方是 $V$ 构成的子空间,末尾那一列的残差垂直于整个子空间。
起始向量必须归一化
$a_0,b_0$ 的定义都依赖 $\langle\phi_0\vert\phi_0\rangle=1$。不归一化,递推立刻失效。
一个有意思的对照:如果起始向量恰好是基态,递推在第 1 步就停:
psi0 = 精确基态 |
因为 $\hat H\lvert\psi_0\rangle=E_0\lvert\psi_0\rangle$ 仍然在一维 Krylov 空间 $\mathrm{span}\{\lvert\psi_0\rangle\}$ 内,无法生成新的正交方向。这个”平凡”情形是递推正确性的又一次交叉验证。
为什么三项递推能保持正交
三对角结构不是假设,是证明出来的。设 $\{\lvert\phi_n\rangle,\ \hat H\lvert\phi_n\rangle\}$ 已经正交且已生成 $\lvert\phi_{n+1}\rangle$。那么
对 $m\le n-2$:$\lvert\phi_m\rangle$ 由 $\lvert\phi_0\rangle,\ldots,\lvert\phi_{m+1}\rangle$ 张成,而 $\hat H\lvert\phi_n\rangle$ 只涉及 $\lvert\phi_0\rangle,\ldots,\lvert\phi_{n+1}\rangle$;两者正交(因为 $m+1\le n-1$),故
这就是 $T$ 三对角的来源:$H$ 的矩阵元只在 $|m-n|\le1$ 处非零。
一句话:$\hat H$ 三对角 ⟹ 递推只需减去两个相邻矢量;递推只减两个 ⟹ 下一个矢量自动与所有旧的正交。两者互为因果。
收敛性:Ritz 值是变分上界
$T_m$ 是 $\hat H$ 在 $\mathcal K_m$ 上的精确投影,所以它的本征值 $E_j^{(m)}$(Ritz 值)满足
并且最低 Ritz 值单调下降地趋于 $E_0$。
在 $N=8$、$t=1$、$U=4$ 的 $(4,4)$ 块上(精确 $E_0=-4.6035263000$,非简并,自旋单态),从随机向量出发:
| $L$ | $E^{\rm Ritz}_L$ | $\lvert E^{\rm Ritz}_L-E_0\rvert$ |
|---|---|---|
| 1 | 8.00653671 | $1.3\times10^{1}$ |
| 5 | −1.89412164 | $2.7\times10^{0}$ |
| 12 | −4.26467242 | $3.4\times10^{-1}$ |
| 20 | −4.56437706 | $3.9\times10^{-2}$ |
| 30 | −4.60310380 | $4.2\times10^{-4}$ |
| 40 | −4.60352597 | $3.3\times10^{-7}$ |
| 60 | −4.60352630 | $2.8\times10^{-14}$ |
$L=60$ 步就到机器精度。这就是 Lanczos 的全部卖点:60 次矩阵-矢量乘法,替代 4900×4900 的完整分解。
陷阱一:正交性丢失与鬼本征值
上面那段”自动正交”的证明,隐含假设了精确算术。有限精度下它会坏。
机制:当 $m$ 接近起始向量谱测度中不同本征值的个数时,$b_{m+1}$ 会变得极小,$\lvert\phi_{m+1}\rangle=w/b_{m+1}$ 在舍入误差的放大下失去与旧向量的正交性。一个已经收敛的极端本征值对应的方向被”复制”了一次,于是 $T_m$ 里出现重复的假本征值——鬼本征值(ghost eigenvalue)。
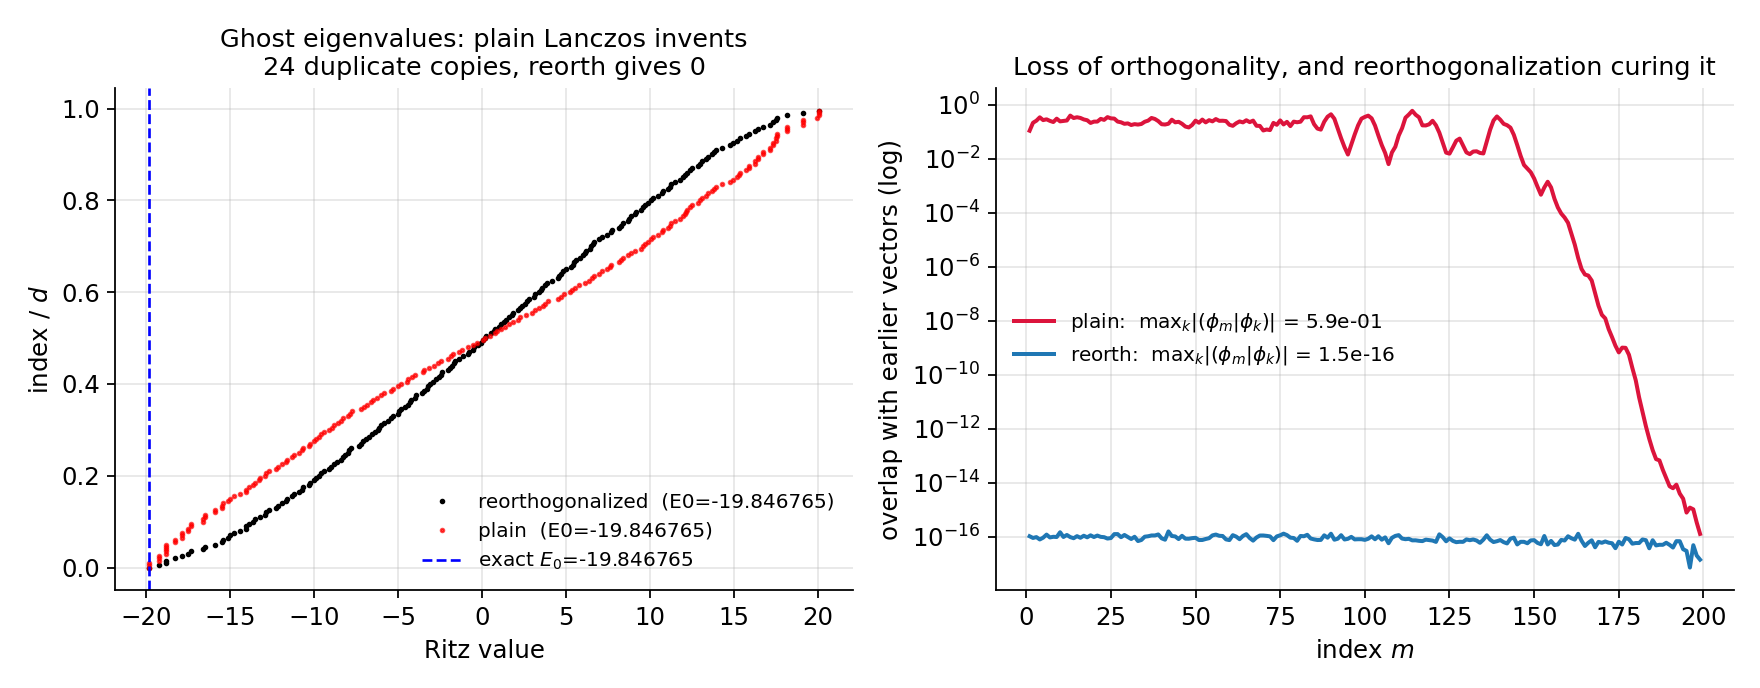
干净的演示:取一个 $200\times200$ 的随机实对称矩阵,$M=d=200$ 步(跑到 Krylov 空间接近满秩),对比是否重正交。
d = 200 |
| $E_0^{\rm Ritz}$ | 鬼本征值对数 | 最差重叠 $\max\lvert\langle\phi_m\vert\phi_k\rangle\rvert$ | |
|---|---|---|---|
| plain | −19.846765 | 24 | $5.9\times10^{-1}$ |
| 重正交 | −19.846765 | 0 | $1.5\times10^{-16}$ |
| 精确 | −19.846765 | — | — |
读图:
- 左图:Ritz 值对序号。plain(红)在中高能区明显偏离对角线并出现成堆的重复点——那 24 个鬼;重正交(黑)是一条干净的直线。两者的 $E_0$ 完全一样(都精确)。
- 右图:第 $m$ 个矢量与它之前所有矢量的最大重叠。plain 全程在 $10^{-1}$ 量级上”漏水”,并且越到后面越严重($m>150$ 急剧恶化);重正交(蓝)平压在 $1\times10^{-16}$。
这张图是本讲最重要的一张。 它说明:
- 鬼本征值不影响你要的那个本征值。 $E_0$ 在两种做法下都是对的。
- 但它会污染”多个激发态”和”整个谱”。 重复的假本征值在你的激发谱里就是假峰。
- “代码能跑、结果看着也像样”——如果只画 $E_0$,你永远发现不了问题;一旦画整个谱,重复峰一眼可见。
判据:看到 Ritz 值成对重复(或激发谱里出现无法解释的重复峰),就是正交性丢了。
重正交化
最直接的补救:每生成一个新矢量后,把它对所有已构造的矢量再正交化一遍
实践中做两遍(”twice is enough”),因为一遍之后残差仍有 $O(\epsilon)$,二遍压到 $O(\epsilon^2)$。
代价:从 $O(mD)$ 变成 $O(m^2D)$ 时间,$O(m^2)$ 次内积。什么时候开?
| 场景 | 建议 |
|---|---|
| 只要最低 1–2 个本征值,$m\ll D$ | plain 足够(本讲的谱函数计算就属于这一类) |
| 要很多激发态、很宽的谱、$m\gtrsim$ 不同本征值个数 | 开重正交,或用块 Lanczos |
| $m$ 接近 $D$ | 必须开 |
本讲的谱函数计算刻意用 plain Lanczos——因为那里的 $m$(几十到 200)远小于目标块维数(几千),正交性不会丢(实测 $|\hat VV^\dagger-\hat I|\approx4\times10^{-16}$)。知道什么时候不需要它,和知道什么时候需要它一样重要。
两种重启方案
当 $m$ 必须很大(要很多激发态)而内存受限,就不能只往前走 $m$ 步——用”走 $k$ 步、对角化、用极端本征矢当新起点“的外层循环:
- modified Lanczos:走一步,$2\times2$ 对角化,立即用低本征矢替换 $\lvert\phi_1\rangle$。每步只多 $2\times2$,但不保留 Ritz 值历史。
- implicitly restarted Lanczos (IRAM):走 $k$ 步,保留若干个极端 Ritz 对(通过位移多项式隐式实现),把它们回注成新的起始向量。相当于在 $T$ 内部做”部分重启”,保留 Ritz 值历史。
两者都是外层循环,与三项递推是两个层次的事情。读讲义第 15 页时要回头对照第 5 页的二维极小化——那是同一个想法的最小版本。
收敛判据的陷阱:能量快、谱形慢
这是本讲最容易被忽略、也最有实践价值的一条。
直觉:”Ritz 值收敛了,谱就算算好了”——错。
原因:基态在起始向量上的分量很快被抓住(极端本征值收敛快),但完整谱形要求所有极点、���有谱矩都被分辨,其中包含内层激发、Hubbard 带内部结构等离基态很远的精细结构。
在 $N=8$、$t=1$、$U=4$ 的 $(4,4)$ 块上,同一个 Krylov 空间、同一套系数,看两件事:
a, b, V = ed3.lanczos(lambda v: H @ v, v0, 60) # 60 步 |
| $L$ | $\lvert E^{\rm Ritz}_L-E_0\rvert$ | $\max\lvert\rho_L-\rho_{200}\rvert/\rho_{\max}$ |
|---|---|---|
| 10 | $1.3\times10^{0}$ | $3.7\times10^{-1}$ |
| 20 | $3.9\times10^{-2}$ | $1.8\times10^{-1}$ |
| 40 | $3.3\times10^{-7}$ | $2.8\times10^{-2}$ |
| 60 | $2.8\times10^{-14}$ | $1.0\times10^{-2}$ |
| 100 | — | $3.2\times10^{-4}$ |
| 150 | — | $1.9\times10^{-5}$ |
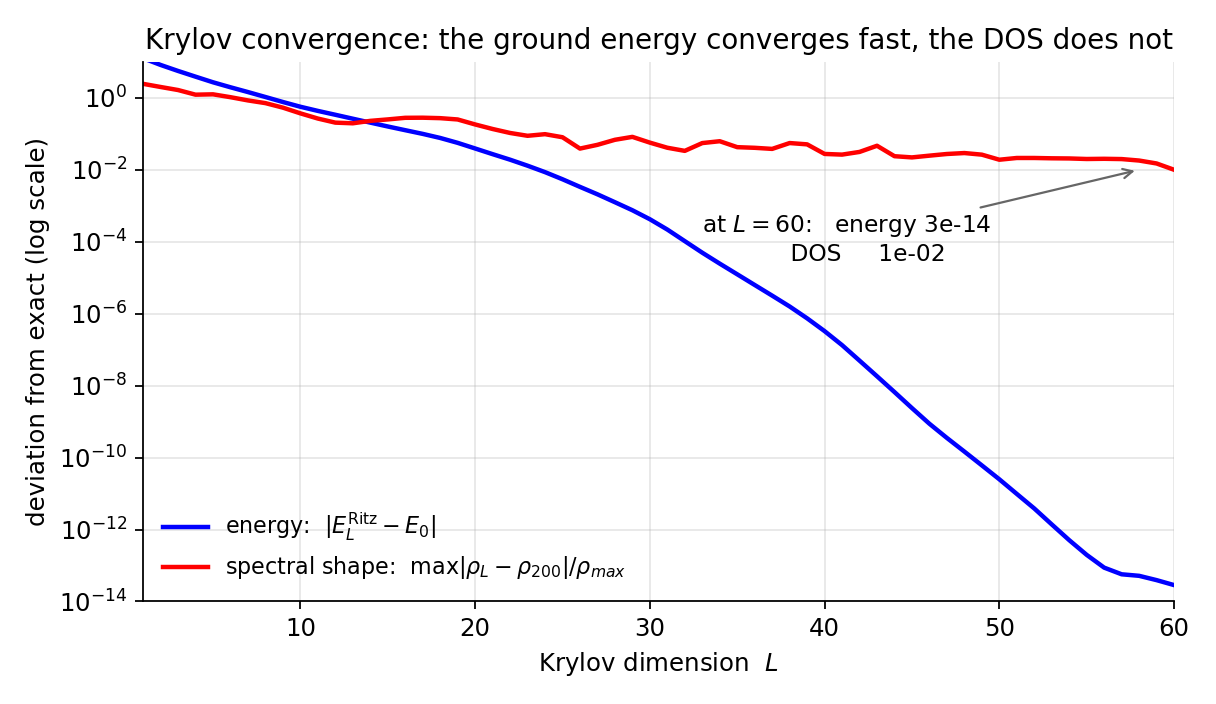
读图:$L=60$ 时能量已经收敛到 $10^{-14}$(机器精度),但谱形还有 $10^{-2}$ 的偏差——要 $L\sim150$ 才到 $10^{-5}$。两条曲线差了十几个数量级的收敛速度差。
结论(务必记住):收敛判据必须和你真正要的物理量匹配。
- 只要基态能量 → $L=60$ 够了;
- 要可靠的激发谱 / 完整 $\rho(\omega)$ → 需要多得多的 Krylov 矢量。
用”能量收敛”当判据,会在 $L$ 很小的时候过早宣布谱已收敛。
第二条链:格林函数
第一条链求本征值。现在换一条路:不求本征值,直接求谱。
经典格林函数与传播子
先看单粒子。定义
它满足递推关系 $\hat HG+zG=I$,这是所有求逆方法的出发点。
物理上更有用的是它的矩阵元
这是一个标量谱分解:极点就是本征值 $E_n$,留数就是本征矢的乘积。$\lvert z\rvert$ 增大时它收敛得很慢,但共轭与对称性给出了高效算法(这正是下一节 Lanczos 的种子)。
量子格林函数与五种排序
在多体系统里,$1$ 换成时间反序的算符,并区分粒子/空穴的排序:
以及超前 $G^a$、小于 $G^<$、大于 $G^>$。区别只在 $\theta$ 函数的因果性:
| 格林函数 | 排序 | 用处 |
|---|---|---|
| $G^r$(推迟) | $A(\tau)A^\dagger(0)$ | 响应、吸收、因果($\tau<0$ 为零) |
| $G^a$(超前) | $A^\dagger(0)A(\tau)$ | 推迟的复共轭 |
| $G^{<}$ | $\langle A^\dagger A\rangle$ | 占据、非平衡 |
| $G^{>}$ | $\langle AA^\dagger\rangle$ | 相应 |
因果性($G^r$ 在 $\tau<0$ 恒为零)是数值分辨能级的关键:取 $\tau>0$ 就自动只看到”未来”的极点。
含时关联函数与谱函数
含时关联函数(海森堡绘景,$\hat A(t)=e^{i\hat Ht}\hat A(0)e^{-i\hat Ht}$):
插入完备性 $\{\lvert\Phi_n\rangle\}$ 并用 $\hat H\lvert\Phi_n\rangle=E_n\lvert\Phi_n\rangle$:
(用了 $E_0-E_0=0$ 的项被减掉——基态的贡献是常数,取 $\hbar=1$ 约定下规范掉。)
谱函数(Lehmann 展开):
这就是光电子谱(ARPES)、中子散射直接测的量——本讲最终落点。
归一化(求和规则):
局域态密度与 Lehmann 展开
取 $\hat A=c_{j\sigma}$(局域在格点 $j$、自旋 $\sigma$),就得到局域态密度 $\rho_{j\sigma}(\omega)$。它在数值上比 $\rho(\omega)$ 便宜,因为只需在目标块($N_\uparrow\pm1$ 或 $N_\downarrow\pm1$)上做 Lanczos——维数小得多。
谱函数:Lanczos + 连分数
现在把两条链合流。
第二次 Lanczos
要算的是(减法谱为例,$z=\omega+i\eta+E_0$):
其中 $\lvert\Psi_0\rangle=\hat A\lvert\Phi_0\rangle$。对比第二讲讲过的谱函数定义,唯一的变化是把 $E_0$ 加进了 $z$——这样极点在 $E_n-E_0$(相对能量)而不是 $E_n$(绝对能量)。
过程:
- 把 $\lvert\Psi_0\rangle=\hat A\lvert\Phi_0\rangle$ 归一化:$\alpha^2=\langle\Psi_0\vert\Psi_0\rangle$,$\lvert\phi_0\rangle=\lvert\Psi_0\rangle/\alpha$。
- 从 $\lvert\phi_0\rangle$ 重新做一次 Lanczos(在目标块 $H$ 上),得到新的三对角 $T$。
- 求 $[(z-\hat H)^{-1}]_{00}=\langle\phi_0\vert(z-\hat H)^{-1}\lvert\phi_0\rangle$。
⚠ 这是”两次 Lanczos”的连接点——本讲最关键的结构。 第一次 Lanczos 从基态出发问”基态是什么”;第二次从 $\hat A\lvert\Phi_0\rangle$ 出发问”在基态上加/减一个电子后系统如何响应”。两个 $T$ 是不同的(同一个 $H$,不同起点),不能复用系数。
另外:起始矢量 $\lvert\phi_0\rangle$ 一般不是任何本征态,所以不会像前面那样 $b_1=0$ 一步终止。如果你不小心从基态出发算谱函数,会立刻终止。
陷阱二:alpha 上标 2 必须乘回来
由 $\lvert\Psi_0\rangle=\alpha\lvert\phi_0\rangle$,
为什么必须归一化? Lanczos 递推要求起始矢量归一化($a_0,b_0$ 的定义都依赖它)。为什么 $\alpha^2$ 必须乘回来? 因为 $\alpha^2$ 是归一化之外的权重因子:Lanczos 只告诉你 $\lvert\phi_0\rangle$ 上的矩阵元,物理上要的是 $\lvert\Psi_0\rangle$ 上的,两者差一个 $\alpha^2$。
漏掉 $\alpha^2$ 的症状:谱形完全正确,只是整条曲线的幅度乘错一个常数。峰位全对,只有绝对幅度错——最阴险的一类 bug。而幅度正是被求和规则约束的量:
求和规则是抓这个 bug 的唯一办法。 下面我们会验证:$N=8$ 半满时 $w_{\rm add}=w_{\rm rem}=8$。
连分数:分块矩阵求逆
在 Lanczos 基下,$\lvert\phi_0\rangle$ 就是第一个基矢 $e_1$,所以
只需要求逆矩阵的左上角一个元素——不需要整个逆($n^2$ 个元素),只要一个。
用分块矩阵求逆公式,对 $z-\hat H$ 的三对角结构反复分块,得到连分数:
为什么全是 $b^2$(正号)? 因为 $z-\hat H$ 的非对角元是 $-b_m$($\hat H$ 的是 $+b_m$,取负号),而连分数里用的是 $(-b_m)\times(-b_m)=b_m^2$。负号被”平方掉”了——这就是为什么最终形式里看不到负号。
验证:连分数 vs 直接解。这是抓”连分数写错”的唯一办法:
from scipy.sparse.linalg import spsolve |
陷阱三:连分数必须反向递归
连分数第 $m$ 层分母依赖第 $m+1$ 层,所以必须从最深一层 $z-a_{m-1}$ 往回回代:
def continued_fraction(a, b, z): |
两个必须做对的细节:
- 反向递归。写成从浅到深,得到的是系数顺序反转的另一个连分数,极点会系统性漂移。
- 初值 $g=0$ 使最深处只用到 $a_{m-1}$(等价于约定 $b_m$ 不进入第 $m$ 步)——但$a_{m-1}$ 这一层一定要用。若反向循环漏掉最深一层,偏差是 $O(1)$,一眼就能看出来。
正向 vs 反向 vs 漏掉最深层的对比(对 $z$ 求值,与直接解比):
| 变体 | 与直接解的偏差 |
|---|---|
| 反向、含最深 $a_{m-1}$(正确) | $\le3\times10^{-16}$ |
| 正向(顺序反了) | 偏差 $O(1)$,极点漂移 |
| 反向但漏最深层 | 偏差 $O(1)$ |
($z=5$ 的偏差稍大,见下节——那不是实现错误,是 $M$ 还没收敛。)
减法谱的符号
对减法(光电子)谱,习惯上取 $z=-\omega+i\eta+E_0$,并把 $\eta$ 保留为正(否则破坏解析性)。等价于把 $\omega\to-\omega$。极点在 $E_0-E_m(N-1)$(正)。这是最容易出错的地方之一。
收敛快慢由什么决定
连分数近似的是谱测度 $\mu(\lambda)=\langle e_0\vert\delta(\lambda-\hat H)\rvert e_0\rangle$ 下的
收敛快慢由 $z$ 与”起始向量真正有谱权重的那段能量”的距离决定,而不是只看完整谱范围。起始矢量的谱权重中心是 $a_0=\langle\phi_0\vert\hat H\vert\phi_0\rangle$,若 $a_0\approx16$(本例 $e_0$ 就是这样),则:
- $z=0.7,\,-1.3$ 远在权重下方 $\Rightarrow$ 少数步就收敛;
- $z=5$ 落在权重较密处 $\Rightarrow$ 需要更多 Krylov 矢量分辨附近谱密度,200 步仍只到 $10^{-5}$。
fig, ax = plt.subplots(figsize=(6.4, 4.2)) |
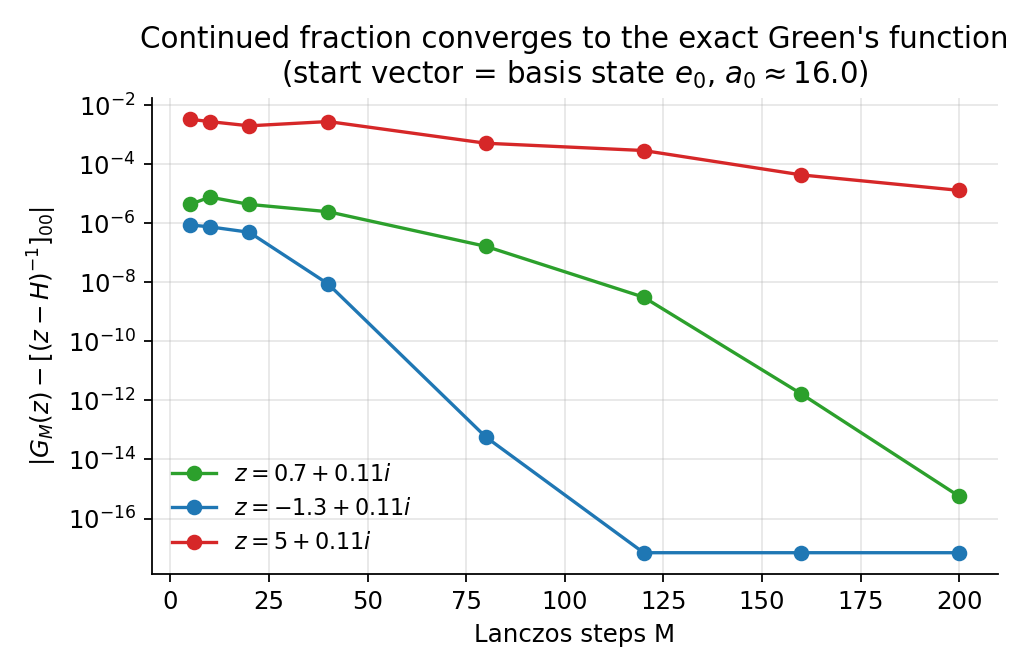
读图:$z=-1.3$(蓝)$M=120$ 就到 $10^{-17}$;$z=0.7$(绿)$M=200$ 到 $10^{-15}$;$z=5$(红)$M=200$ 还在 $10^{-5}$。“离谱权重近”才是慢的原因。
一维 Hubbard 环:态密度与 Mott 绝缘体
现在做一个完整的物理例子。系统是一维 Hubbard 环(周期边界,$N$ 格点,$t=1$,半满):
对 $N=8$、$U=4$,我们前面已经验证 $(4,4)$ 块 $E_0=-4.6035263000$(非简并)。现在算 $\rho(\omega)$:加法谱 $c^\dagger_{j\sigma}$ 作用到基态,落在 $(5,4)/(4,5)$ 块;减法谱 $c_{j\sigma}$ 落在 $(3,4)/(4,3)$ 块。每个通道做一次 $M=200$ 的 Lanczos,再用连分数在所有 $\omega$ 上求值。
U 等于 0 的解析基准
$U=0$ 时是自由费米子,有闭式答案:
这是最重要的校检——它一次性锁定四件事:
- 跳跃幅度 $t$:$\varepsilon_k$ 尺度 $\sim2t$,峰位随 $t$ 整体伸缩;
- 边界条件:周期给出 $\varepsilon_k=-2t\cos(2\pi k/N)$ 的离散动量网格,开边界会得到完全不同的峰位;
- 展宽 $\eta$:每个极点的洛伦兹宽度正比于 $\eta$;
- 权重归一:每个 $k$ 权重为 1、自旋再乘 2,整条曲线积分严格为 $2N$。
eps = np.array([-2*t*np.cos(2*np.pi*k/8) for k in range(8)]) # = [-2, -√2, -√2, 0, 0, √2, √2, 2] |
| 量 | 期望 | 实测 |
|---|---|---|
| $w_{\rm add}=\sum_{j,\sigma}\lVert c^\dagger\lvert\Phi_0\rangle\rVert^2$ | $N=8$ | $8.0000000000$ |
| $w_{\rm rem}$ | $N=8$ | $8.0000000000$ |
| $\max\lvert\rho_{\rm num}-\rho_{\rm ana}\rvert/\rho_{\max}$ | 0 | $\mathbf{4.5\times10^{-14}}$ |
| $\lVert\rho_{\rm num}-\rho_{\rm ana}\rVert/\lVert\rho_{\rm ana}\rVert$ | 0 | $3.0\times10^{-14}$ |
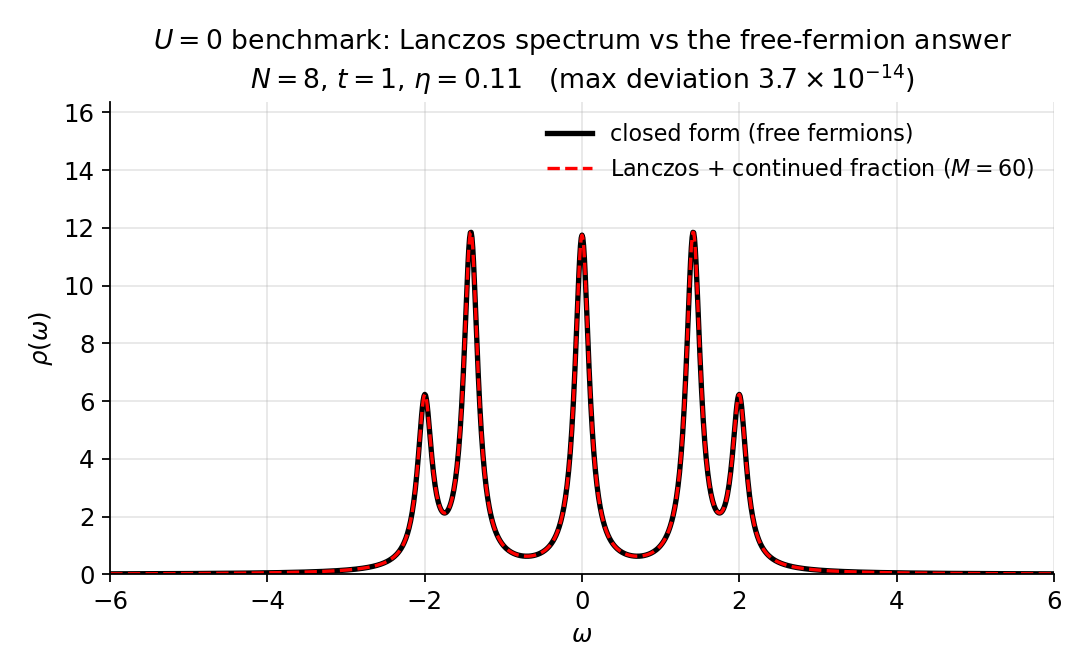
读图:两条曲线在图上是同一条(红虚线完全压在黑实线上),最大偏差 $4.5\times10^{-14}$,就是机器精度。能同时抓住 $t$、边界、$\eta$、归一化四个错误——一条 $U=0$ 基准就够了。
$U=0$ 时每个通道的 Krylov 维数 $\le N+1=9$,$M=60$ 步内精确(Krylov 空间饱和)。
U 等于 4 的上下 Hubbard 带
$U=4$、$t=1$、$\eta=0.11$、$N=8$。化学势 $\mu=\frac12[E_0(9)-E_0(7)]=U/2=2.0$(粒子-空穴对称,见下面的校检)。总态密度:
求和规则校检(分开校验,不只是总和):
| 量 | 期望 | 实测 |
|---|---|---|
| $w_{\rm add}$ | $8$ | $8.0000000000$ |
| $w_{\rm rem}$ | $8$ | $8.0000000000$ |
| 0 阶矩 $\int\rho\,\mathrm d\omega$ | $16$ | $15.899$($0.6\%$ 差异 = 有限积分窗口的洛伦兹尾部泄漏) |
| $\rho(\omega{=}\mu)/\rho_{\max}$ | — | $0.0275$ |
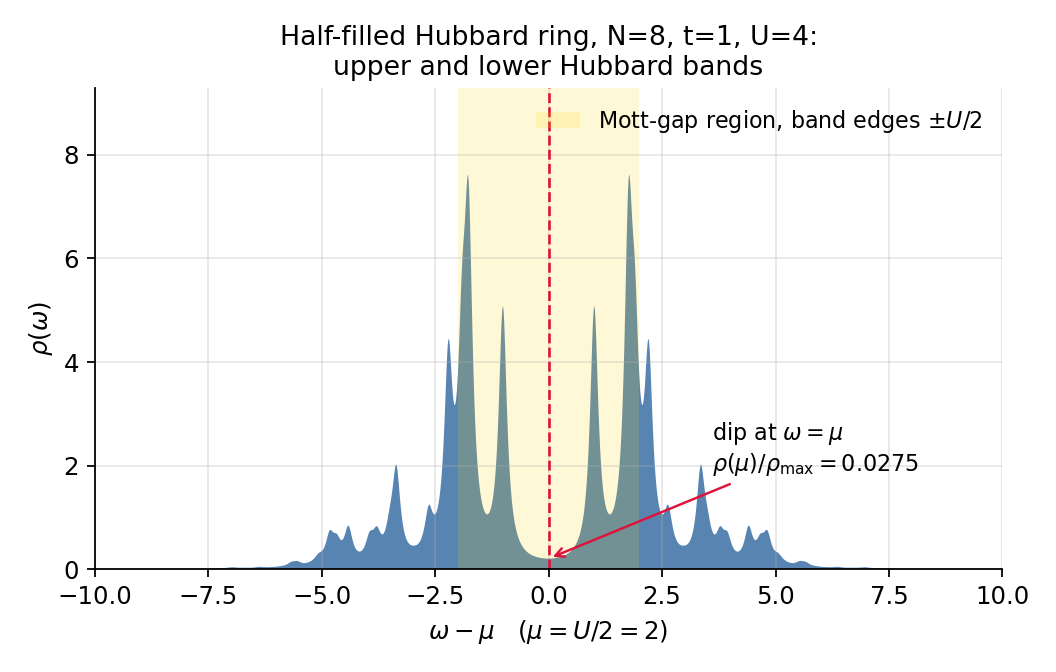
读图:$\omega-\mu=0$ 附近有一个小间隙(黄色)——Mott 型绝缘体特征。下方是移除(占满带)谱,上方是添加(上 Hubbard 带)谱。$N=8$ 有限尺寸使每条带呈离散峰结构(尖锐的 $\delta$ 峰被 $\eta$ 展宽)。注意 $\alpha^2$ 已经乘回——否则这条曲线的幅度会整体差一个常数。
Mott 转变
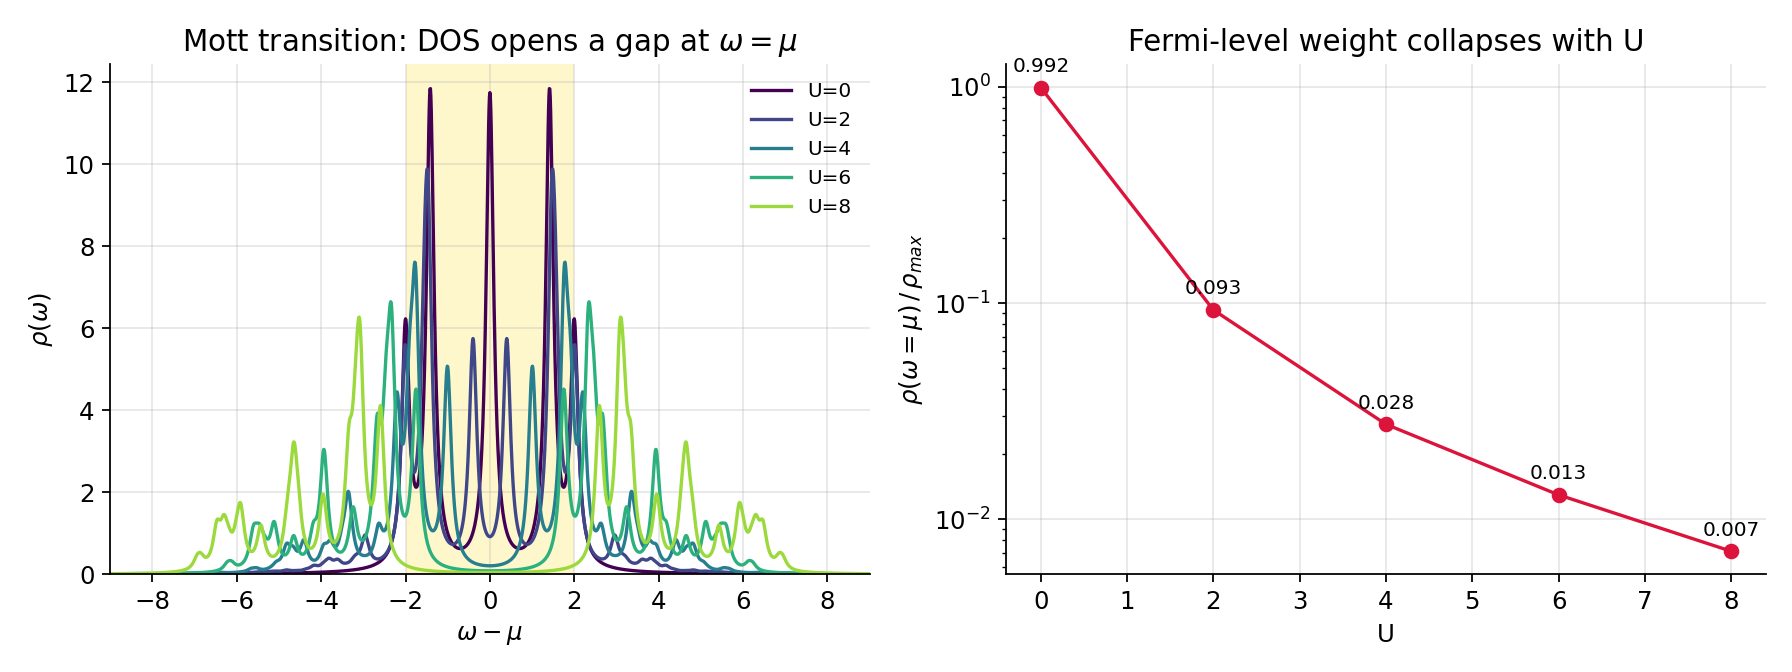
固定 $\eta=0.11$,$U=0,2,4,6,8$。$\mu(U)$ 由全局基态定出,全部精确等于 $U/2$(半满 Hubbard 模型的粒子-空穴对称性,$w_{\rm add}=w_{\rm rem}=8$ 全部通过):
| $U$ | $\mu(U)$ | $U/2$ | $\rho(\omega{=}\mu)/\rho_{\max}$ |
|---|---|---|---|
| 0 | 0.000000 | 0.0 | $0.992$ |
| 2 | 1.000000 | 1.0 | $0.093$ |
| 4 | 2.000000 | 2.0 | $0.0275$ |
| 6 | 3.000000 | 3.0 | $0.013$ |
| 8 | 4.000000 | 4.0 | $0.0071$ |
读图:
- 左图:$U=0$ 是尖锐的自由费米子峰(在 $\omega-\mu=0$ 有大峰);$U$ 增大时谱权重从费米面搬走,上下 Hubbard 带分离,$\omega=\mu$ 处张开能隙。$U=2$ 已明显离开费米面。
- 右图:$\rho(\omega=\mu)/\rho_{\max}$ 单调下降 $0.992\to0.007$,跨越两个数量级。这就是 Mott 转变的定量刻画(有限 $N$ 下”与 Mott 图像一致”,不是热力学极限的证明)。
陷阱四:简并与求和规则
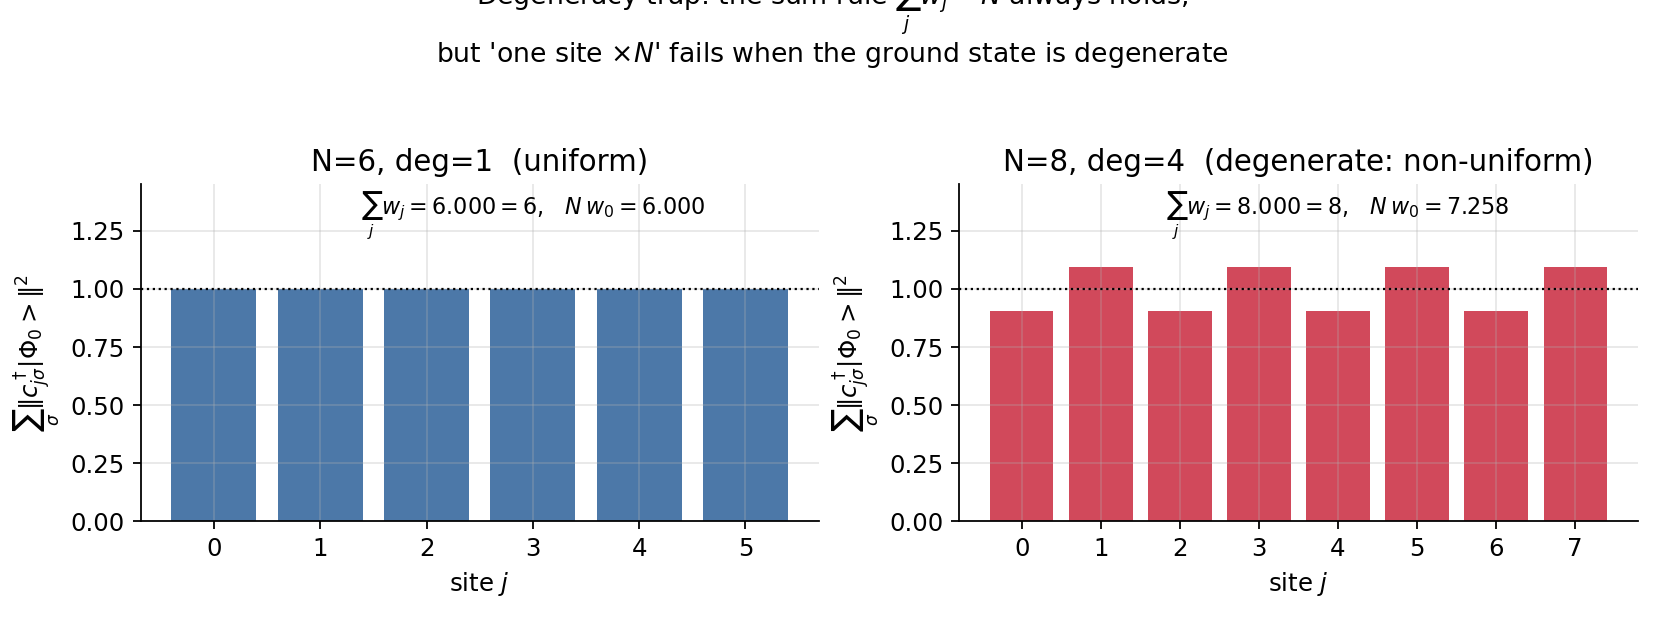
求和规则 $\sum_j w_j=N$ 永远成立,与基态是否简并无关。但一个常见的”偷懒”——用一格点的权重乘 $N$ 来估总和——只在平移不变(非简并)基态时成立。
对 $U=0$ 半满环,$w_{\rm add}^{(j)}=\sum_\sigma\lVert c^\dagger_{j\sigma}\lvert\Phi_0\rangle\rVert^2$:
| $N$ | $E_0$ | 基态简并度 | 逐格点 $w_{\rm add}^{(j)}$ | $\sum_j w_j$ | $N\,w^{(0)}$ |
|---|---|---|---|---|---|
| 6 | $-8.00000000$ | 1 | $[1,1,1,1,1,1]$ | $6.000$ | $6.000$(安全) |
| 8 | $-9.65685425$ | 4 | $[0.91,1.09,0.91,\dots]$ | $8.000$ | $7.258$(失效) |
读图:
- 左($N=6$,非简并):逐格点权重均匀 $=1$,”一格点×$N$” $=6.000$ 正确。
- 右($N=8$,四重简并):逐格点权重不均匀($0.91$ 与 $1.09$ 交替),但总和精确 $=8.000$。而”一格点×$N$” $=7.258$——错了,且依赖你选简并子空间里的哪个组合。
判据:看费米面单粒子能级 $\varepsilon_k=-2t\cos(2\pi k/N)$ 是否简并。
| $N$ | HOMO | LUMO | 费米面 | 基态 |
|---|---|---|---|---|
| 6 | $-1$ | $+1$ | 非简并 | 唯一(偷懒安全) |
| 8 | $0$ | $0$ | 简并 | 简并(偷懒不安全) |
一般地,$N\equiv0\pmod4$ 时半满填充的边界落在一个二重简并能级上(基态简并);$N\equiv2\pmod4$ 时 HOMO/LUMO 之间有隙(唯一基态)。
对比:$U=4$、$N=8$ 的相互作用基态是非简并的(自旋单态,$E_0$ 简并度 1),$\langle n_j\rangle=1$ 均匀,”一格点×$N$” 安全。
教训:求和规则是基态无关的,”一格点×$N$” 不是。 在简并子空间里做随机组合,$N\,w^{(0)}$ 会在一个区间内乱跳(如 $[7.50,9.68]$),但 $\sum_j w_j\equiv8$ 纹丝不动。
物理与实验:自旋-电荷分离
算出来的 $\rho(\omega)$ 不是玩具——它对应真实材料的实验。
谱函数 $A(k,\omega)$ 与 TTF-TCNQ
动量分辨的谱函数(ARPES 直接测的量):
在一维 Hubbard 模型里,自旋-电荷分离表现为 $A(k,\omega)$ 把一个电子峰劈裂成两个:
- 非相互作用($U=0$):$A(k,\omega)$ 是一个 $\delta$ 峰(在 $\varepsilon_k$);
- 一维相互作用:劈裂成两个峰——一个对应 holon(空穴子,携电荷,色散由电荷速度决定),一个对应 spinon(自旋子,携自旋,色散由自旋速度决定)。
| 激发 | 携带 | 电荷 | 自旋 |
|---|---|---|---|
| holon(空穴子) | 电荷 | $+e$(空穴) | 0 |
| spinon(自旋子) | 自旋 | 0 | $1/2$ |
为什么一维会分离:一维粒子不能互相绕过。电荷的运动是所有电子的集体位移(hopping 驱动,$v_c\sim t$);自旋的运动是相邻自旋交换(超交换驱动,$v_s\sim t^2/U$,$J\sim4t^2/U$)。两者机制不同、速度不同,所以会分开。$U\gg t$ 时 $v_c\gg v_s$。
TTF-TCNQ(准一维有机导体)的 ARPES 实验在 $\Gamma-k_F-Z-k_F$ 方向上直接看到了这条劈裂——标记为 charge (c) 和 spin (s) 的两条色散带。ED + Lanczos 算出的 $A(k,\omega)$ 能定量重现它。
“长程反铁磁序”的措辞要谨慎。 讲义第 27 页说一维 Hubbard 基态是”Mott insulator with long-range AF ordering”,但严格的长程反铁磁序在一维不存在——连续对称性不能自发破缺(Mermin–Wagner 定理)。它指的是短程反铁磁关联很强($S(q=\pi)$ 有峰),且有限尺寸 ED 里关联长度可能超过系统尺寸而”看起来像”长程序。这是”过度宣称”的风险点。
研究前沿
Chebyshev 赝 site 矩阵乘积态:电子-声子耦合的谱函数
(Pei-Yuan Zhao, Ke Ding, and Shuo Yang, Phys. Rev. Res. 5, 023026 (2023))
本讲前面讲的全是纯电子的 Hubbard 模型。真实材料里电子与晶格振动(声子)耦合,带来新物理:
- 极化子(polaron):电子带着晶格畸变运动,有效质量变大;
- 声子边带(phonon sidebands):谱函数上出现等间距的额外峰(电子同时激发整数个声子);
- 标注的 SP / HO / SH 正是这些结构。
问题是希尔伯特空间变成”电子⊗声子”,维度爆炸(声子截断到 $N_{\rm ph}$),超出 Lanczos 单打独斗的能力。这时需要新方法——把谱函数算法和张量网络(MPS,第 2 章)结合的 Chebyshev 赝 site 方法。
Chebyshev 展开是谱函数的另一条经典路线:
它和 Lanczos+连分数的对比:
| Lanczos + 连分数 | Chebyshev | |
|---|---|---|
| 基 | Krylov 基 $\{\hat H^k\lvert\phi_0\rangle\}$ | Chebyshev 基 $\{T_n(\tilde H)\lvert\phi_0\rangle\}$ |
| 系数递推 | 三项递推 $(a_m,b_m)$ | 三项递推(Chebyshev 固定递推) |
| 收敛 | 依赖 $z$(见前节) | 一致(最优一致逼近) |
| 数值稳定性 | 正交性会丢(陷阱一) | 不需要正交基 |
掺杂 Mott 绝缘体中的条纹
一维的”spinon/holon 分离”到了二维会变成条纹(stripe)相:空穴不是均匀分布,而是聚成反平行的自旋区域,夹着电荷条。虽是一维到二维的转变,但”电荷与自旋分离”这个主题是相通的。
校检清单
“能跑”不等于”对”。本讲所有结果都用下面这些校检把关,任何一条不过就是有 bug:
| # | 校检什么 | 期望 | 实测 |
|---|---|---|---|
| 1 | 哈密顿量厄米 $\lvert\hat H-\hat H^\dagger\rvert$ | 0 | $0.000\times10^{0}$ |
| 2 | 基态残差 $\lVert\hat H\psi_0-E_0\psi_0\rVert$ | 0 | $7.9\times10^{-15}$ |
| 3 | $\hat HV=VT$(已构造列) | 0 | $\le2\times10^{-15}$ |
| 4 | 最后一列残差 | $=b_m$ | $6.334896=b_6$ |
| 5 | 基态作起始 $\Rightarrow$ $b_1=0$ | 0 | $8.1\times10^{-15}$ |
| 6 | $(4,4)$ 块维数 | $\binom84^2=4900$ | $4900$ |
| 7 | $U=0$ 块基态 | $-4-4\sqrt2=-9.6568542$(4 重简并) | 一致 |
| 8 | 连分数 vs 直接解 $\hat HV=VT$ | 0 | $\le3\times10^{-16}$($z$ 远离谱权重时) |
| 9 | $w_{\rm add}=w_{\rm rem}=N$(分开校检) | 8,8 | $8.0000,\ 8.0000$ |
| 10 | $U=0$ 解析基准(逐点) | 0 | $4.5\times10^{-14}$ |
| 11 | $\mu(U)=U/2$(粒子-空穴对称) | $U/2$ | $0,1,2,3,4$ 全部通过 |
| 12 | Ritz$\to E_0$($L=60$) | $E_0=-4.6035263$ | $2.8\times10^{-14}$ |
| 13 | 鬼本征值(plain vs 重正交) | 0 重复 | 0(重正交);24(plain,对照) |
“故意改错”自检——证明这些校检非平凡(会真的失败):
| 变体 | 厄米性 | $U=0$ 基准 |
|---|---|---|
| 正确 | 通过 | 通过($4.5\times10^{-14}$) |
| 开边界(去掉周期项) | 通过 | 失败 |
| 单方向跳跃(漏 h.c.) | 失败 | 失败 |
| 去掉费米子符号 | 通过 | 失败(单粒子块抓不住) |
| 漏乘 $\alpha^2$ | — | 失败(幅度错,求和规则抓) |
要点:厄米性只抓”漏方向”;$U=0$ 基准抓”符号/幅度”。两类校检互补。单粒子块里最多一个电子、符号恒 $+1$,所以单粒子谱抓不住费米子符号——必须靠多体块的基准。
附:复现用的代码工具箱
本讲所有图都可以用下面这个工具箱复现(只需 numpy + scipy)。放到 ed3.py:
"""ED3 toolbox: Hubbard ring blocks + Lanczos + continued fraction + spectral function.""" |
注:本工具箱用”每个自旋一个 $N$ 位 mask”——mask 内的局域轨道索引就是格点号,所以产生/湮灭算符直接用格点号
j,不要再加 $N\sigma$ 偏移。(第二讲里”全局 $2N$ 比特串、$\uparrow$ 放低 $N$ 位”的写法在分块结构里不适用;如果照搬那个偏移,下自旋的所有轨道号会越界,下自旋的整个矩阵变成零——一个静默的、能量恰好差一半的错误。)all_channels/dos中的每个通道只做一次 Lanczos,之后可按不同截断步数 $L$、不同 $\omega$ 复用。
延伸阅读与作业
- 讲义:第三讲幻灯片(32 页)与配套逐页中文讲义
Lecture03_Notes.pdf。 - 作业:
Lecture03_Homework.pdf——Hubbard 环上的分块、Lanczos、连分数、$\rho(\omega)$,必做 1–5、选做 6–8,附完整校检清单与”故意改错”自检。 - 参考:Fehske, Schneider, Weiße (eds.), Computational Many-Particle Physics, LNP 739 (2008),Lanczos 与谱函数章节。