02 精确对角化
- 精确对角化:总览
- 约定警告:格点编号方向与第一讲相反
- 基矢的比特表示
- 哈密顿量矩阵的构造
- 对称性与基矢查找
- 费米子系统
- 求解与测量
- 实时演化
- 非厄米哈密顿量
- 作业与评分
- 附:复现用的代码工具箱
- 附:ED 代码自查清单
- 附:常见错误清单
- 附:延伸阅读
精确对角化:总览
第一讲把整门课的地图铺开了:一个方程(定态薛定谔方程 $\hat H|\Psi\rangle = E|\Psi\rangle$)、四类方法(精确对角化、密度矩阵重整化群与矩阵乘积态、张量网络、量子蒙特卡罗,另有 NRG/DMFT/机器学习),以及三个格点模型。本讲开始兑现地图上的第一块——精确对角化(Exact Diagonalization, ED),也就是课程大纲第 1 章的上半场(ED I)。
一句话概括本讲:把一个 $2^N$ 维的量子多体问题,变成一个稀疏矩阵的本征值问题。ED 的全部技术含量都在”怎么把算符翻译成矩阵”这件事上。
为什么做 ED
ED 是四类方法里唯一不做任何物理近似的方法。它只有两种误差:有限尺寸(格子太小)和浮点舍入($10^{-15}$ 量级)。正因为它诚实,它才成为其它所有方法的裁判。幻灯片给了四条理由,从”理想”到”功利”:
完备性。一旦拿到全部本征对 $\{E_n,|\psi_n\rangle\}$,你就拥有了一切:
- 基态能量与基态波函数;
- 静态关联函数 $\langle\psi_0|S^z_iS^z_j|\psi_0\rangle$;
- 动力学谱函数 $A(\mathbf k,\omega) = \sum_n |\langle\psi_n|S^z_{\mathbf k}|\psi_0\rangle|^2\,\delta(\omega - (E_n - E_0))$;
- 有限温度期望值 $\langle O\rangle = \mathrm{Tr}(e^{-\beta\hat H}O)/\mathrm{Tr}(e^{-\beta\hat H})$;
- 实时间演化 $e^{-i\hat Ht}|\psi_0\rangle$。
这是 ED 与 DMRG/QMC 最大的差别:DMRG 通常只给基态(加几个受截断控制的低能态),QMC 用抽样代替显式求和;而 ED 给你整个谱(在能算得动的维数内)。
- 洞察。小格子上的精确解经常直接给出物理图像:自旋液体、拓扑序、分数化激发、简并的基态多重态——这些概念很多是先在小簇的 ED 里看清楚,再推广的。
- 裁判。这是 ED 在当代最不可替代的角色。DMRG、QMC、张量网络、神经网络量子态都有各自的近似/系统误差(键维数、符号问题、抽样噪声、表达力),而 $N = 16\sim24$ 的 ED 结果是精确的,可以直接拿来对答案。做新方法的人第一件事几乎都是”先和 ED 对上”。
- 学习量子力学。ED 强迫你把波函数、算符、对称性、守恒量全部具体化:基矢是整数、算符是比特翻转、对称性是块对角。上完这一章,第一讲的二次量子化、张量积、纠缠那些抽象概念都会”落地”。
不要把 ED 想成”只能算玩具”。下面会看到,今天自旋模型的 ED 已经能做到 40–48 个格点、$10^9$ 量级的基矢维数——这足以回答很多二维阻挫磁体的真问题。
希尔伯特空间有多大
这是第一讲”指数墙”的量化版。$N$ 个自旋-1/2 张成 $2^N$ 维空间:
| $N$ | $2^N$ | 一个复态矢量(16 B/分量) | 稠密哈密顿量元素数 |
|---|---|---|---|
| 10 | 1024 | 16 KB | $1.0\times10^6$ |
| 20 | 1048576 | 17 MB | $1.1\times10^{12}$ |
| 30 | $1.07\times10^9$ | 17 GB | $1.15\times10^{18}$ |
| 40 | $1.10\times10^{12}$ | 17.6 TB | 不可能 |
| 50 | $1.13\times10^{15}$ | 18 PB | 不可能 |
仅仅存放 $N=40$ 的一个波函数就要 17.6 TB 内存,比一台机器的内存大三个数量级。哈密顿量如果稠密存($2^N\times2^N$ 个元素)更是完全不可能。
“波函数是指数维空间里的一个矢量”这句话要背下来:后面所有方法的差别,都在于”怎么表示这个矢量”——ED 用完整矢量、DMRG/MPS 用张量、QMC 用抽样。
于是 ED 只有三条活路:
- 只存基矢中真正用到的部分——用对称性切扇区(U(1) / 平移 / 点群);
- 只存矩阵的非零元——稀疏。Heisenberg 模型每个基矢只和”每条键的一个伙伴”相连,非零元个数 $\sim N\cdot2^N$,而不是 $2^{2N}$;
- 完全不存矩阵(matrix-free)——只保留”矩阵-矢量乘法”这个能力。
第 2 条是稀疏的用武之地,第 3 条是 Lanczos 家族的动机。
ED 能做什么
按”算的是什么量”分类:
- 量子磁体(ED 的主战场):阻挫磁体的基态是”有序”还是”自旋液体”?一维链的临界指数;二维方格子/三角格子/笼目格子的低能谱与低能隙;动力学结构因子 $S(\mathbf k,\omega)$——可以直接和中子散射实验比。
- 费米子模型(Hubbard、$t$–$J$):电荷能隙 / 自旋能隙、超导配对关联 $\langle\Delta_i^\dagger\Delta_j\rangle$、关联函数的幂律指数。这类模型需要处理费米子符号。
- 分数量子霍尔:在球面/环面几何上对角化(最多 16–20 个电子),算能隙、与 Laughlin / Moore–Read 等模型波函数的重叠、以及纠缠谱。
- 受约束模型:量子二聚体模型(每条键上恰好一个二聚体)需要自定义基矢生成,希尔伯特空间不是简单的 $2^N$——这是 ED 灵活性的体现。
- 量子化学 / 核结构:”full configuration interaction”(全组态相互作用)就是化学家对 ED 的叫法:在给定的单粒子轨道基里做完全对角化。区别只是轨道数少(十几个),但每个轨道的相互作用更复杂。
- 量子场论:把连续场论离散到格点上(如 $1+1$ 维 $\phi^4$、Ising 场论),用 ED 做小格子的精确基准。
幻灯片强调 quantum magnets 里的 “dynamical correlation functions in 1D & 2D”:一维其实 DMRG 能做到上千格点,ED 的独特价值在二维(DMRG 在二维很吃力)。
今天的规模极限
这一页给出的是”今天”(2026 年)的实际能力边界:
| 体系 | 做到的规模 | 最大基矢维数 |
|---|---|---|
| 自旋 $S=1/2$ 模型 | 方格子 $N=40$;三角格子 $N=39$;蜂窝格子 $N=42$;笼目格子 $N=48$ | 15 亿 |
| 分数量子霍尔 | 不同填充因子,最多 16–20 个电子 | 35 亿 |
| Hubbard 模型 | 半满方格子 $N=20$;三角格子 $N=21$;蜂窝格子 $N=24$;量子点 $N=20$ | 30 亿 |
| Holstein 模型 | 链 $N=14$ + 声子赝格点 | 300 亿 |
逐条理解”为什么是这个数”:
- 自旋模型为什么能到 40–48 个格点? 每个格点只有 2 个态,而且对称性特别多。以 40 格点方格子为例:仅用 $S^z=0$ 扇区,维数是 $\binom{40}{20} = 1.38\times10^{11}$;再除以平移群(40 个元素)和点群(4 个元素),就降到与幻灯片说的”15 亿”同一量级(具体数字取决于用了哪几种对称性、是哪个格子)。对称性是这里最大的加速来源。
- Hubbard 为什么只能到 20–24 个格点? 每个格点有 4 个态(空、$\uparrow$、$\downarrow$、双占),所以单是格点数 $N$ 就对应 $2N$ 个自旋轨道、全空间 $2^{2N}$ 维;半满时还要限制在 $(N_\uparrow,N_\downarrow) = (N/2, N/2)$ 的块里,该块维数是 $\binom{N}{N/2}^2$($N=20$ 时 $\binom{20}{10}^2 = 3.4\times10^{10}$),比同尺寸自旋模型的 $\binom{N}{N/2}$ 大了一个平方。再叠上平移与点群、以及费米子符号的开销,就落到幻灯片说的 30 亿量级。
- Holstein 为什么基矢维数反而最大? 因为声子是玻色子,每个格点有多个声子态,需要用截断的声子赝格点(pseudo-site)。基矢维数大但每个基矢的非零元很少,且可以用 Lanczos 只求少数低能态。
- FQH 的 16–20 个电子:电子在最低朗道能级里的态数是 $N_\phi+1$,在固定总角动量/动量扇区里做 ED,维数可达 35 亿。
易错:这一页的数字都是”最大基矢维数“,不是”总希尔伯特空间维数”——前者是用了对称性之后实际对角化的那个矩阵的大小,两者可能差好几个数量级。另外表格里的 $N$ 是格点数,Hubbard 半满时电子数 $=N$。”$N=48$ 的笼目格子”是 ED 的标志性成果(笼目格子的自旋液体问题),值得记住这个数字。
ED 程序的结构
这是本讲(也应该是你自己代码)的程序流程图。强烈建议把文件也按这四块组织:
ed.py |
对应幻灯片上的四层:
- Hilbert space(希尔伯特空间):基矢表示、查找技术、对称性;
- Hamiltonian matrix:稀疏矩阵表示(内存/磁盘)、matrix-free(实时重算);
- Linear algebra:LAPACK 完全对角化、Lanczos 型对角化(只需要”算符作用”);
- Observables:静态量、动力学量、实时间演化。
两个关键词必须理解透:
sparse(稀疏)。以 $N$ 格点的 Heisenberg 环为例:每个基矢有 1 个对角元,加上”相邻自旋相反”的键贡献的非对角元(平均 $N/2$ 条),所以
$N=4$ 环:$(1+2)\times16 = 48$,与后面数出来的完全一致。实测($J=1$):
| $N$ | 矩阵维数 $2^N$ | 非零元 nnz | 非对角元 | 密度 nnz/$2^{2N}$ |
|—-|—-|—-|—-|—-|
| 4 | 16 | 48 | 32 | 18.8% |
| 6 | 64 | 256 | 192 | 6.3% |
| 8 | 256 | 1280 | 1024 | 2.0% |
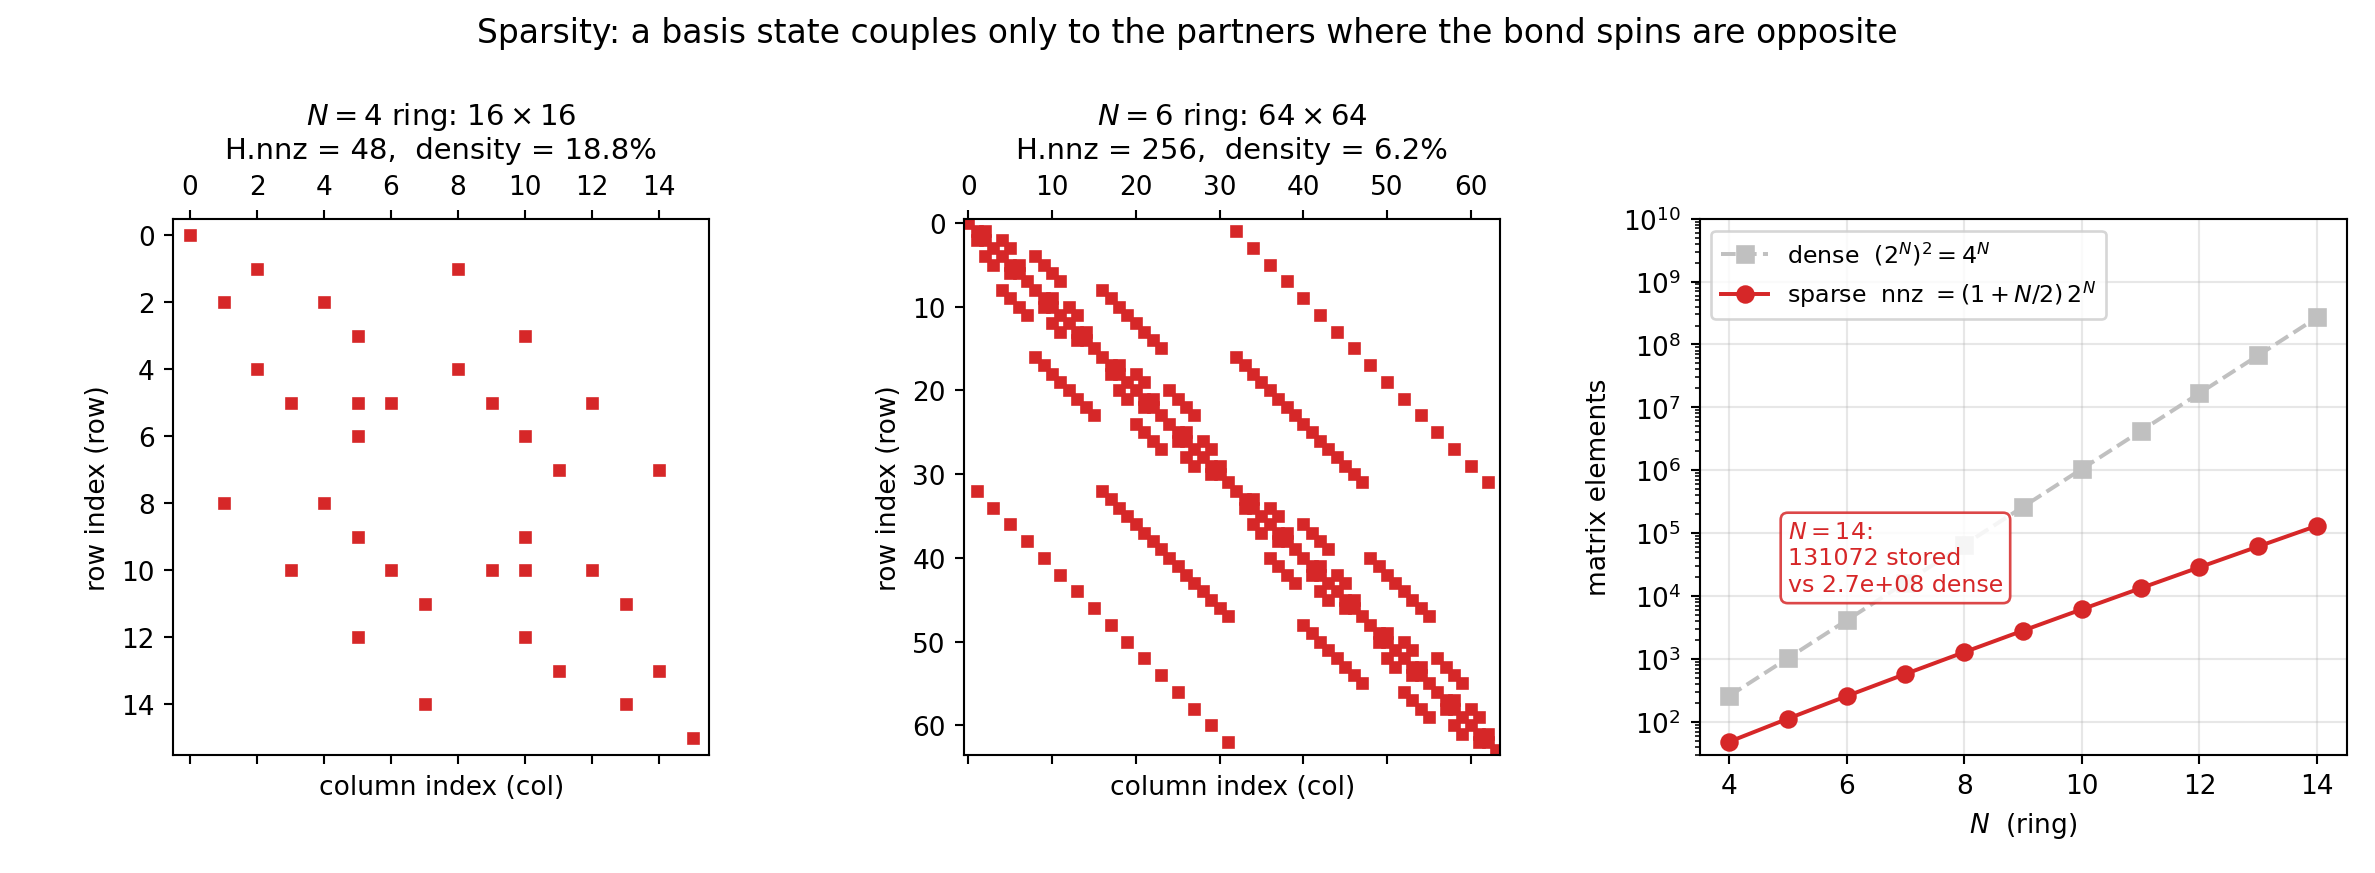
| 10 | 1024 | 6144 | 5120 | 0.6% |非对角元总数严格等于 $N\cdot2^{N-1}$(每条键上恰好一半的基矢满足”两自旋相反”),密度的指数下降来自 $2^{-N}$。$N\le24$(维数 $10^6\sim10^7$)时完全可行。
fig = plt.figure(figsize=(12.5, 4.6)) |
读图:
- 左两幅(
spy图)把非零元画出来。$N=4$ 环只有 48 个非零元,$N=6$ 环 256 个——注意那些”斜线”:它们正是”翻转两个比特”的非对角元,每个基矢的伙伴数等于”相邻自旋相反的键数”。$N=4$ 时能清楚看到 4 条对角线,对应 4 条键。 - 右图:红线的斜率是 $2^N$(线性),灰线是 $4^N$(指数)。这就是”稀疏”这两个字的全部价值——把指数墙从”矩阵元素数”上拿掉了。
密度从 $N=4$ 的 18.8% 一路掉到 $N=14$ 的 0.05%:“稀疏”不是”稍微少一点”,而是渐近意义上完全不同的一类矩阵。
- matrix-free(无矩阵)。连稀疏矩阵都不存,只写一个
apply_H(v) -> H @ v。内存只要 $O(2^N)$(几个矢量),代价是每次”作用”都现场算一遍。
“Lanczos type diagonalization (needs only operations)” 这句是整页的钥匙:Lanczos 不需要矩阵元,只需要 $\hat H$ 对矢量的作用。这正是 matrix-free 的动机。
易错:不要把”完全对角化”和”迭代对角化”混用。完全对角化(
eigh)给全部本征值,代价 $O(D^3)$、内存 $O(D^2)$;迭代对角化(eigsh)只给少数极值本征值,内存降到 $O(D)$。
约定警告:格点编号方向与第一讲相反
这是本讲唯一一个会让人白写一天代码的坑,必须先讲。
第一讲的”全局约定表”写的是:格点 0 在最左边,$n = \sum_i s_i 2^{N-1-i}$(格点 0 是最高位)——那是用 np.kron 逐个张量积的自然写法。
本讲的幻灯片与示例代码用的是相反的标签:格点 $i$ 就是第 $i$ 位,格点 0 在最右边(最低位),
两个证据:① 幻灯片把 $|0000\rangle$ 的最左边标为”第 3 位”、最右边标为”第 0 位”;② 费米子的例子里,$\uparrow$ 的比特串 $1101$ 恰好对应格点 $\{0,2,3\}$,$\downarrow$ 的 $1010$ 对应 $\{1,3\}$——只有”格点 $i$ = 第 $i$ 位”才成立。
| 量 | 第一讲(np.kron) |
本讲(比特运算) |
|---|---|---|
| 格点 0 的位置 | 最左因子 | 最右位(最低位) |
| 基矢编码 | $n=\sum_i s_i2^{N-1-i}$ | $n=\sum_i s_i2^i$ |
| 比特串的排版 | 左 = 格点 0 | 右 = 格点 0 |
$n=1$(比特串 0001)代表的状态 |
格点 3 向上 | 格点 0 向上 |
$n=2$(比特串 0010)代表的状态 |
格点 2 向上 | 格点 1 向上 |
这只是标签约定,不改变任何物理(相当于把格点编号整体反了个方向)。但在同一份代码里必须二选一:如果你把第一讲用 np.kron 写的矩阵和本讲用比特运算写的矩阵混在一起,格点顺序会反,所有局域量(关联函数、结构因子、边界项)都会错,而且不会报错。
本讲义全部采用本讲(比特)约定。
基矢的比特表示
自旋态 ↔ 二进制 ↔ 十进制
为什么可以用一个整数代表一个多体基矢? 因为自旋-1/2 每个格点只有两个状态,正好对应一个二进制位(bit)。$N$ 个格点 $\leftrightarrow$ $N$ 位二进制数 $\leftrightarrow$ $[0, 2^N-1]$ 的整数。这个对应关系是整章的地基:“基矢”就是一个 int,”波函数”就是一个长度为 $2^N$ 的复数数组。
$N=4$ 的完整对照表($\uparrow\to|1\rangle$,$\downarrow\to|0\rangle$):
| 自旋态 | 比特串 | 十进制 | 哪些格点是 $\uparrow$ |
|---|---|---|---|
| $\lvert \downarrow\downarrow\downarrow\downarrow\rangle$ | 0000 | 0 | (无) |
| $\lvert \downarrow\downarrow\downarrow\uparrow\rangle$ | 0001 | 1 | $\{0\}$ |
| $\lvert \downarrow\downarrow\uparrow\downarrow\rangle$ | 0010 | 2 | $\{1\}$ |
| $\lvert \downarrow\downarrow\uparrow\uparrow\rangle$ | 0011 | 3 | $\{0,1\}$ |
| $\lvert \downarrow\uparrow\downarrow\downarrow\rangle$ | 0100 | 4 | $\{2\}$ |
| $\lvert \downarrow\uparrow\downarrow\uparrow\rangle$ | 0101 | 5 | $\{0,2\}$ |
| $\lvert \downarrow\uparrow\uparrow\downarrow\rangle$ | 0110 | 6 | $\{1,2\}$ |
| $\lvert \downarrow\uparrow\uparrow\uparrow\rangle$ | 0111 | 7 | $\{0,1,2\}$ |
| $\lvert \uparrow\downarrow\downarrow\downarrow\rangle$ | 1000 | 8 | $\{3\}$ |
| $\lvert \uparrow\downarrow\downarrow\uparrow\rangle$ | 1001 | 9 | $\{0,3\}$ |
| $\lvert \uparrow\downarrow\uparrow\downarrow\rangle$ | 1010 | 10 | $\{1,3\}$ |
| $\lvert \uparrow\downarrow\uparrow\uparrow\rangle$ | 1011 | 11 | $\{0,1,3\}$ |
| $\lvert \uparrow\uparrow\downarrow\downarrow\rangle$ | 1100 | 12 | $\{2,3\}$ |
| $\lvert \uparrow\uparrow\downarrow\uparrow\rangle$ | 1101 | 13 | $\{0,2,3\}$ |
| $\lvert \uparrow\uparrow\uparrow\downarrow\rangle$ | 1110 | 14 | $\{1,2,3\}$ |
| $\lvert \uparrow\uparrow\uparrow\uparrow\rangle$ | 1111 | 15 | $\{0,1,2,3\}$ |
最后一列就是本讲约定的自检器:把比特串里为 1 的位号读出来,就是 $\uparrow$ 的格点编号。看第 10 行和第 14 行——1010 的 $\uparrow$ 在 $\{1,3\}$、1101 的 $\uparrow$ 在 $\{0,2,3\}$,正是后面费米子那一节要用的两个例子。
三个要点:
- 比特位与格点的对应:$n = \sum_{i=0}^{N-1} n_i2^i$,$n_i = 1$ 表示格点 $i$ 是 $\uparrow$。所以表里
0001$= 1$ 表示格点 0 向上、格点 1–3 向下(第 0 位是最右边那一位,权重 $2^0=1$)。 - “从左到右是第 $N-1$ 位到第 0 位”——这是写给人看的排版约定,与”格点 $i$ = 第 $i$ 位”是同一件事的两种说法。看表时先找比特串的位标注,不要从左边开始数格点。
- 表中 16 个态按整数递增排列,这正好就是”字典序”。后面 $U(1)$ 对称性要做的事,就是把这张表按”$\uparrow$ 的个数”重新分桶。
易错:$|\downarrow\downarrow\downarrow\uparrow\rangle$ 是 1 还是 8?按本讲约定是 1(最右边是格点 0,权重 1)。如果你从第一讲的
np.kron路线过来,直觉会给出 8。两者都对,但必须全篇统一。易错:$\uparrow\to1$ 这个映射是人为选择;选 $\uparrow\to0$ 也完全可以,只是所有公式里的 $-0.5$ 要改成 $+0.5$。
调试建议:永远用
np.binary_repr(n, width=N)打印,不要靠脑子做二进制心算。
# 把讲义第 8 页的对照表画出来:每一格是一个基矢 |
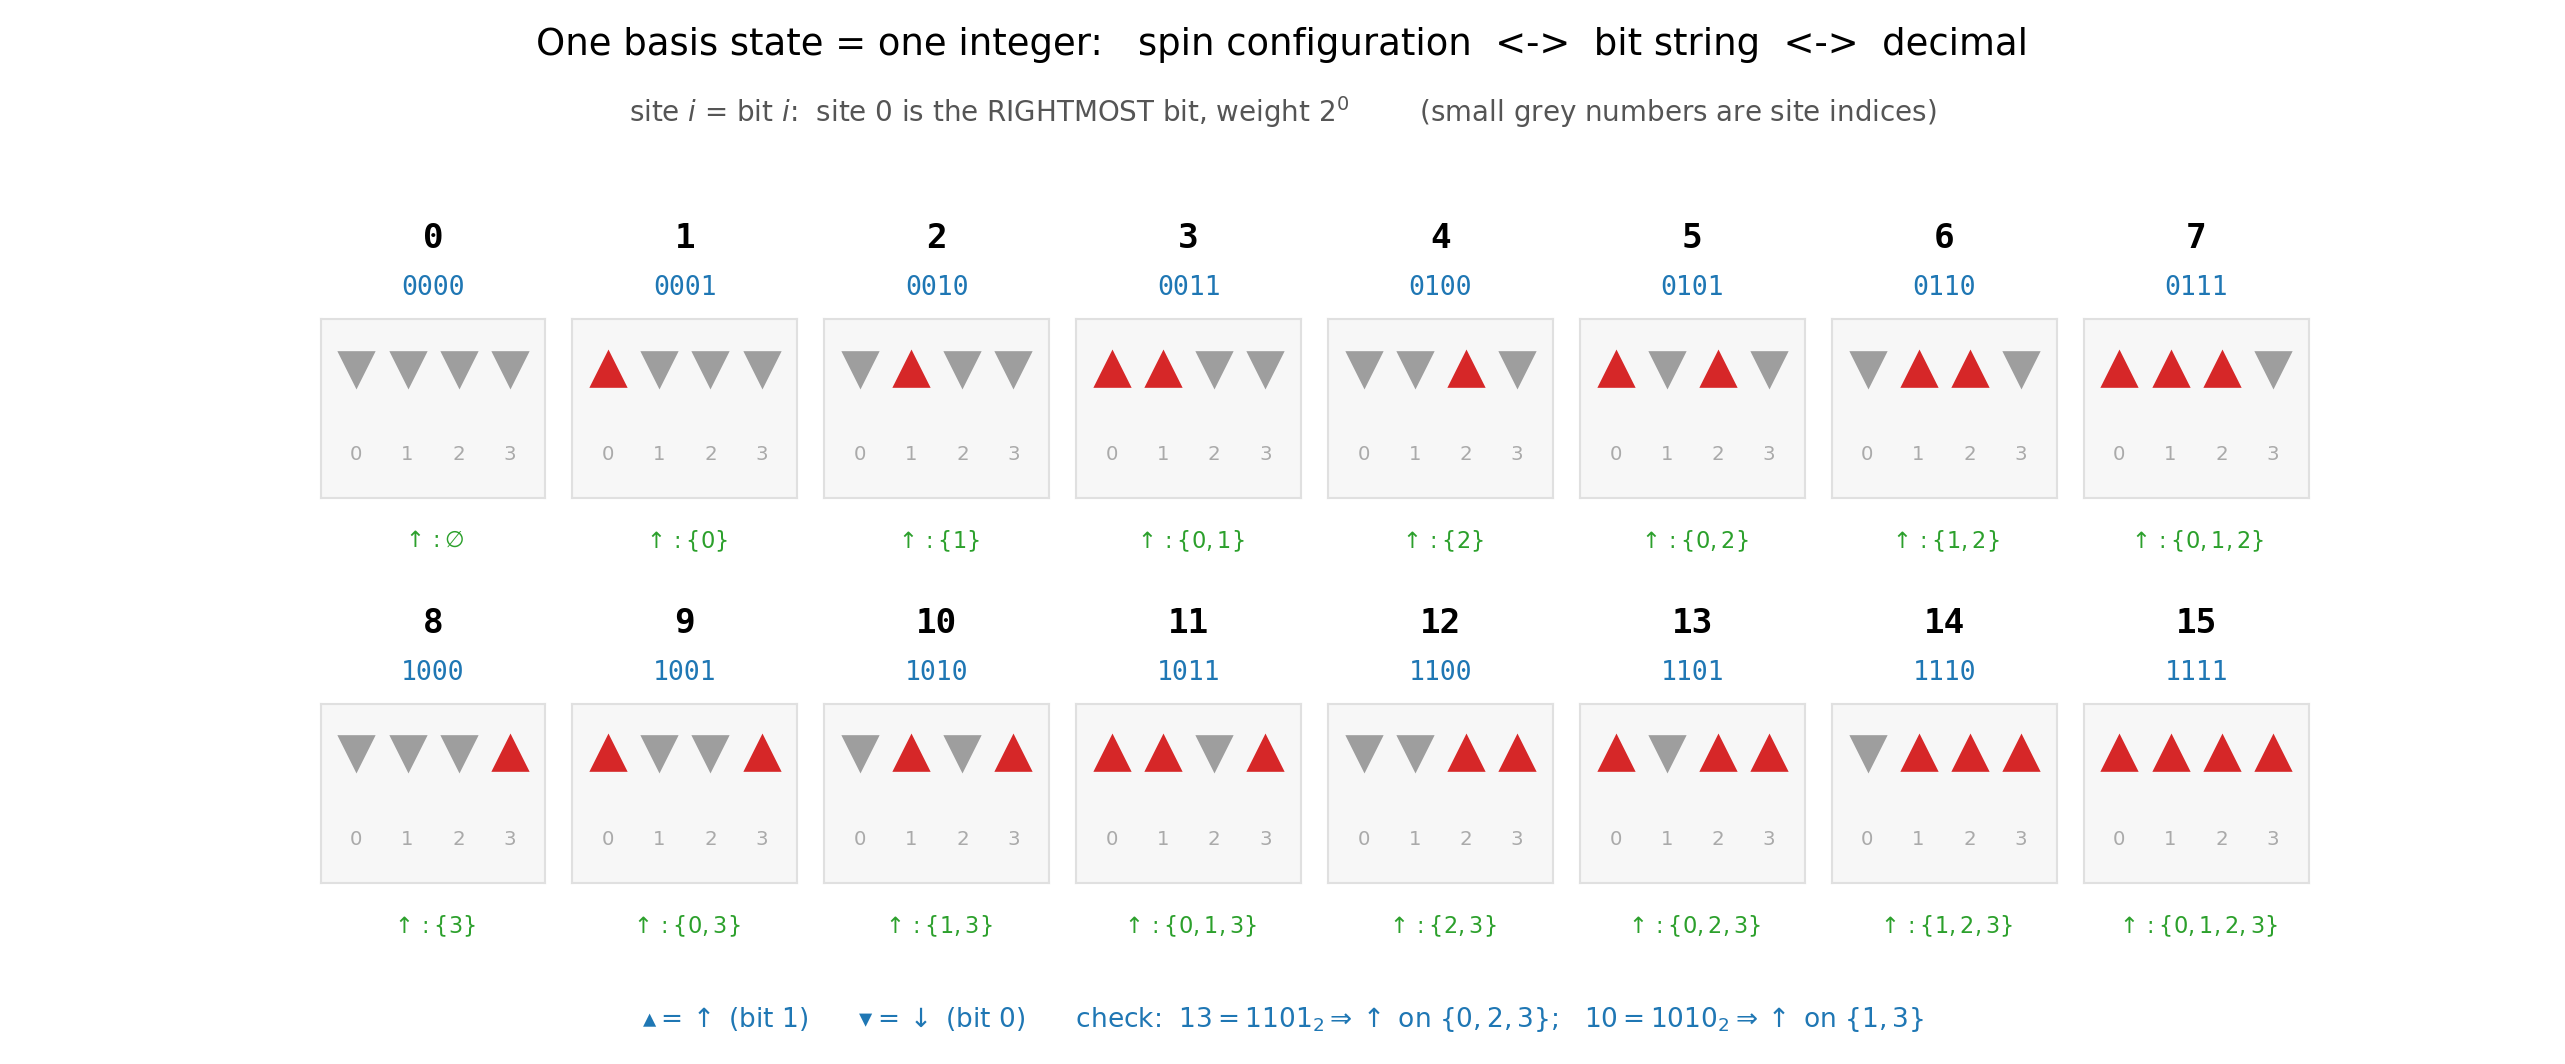
读图:每一格就是一个基矢。三行信息从上到下分别是十进制 $n$、比特串、四个箭头(红 $\uparrow$ = 1,灰 $\downarrow$ = 0)。注意小灰字是格点编号:红色的箭头永远出现在”比特串里为 1 的位号”上——这正是本讲约定(格点 $i$ = 第 $i$ 位)的自检器。
把 $n=13$ 那一格单独拎出来:$1101_2$ 里有三个 1,分别在第 0、2、3 位,所以 $\uparrow$ 在格点 $\{0,2,3\}$。如果你的代码给出的是 $\{1,2,3\}$,那就是格点编号方向搞反了(见前文的约定警告)。
按位运算
四种按位运算在 ED 里各有分工:
| 运算 | 记法 | 在 ED 里的用途 | ||
|---|---|---|---|---|
| AND | x & y |
读位 x & (1<<n);取掩码 x & mask |
||
| OR | `x \ | y` | 置位 `x \ | (1<<n)` |
| XOR | x ^ y |
翻位 x ^ (1<<n)(自旋翻转 = $S^\pm$) |
||
| NOT | ~x |
配合 AND 做清零 x & ~(1<<n) |
||
| 左移 | x << n |
把第 $i$ 位搬到第 $i+n$ 位 | ||
| 右移 | x >> n |
把第 $i$ 位搬到第 $i-n$ 位 |
幻灯片给的例子 $201\ \&\ 15 = 9$ 其实就是”取低 4 位”:
201 = 1100 1001₂ |
关于 Python 的 ~:Python 整数是任意精度且用补码语义,所以 ~x = -x-1(例如 ~5 = -6),看起来”很怪”。但 x & ~(1<<n) 是安全的:~(1<<n) 的二进制是”除了第 $n$ 位以外全是 1”,AND 上去正好把第 $n$ 位清零,高位不受影响。只要不单独使用 ~x 就没问题。
易错(优先级陷阱):在 Python 里
&的优先级低于==和+,所以x & 1 == 1会被解析成x & (1 == 1)!写代码时永远加括号:(x & 1) == 1。易错:
np.binary_repr(n, width=4)给固定宽度(前面补 0),np.base_repr(n, base=2)不给前导 0。调试时用前者,因为位对齐很重要。易错:幻灯片上的真值表是按位运算,不是逻辑运算(
and/or/not);在 numpy 数组上要区分&(按位)和np.logical_and(逻辑)。
四个基本操作
这四个函数就是整个 ED 的”指令集”——后面所有哈密顿量项,全部由它们拼出来。
逐个看:
- SetBit:
1<<n只有第 $n$ 位是 1,OR 上去就把它强制置 1,其余位不变。 - ClearBit:
~(1<<n)是”除了第 $n$ 位全是 1”的掩码,AND 上去就把第 $n$ 位强制清 0。 - FlipBit:XOR 与 1 相遇就翻转,与 0 相遇不变。这是自旋翻转 $S^\pm$ 的全部内容——后面非对角元就是”翻转两个比特”。
- ReadBit:先 AND 取出第 $n$ 位(结果要么是 0、要么是 $2^n$),再右移 $n$ 位归一化成 0 或 1。返回的是整数 0/1,不是布尔值。
用 $i = 5 = 0101_2$ 逐个验证:
| 操作 | 计算 | 结果 | 二进制 |
|---|---|---|---|
SetBit(5,1) |
$5\mid 2 = 7$ | 7 | 0111 |
ClearBit(5,2) |
$5\ \&\ \sim4 = 1$ | 1 | 0001 |
FlipBit(5,1) |
$5\ \mathrm{XOR}\ 2 = 7$ | 7 | 0111 |
ReadBit(5,2) |
$(5\ \&\ 4)\gg 2 = 1$ | 1 | 1 |
自旋与比特的换算:
即 $\uparrow\to+\frac12$、$\downarrow\to-\frac12$。
易错(最典型的 bug):
ReadBit的返回值必须归一化到 0/1。如果你忘了>> n,得到的是 0 或 $2^n$,于是 $S^z_i = \mathrm{ReadBit} - 0.5$ 变成 $-0.5$ 或 $2^n - 0.5$——能量错得离谱但代码不报错。务必用”基态能量是否等于已知值”来验证。在 C/C++ 里要用
1u << n或1LL << n防止溢出;Python 没有这个问题(任意精度整数),但也因此更慢,大规模 ED 里常用 numpy 的uint64数组做批量位运算。
三个进阶操作
各自对应一个物理用途:
PopCntBit= 数自旋向上的格点数。因为 $\uparrow\to1$,所以 popcount 就是 $N_\uparrow$,而这是 $U(1)$ 扇区划分的依据。PickBit= 取出比特串的一段。掩码 $(2^n-1)\ll k$ 是”从第 $k$ 位起连续 $n$ 个 1”,AND 之后右移 $k$ 位就把它对齐到低位。用途:把整数拆成”前段/后段”——这正是 Lin 表的关键。RotLBit/RotRBit= 环上的平移。在周期性边界的环上,把整个自旋构型沿环平移一格就是循环移位。用途:实现平移对称性,或生成一个动量扇区里的全部基矢。注意这里 $L$ 是总比特数,$n$ 是平移的格点数。
用幻灯片参数($L=4$,$n=1$)验算,取 $i = 13 = 1101_2$:
| 操作 | 计算 | 结果 | 二进制 |
|---|---|---|---|
PopCntBit(13) |
bin(13).count("1") |
3 | 11 |
PickBit(13,1,2) |
$(13\ \&\ 6)\gg1 = 4\gg1$ | 2 | 10 |
RotLBit(13,4,1) |
$(5\ll1) + (13\gg3) = 10+1$ | 11 | 1011 |
RotRBit(13,4,1) |
$(1\ll3) + (13\gg1) = 8+6$ | 14 | 1110 |
对照:$1101$ 循环左移 1 位得 $1011$ ✓,循环右移 1 位得 $1110$ ✓。
易错(循环移位 ≠ 普通移位):普通移位会”丢掉”移出去的位并补 0;循环移位把丢掉的位补到另一端。只有循环移位才是环上的平移。用
<</>>做平移会让边界上的基矢变成”自旋跑出去了”的非法态,而且会丢掉真正的边界项。易错:
RotLBit里的 $L$ 必须等于比特串的总长度。用 $L=4$ 去处理 6 格点的态,平移会把第 4、5 位搅乱。性能:
bin(i).count("1")在 Python 里是”优雅但慢”的写法。要在 $10^7$ 个基矢上反复调用,用查表(把 16 位一块的 popcount 预先存好)或 numpy 的np.bitwise_count(NumPy ≥ 2.0)会快几十倍。Python ≥ 3.10 也可以用内置的int.bit_count()。
哈密顿量矩阵的构造
以环上的自旋-1/2 反铁磁 Heisenberg 模型为主角:
把 $S_i\cdot S_{i+1}$ 拆成对角与非对角两部分(第一讲已给):
这就是 ED 构造矩阵的全部内容:对角元用 ReadBit 算,非对角元用 FlipBit 造。
对角元
$S^z_i$ 是对角算符:它在每个基矢上的作用就是乘一个数 $\pm\frac12$。因此
- 两个自旋平行(↑↑ 或 ↓↓):$+\frac14$;
- 两个自旋反平行:$-\frac14$。
对反铁磁($J>0$),反平行的键能量更低——这就是反铁磁性的微观起源。把所有 $N$ 条键加起来:
环上取 $i+1 \to (i+1)\bmod N$(幻灯片里写的 $S_N = S_0$ 就是周期性边界)。
为什么这个式子这么值钱? 因为它说明对角元不需要任何”矩阵”:对每个基矢(一个整数),做 $N$ 次 ReadBit 就得到对角元。内存 $O(1)$(只存一个数),时间 $O(N)$。这是 ED 高效的核心原因之一。
易错:环上最后一条键是 $(N-1, 0)$,不要漏。(后面那份示例代码用的是开链,正好少了这一条——不是矛盾,是两个不同的模型。)
易错:对角元必须写在
if外面。不管两个自旋是否相同,每条键都贡献对角项。如果误把对角项也放进”两自旋不同”的if里,就只有”自旋相反”的基矢有对角元,漏掉了 $+\frac14$ 的贡献,能量完全错。易错:
Nl = 2**Ns不要写成2*Ns。这是最经典的笔误。
非对角元
升降算符的矩阵($S^\alpha = \frac12\sigma^\alpha$):
于是 $\frac12(S^+_iS^-_{i+1} + S^-_iS^+_{i+1})$ 的作用是交换一对反平行的自旋:
矩阵元为什么是 1(于是公式里给出 0.5)?因为 $S^+$ 把 $\downarrow$ 变成 $\uparrow$ 时系数恰好是 1(自旋-1/2 的特殊性),再乘公式里的因子 $\frac12$。
用比特语言说,这个过程是:
两个判据:
- 第 $i$ 与第 $i+1$ 个自旋必须不同。如果 $n_i = n_{i+1}$,那么 $S^+S^-$ 和 $S^-S^+$ 都作用为零(因为 $S^+|!\uparrow\rangle = 0$、$S^-|!\downarrow\rangle = 0$)。
- 必须同时翻转两个比特,矩阵元 $0.5$。
易错:矩阵元是 0.5 不是 1。这是 $\frac12$ 因子 + 自旋-1/2 的”巧合”共同造成的。对自旋-1 就不成立了(那时 $S^+$ 的矩阵元是 $\sqrt2$)。
易错:别把 $S^+S^-$ 写成 $S^+S^+$。前者守恒 $S^z$,后者不守恒——写错了 $S^z_{tot}$ 就不守恒,$U(1)$ 扇区立刻不成立(而且表现为”本征矢串扇区”这种很难查的现象)。
易错:幻灯片上 $\langle\cdots|S^+_iS^-_{i+1}|\cdots\rangle$ 的写法容易看漏下标顺序:是”第 $i$ 个的 $S^+$,第 $i+1$ 个的 $S^-$”。
稀疏三元组:COO 格式
幻灯片给了一张 32 行的表,把 4 格点环上全部非零的非对角元列出来。表头是 $(\text{col})_{10}\;|\;(\text{col})_2\;|\;i\;|\;i+1\;|\;(\text{row})_2\;|\;(\text{row})_{10}\;|\;\text{value}$,$value$ 列全是 0.5。底部一句话点题:“sparse matrix, only keep: row, column, value”。
这张表就是 scipy.sparse 的 COO 格式:三个等长数组 row、col、data。ED 的哈密顿量构造本质上就是”生成这三个数组”。例如前几行:
| $(\text{row})_{10}$ | $(\text{row})_2$ | $i$ | $i+1$ | $(\text{col})_{10}$ | $(\text{col})_2$ | value |
|---|---|---|---|---|---|---|
| 2 | 0010 | 0 | 1 | 1 | 0001 | 0.5 |
| 8 | 1000 | 3 | 0 | 1 | 0001 | 0.5 |
| 1 | 0001 | 0 | 1 | 2 | 0010 | 0.5 |
| 4 | 0100 | 1 | 2 | 2 | 0010 | 0.5 |
几个可以直接读出来的规律:
- 非对角元总数严格等于 $N\cdot2^{N-1}$。环上有 $N$ 条键,每条键上有 $2^{N-1}$ 个”两自旋相反”的基矢。$N=4$ 时 $4\times8 = 32$ ✓,与表格吻合。加上 16 个对角元,总非零元 48 个,而矩阵有 $16\times16=256$ 个元素——稀疏度约 19%。
- 对角线上的对称性:如果 $(\text{row},\text{col})$ 有一个非零元,那么 $(\text{col},\text{row})$ 也一定有一个同样大小的元($\hat H$ 厄米,$S^+_iS^-_{i+1}$ 的厄米共轭是 $S^-_iS^+_{i+1}$)。表里能直接看到这种”成对出现”:第 1 行($1\to2,\ i=0$)与第 3 行($2\to1,\ i=0$)。这是校验代码的免费测试:构造完 $\hat H$ 后检查
(H - H.T).nnz == 0。 - 每个基矢的非对角伙伴个数 = “相邻自旋相反的键数”,可以是 $0\sim N$。$(\text{col})_{10} = 5$($0101$)有四个伙伴(4 条键上自旋都相反),而 $(\text{col})_{10}=1$($0001$)只有两个。
- 表里 $i=3,\ i+1=0$ 的行就是周期性边界的标志(键 $(3,0)$)。做开链时这些行必须删掉,矩阵会变成块结构。
易错:
value列全是 0.5 是自旋-1/2 的特例。换成 XXZ 模型($\Delta\neq1$)非对角元仍是 0.5,但对角元要乘上 $\Delta$;换成 XY 模型则对角元全为 0。易错(行、列写反):矩阵元是 $\langle\text{row}|\hat H|\text{col}\rangle$。所以”翻转比特得到的那个态”是 row,”原来的态”是 col。对厄米且矩阵元为实数的 $\hat H$(本例即是),写反了矩阵完全不变($\hat H^T = \hat H$),谱不会错;但如果 $\hat H$ 是复厄米的($\hat H^T = \hat H^\neq\hat H$),写反就等于用了 $\hat H^$,关联函数、时间演化都会错。养成”先想清楚行列”的习惯。
完整谱($N=4$ 环,实测):$\{E\in\{-2,-1,0,+1\}\}$,简并度依次 $1,3,7,5$。
这个结果可以和第一讲的严格论证互相印证:4 个 $s=1/2$ 自旋总共含 2 个单重态($S=0$)、3 个三重态($S=1$)、1 个五重态($S=2$)。完全对称的五重态是精确本征态、每条键给 $+\frac14J$,故 $E=+J$;基态是唯一的 $S=0$ 单重态($E=-2J$),符合第一讲提到的 Marshall 定理(二分格子上 $N$ 偶数时基态是单态)。谱的迹也是 0:$-2 - 3 + 0 + 5 = 0$ ✓,与后面验证清单里的 $\mathrm{Tr}\,\hat H = 0$ 一致。
# 左:4 格点环的完整谱 + 自旋多重态标注(谱是解析已知的) |
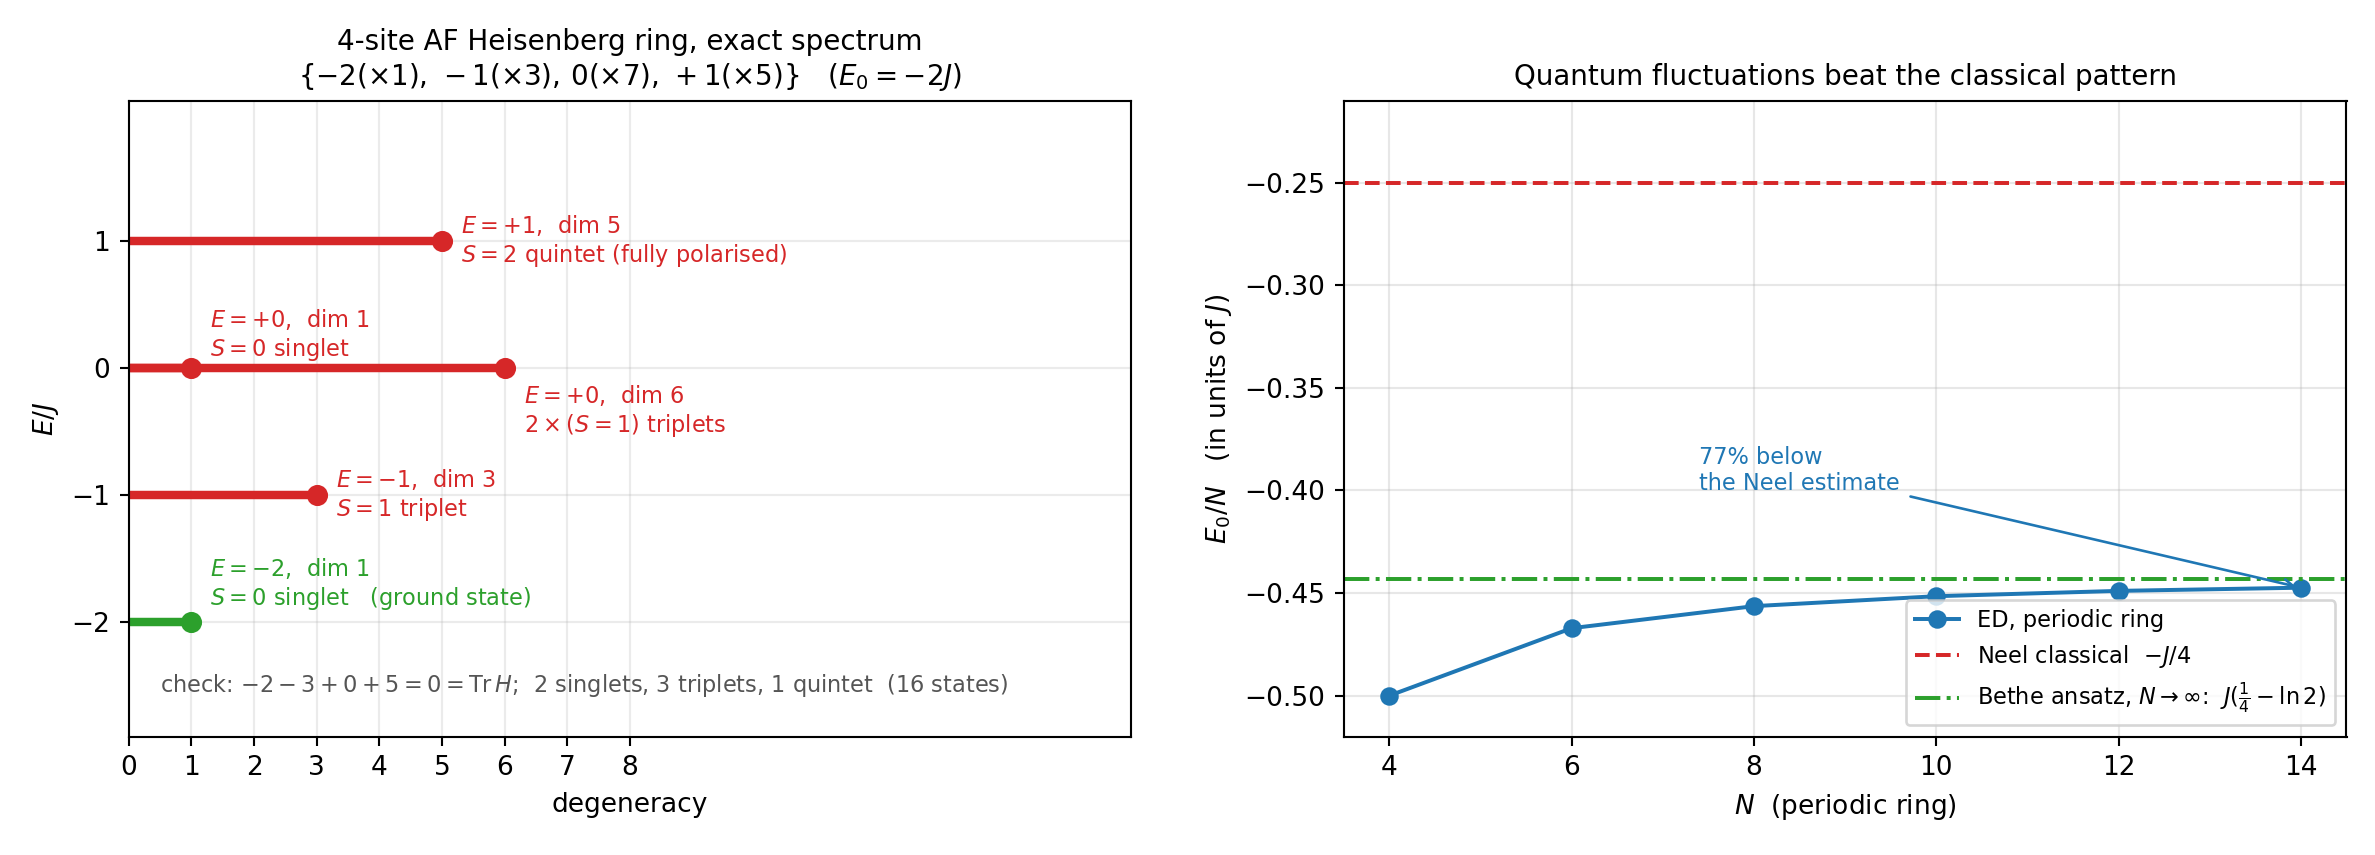
左图读法:横轴是简并度(= 那一能级的态数),纵轴是能量。绿色的 $E=-2$ 是唯一的单重态基态;$E=+1$ 的五重态就是完全极化态,每条键给 $+\frac14J$、四条键共 $+J$——它是精确本征态($S^z_iS^z_j$ 与 $S^\pm$ 都作用为零式的组合)。图下那行 “check” 是免费的检验:$2$ 个单重态 $+$ $3$ 个三重态 $+$ $1$ 个五重态 $= 2\times1+3\times3+1\times5 = 16$ 个态 ✓,迹 $=0$ ✓。
右图是”数值 $\to$ 物理”的桥梁:ED 逐点给出 $E_0/N$,在 $N=4\sim14$ 上从 $-0.500$ 收敛到 $-0.443$——正是第一讲给的严格解 $J(\frac14-\ln2)=-0.4431J$。而 Néel 变分线在 $-0.25$,比精确值高 77%。这张图把第一讲那句”量子涨落把能量降低了 77%”从一句话变成了可以看见的曲线。
完整代码与验证清单
把上面所有零件拼起来,就是本讲的中心。开边界的一维反铁磁 Heisenberg 链:
def GetHopList(Ns, periodic=False): |
逐块拆开:
- 基矢编号:
Nl = 2**Ns,i0遍历所有基矢(col),i1是伙伴基矢(row)。 - 键表:
GetHopList返回[[0,1],[1,2],...,[Ns-2,Ns-1]]。做环只需在末尾加[Ns-1, 0]。 - 非对角块:若
Pos0、Pos1两位不同,就同时翻转它们得到i1,追加一条(row=i1, col=i0, value=0.5*J)。 - 对角块:无论是否翻转,都对每个键累加 $(S^z_{Pos0})(S^z_{Pos1})$ 到 $(i0,i0)$。因为循环遍历所有键,重复的 $(i0,i0)$ 会被 COO 自动求和——这正是 $\sum_i$ 的代码实现,也是这段代码优雅的地方。
- 组装:COO 是”构造格式”(可以随便重复累加),CSC/CSR 才是”计算格式”(可以参与运算)。对 $\hat H y = x$ 这种矩阵-矢量乘法,CSR 更自然(按行取内积);对 $\hat H^T y$ 或按列操作,CSC 更自然。两者都可以,
eigsh内部会自己选。
验证清单(这是本讲的”考试重点”,务必全部跑一遍):
| 检验 | 期望值 | 实测 |
|---|---|---|
| $N=2$ 单键 $E_0$ | $-0.75$(单重态,第一讲已证) | ✓ |
| $N=4$ 开链 $E_0$ | $\approx-1.6160254$ | ✓ |
| $N=4$ 环 $E_0$ | $-2$(精确) | ✓ |
| $N=4$ 环的谱 | $\{-2(\times1),-1(\times3),0(\times7),+1(\times5)\}$ | ✓ |
| 迹 | $\mathrm{Tr}\,\hat H = 0$ | ✓ |
| 厄米性 | (H - H.T).nnz == 0 |
✓ |
| 非零元个数($N=4$ 环) | $32 + 16 = 48$ | ✓ |
其中 $\mathrm{Tr}\,\hat H = 0$ 值得单独一说:每条键的 $S^z_iS^z_{i+1}$ 在 $\uparrow\uparrow$ 和 $\downarrow\downarrow$ 上给 $+\frac14$、在 $\uparrow\downarrow/\downarrow\uparrow$ 上给 $-\frac14$,两种组态数目相同,正负恰好抵消。这是一个不需要算就已知的严格结果——用已知结果检验代码,是 ED 的基本素养。
for Ns, per in [(4, True), (4, False), (10, False)]: |
易错:本页代码是开链,而前面三节讲的是环。两者只差一条键,但物理差别不小(开链有边界自旋,环是平移不变的)。读幻灯片时不要以为前后矛盾。
性能:对 $N\ge20$,这段”逐基矢逐键”的 Python 双重循环会变慢。下一步的优化是(a)只遍历 $S^z$ 扇区、(b)用 numpy 向量化位运算、(c)用 Lin 表做查找。
推广:代码把 $J$ 做成了参数(默认 $J=1$,幻灯片里是硬编码的 1),所以改 $J$ 只要调
HeisenbergCOO(Ns, J=2.0)。推广到 $XXZ$($\Delta$)只要给对角元乘 $\Delta$;推广到自旋-$s$ 则 $S^\pm$ 的矩阵元不再等于 1($s=1$ 时是 $\sqrt2$),”一位比特 + 一次 FlipBit”这套也要重写。
对称性与基矢查找
块对角化:最便宜的加速
对称性是 ED 里”最便宜的加速”——不需要任何近似,只需要一点群论。
原理很简单:如果 $\hat H$ 与某个算符 $\hat G$ 对易($[\hat H,\hat G] = 0$),那么可以在 $\hat G$ 的本征基里把 $\hat H$ 写成块对角形式:
只对角化目标扇区,维数降低 $d_\alpha$ 倍、时间降低 $d_\alpha^3$ 倍。逐个看:
| 对称性 | 守恒量 / 量子数 | 扇区数 | 典型加速 |
|---|---|---|---|
| $U(1)$(粒子数 / $S^z_{tot}$) | $N_\uparrow - N_\downarrow$ | $N+1$ | 最大扇区维数 $\approx 2^N/\sqrt{\pi N/2}$,即 $\times\sqrt{\pi N/2}$ |
| 平移 $T$ | 动量 $\mathbf k = 2\pi\mathbf m/N$ | $N$ | $\times N$ |
| 点群 $PG$(反射、旋转) | 不可约表示 | $\lvert PG\rvert$ | $\times\lvert PG\rvert$ |
| 自旋反演($\uparrow\leftrightarrow\downarrow$) | 宇称 $\pm$ | 2 | $\times2$ |
| $SU(2)$ | 总自旋 $S$ | $\sim N/2$ | 只对”多重态”加速 |
幻灯片上给了两个例子,说明”能用的对称性取决于几何”:
- 40 格点方格子:平移群 $T$ 有 40 个元素,点群 $PG$ 有 4 个元素,乘积群 $40\times4=160$。于是 $\binom{40}{20}/160 \approx 8.6\times10^8$。注意:只有当你选的团簇本身具有这些对称性时才能用得上——幻灯片画面上那个倾斜的红方框就是在展示”怎么在格子里挑一个对称性好的团簇”。
- 二十-十二面体(30 顶点):这是富勒烯/多面体分子磁性模型的代表,其对称群 $I_h$ 有 120 个元素。在分子问题上,对称性带来的加速比平移群更大。
易错:对称性越多越好,但”能用的对称性”取决于几何。三角格子/笼目格子的团簇往往只能保留部分平移对称性(例如 $N=39$ 的三角格子,不能整除成方格子形状);选团簇是 ED 研究的一门手艺,选错了要么用不上对称性,要么引入严重的有限尺寸效应。
$U(1)$ vs $SU(2)$:$U(1)$ 只固定 $S^z_{tot}$;$SU(2)$ 还固定 $S_{tot}$,能把同一多重态里的态合并。用 $SU(2)$ 更省内存,但代码复杂得多(要处理 Clebsch–Gordan 系数)。本讲只要求用 $U(1)$(作业评分表里有”没用 $U(1)$ 扣 20 分”)。
易错:自旋反演对称性只有在零磁场、且扇区 $S^z$ 与 $-S^z$ 对称时才能用。
U(1) 对称性
$U(1)$ 对称性 $= S^z_{tot}$ 守恒。因为 Heisenberg 模型(和 Hubbard 模型)的每一项都不改变自旋向上的格点数,所以 $N_\uparrow$ 是好量子数。于是可以按 $N_\uparrow$ 把基矢分桶。$N=4$ 的例子:
| 扇区 | 基矢(全局标号) | 维数 $=\binom{N_\uparrow}{N}$ |
|---|---|---|
| $N_\uparrow = 0$ | $\{0\}$ | 1 |
| $N_\uparrow = 1$ | $\{1, 2, 4, 8\}$ | 4 |
| $N_\uparrow = 2$ | $\{3, 5, 6, 9, 10, 12\}$ | 6 |
| $N_\uparrow = 3$ | $\{7, 11, 13, 14\}$ | 4 |
| $N_\uparrow = 4$ | $\{15\}$ | 1 |
和为 16 ✓。一般地 $\sum_{i=0}^{N}\binom{N}{i} = 2^N$——这不是巧合,而是”分桶”的必然结果:所有桶加起来就是原来的 $2^N$ 个基矢(这就是二项式定理)。所以一般有 $N+1$ 个子空间。
“局部下标从 0 重新编号”是这一节的技术核心。以 $N_\uparrow=2$ 为例:
全局基矢标号: 3 5 6 9 10 12 |
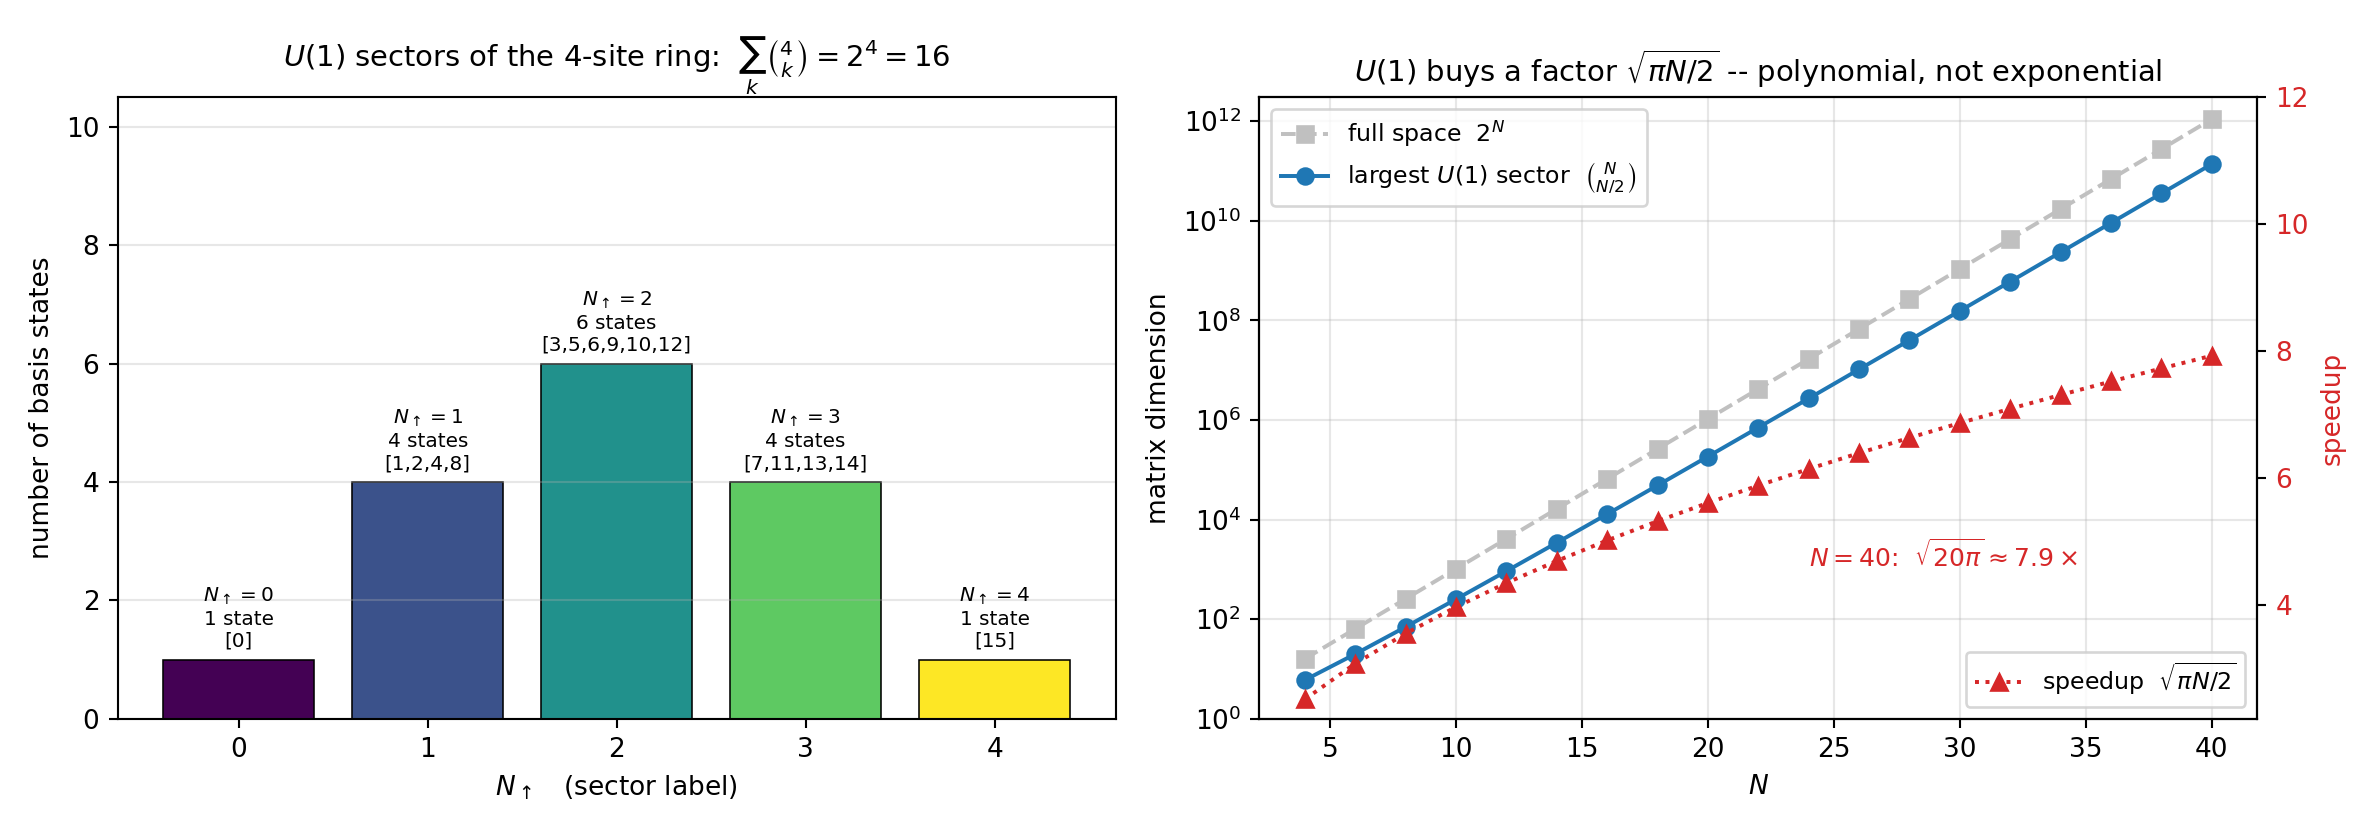
这样每个扇区都是一个独立的、维数小得多的 ED 问题。$N=4$ 时最大扇区是 $\binom42 = 6$,比 $2^4=16$ 小;$N=40$ 时最大扇区是 $\binom{40}{20} = 1.38\times10^{11}$,比 $2^{40}\approx1.1\times10^{12}$ 小约 8 倍——加速比就是:
# 左:4 格点按 N_up 分桶(就是讲义第 17 页那张表) |
读图:
- 左:五个桶的大小正好是二项式系数 $1,4,6,4,1$。$N_\uparrow=2$ 那个桶最大(6 个态),它就是你要对角化的那个小问题。桶里括号中的数字是全局基矢标号,桶内要重新编号 $0\sim5$。
- 右:两条线在对数坐标下几乎平行——因为加速比是常数因子而不是指数。红三角给出这个因子:$N=40$ 时约 7.9 倍。
一个必须记住的清醒判断:$\sqrt{\pi N/2}$ 是多项式收益,$N=40$ 也只有 8 倍。它救不了指数墙。它之所以重要,是因为它是”免费”的(只要求 $S^z$ 守恒,不损失精度),而且在它之上还能叠平移($\times N$)和点群($\times4$)——$40$ 格点方格子上 $8\times40\times4\approx1280$ 倍,这才是那几个百亿维数能被算出来的真正原因。
实现要点(三步):
- 生成全部 $2^N$ 个基矢,按
PopCntBit(i)分桶; - 每个桶内部按整数升序排序(这样局部下标就是”桶内秩”);
- 建一个查找表:给定全局整数 $i$,返回它在所属扇区里的局部下标。
易错:”$\uparrow$ 的个数”与 $S^z_{tot}$ 的关系是 $S^z_{tot} = N_\uparrow - N/2$。所以 $N_\uparrow$ 扇区也常被叫做”$S^z$ 扇区”,编号方式有两种($N_\uparrow$ 或 $S^z$),看代码里怎么定义。
易错:每个扇区的维数 $\binom{N}{N_\uparrow}$ 是”基矢个数“,不是”矩阵大小”;若按稠密存,矩阵大小是它的平方。
易错(什么时候能分桶):只有 $S^z$ 守恒的模型才能这么分桶。加轴向磁场 $h\sum_iS^z_i$ 仍然可以(磁场只改变对角元,不改变扇区);但加横场 $h\sum_iS^x_i$ 就不行了,因为 $S^x$ 不守恒 $S^z$——第一讲的横场 Ising 模型就是这种情况,它的 $U(1)$ 扇区划分要靠费米子变换(Jordan–Wigner)之后才恢复。
Lin 表:两次内存读取
问题是什么? 在 ED 里你会反复问同一个问题:“给定基矢的整数 $i$,它在当前扇区里排第几号(局部下标)?” 例如非对角元 (row, col) 里的 row 是一个整数,但你构造稀疏矩阵时需要的是它在扇区内的行号。
朴素做法是开一个长度 $2^N$ 的查找数组:
index = -np.ones(2 ** N, dtype=int) # -1 表示不在这个扇区 |
对 $N\le24$ 没问题($2^{24} = 1.6\times10^7$ 个整数,约 128 MB);但 $N=40$ 时 $2^{40}$ 个整数要 8 TB,内存就爆了。
Lin 表(H. Q. Lin, Phys. Rev. B 42, 6561 (1990))的想法:既然基矢本身是 $N$ 个比特,把它切成两半(各 $N/2$ 位),分别记为配置 A 和配置 B。那么”查找”就变成
其中 $J_a$、$J_b$ 是两张小表(各约 $2^{N/2}$ 项)。两次内存读取就得到答案,而且表的大小是 $O(2^{N/2})$ 而不是 $O(2^N)$——对 $N=40$,$2^{20}$ 项的表格只要 4 MB。这就是”time and memory efficient”的含义。
一个完整的例子:6 格点 3 上 3 下
把格点切成 A(前 3 个)和 B(后 3 个),于是 $N_\uparrow = N^A_\uparrow + N^B_\uparrow$。扇区总维数是 $\binom63 = 20$。
表 $J_a(I_a)$:A 段内部的名次。 把 A 的 8 种配置按”$\uparrow$ 的个数”分组,组内按整数升序排名,名次从 1 开始:
| $I_a$ | 配置 A | $J_a$ | $\uparrow$ 数 |
|---|---|---|---|
| 7 | 111 | 1 | 3 |
| 3 | 011 | 1 | 2 |
| 5 | 101 | 2 | 2 |
| 6 | 110 | 3 | 2 |
| 1 | 001 | 1 | 1 |
| 2 | 010 | 2 | 1 |
| 4 | 100 | 3 | 1 |
| 0 | 000 | 1 | 0 |
表 $J_b(I_b)$:B 段之前的”累积偏移”。 它等于”在 $I_b$ 之前的所有 B 配置,各自能配多少个 A 配置”的总和:
| $I_b$ | 配置 B | $\uparrow$ 数 | 需配 $\uparrow$ 数 | 可配 A 配置数 $=\binom{3}{3-n_b}$ | $J_b$ |
|---|---|---|---|---|---|
| 0 | 000 | 0 | 3 | $\binom33 = 1$ | 0 |
| 1 | 001 | 1 | 2 | $\binom32 = 3$ | 1 |
| 2 | 010 | 1 | 2 | 3 | 4 |
| 4 | 100 | 1 | 2 | 3 | 7 |
| 3 | 011 | 2 | 1 | $\binom31 = 3$ | 10 |
| 5 | 101 | 2 | 1 | 3 | 13 |
| 6 | 110 | 2 | 1 | 3 | 16 |
| 7 | 111 | 3 | 0 | $\binom30 = 1$ | 19 |
于是 $J = J_a + J_b$ 给出 $1\sim20$ 的全局下标。这正是幻灯片上那四张表的来源(行是 A 配置、列是 B 配置,每张表只对应一种 $N^A_\uparrow$):
| B=000 | B=001 | B=010 | B=100 | B=111 | |
|---|---|---|---|---|---|
| A=111 | 1 = 1+0 | ||||
| A=011 | 2 = 1+1 | 5 = 1+4 | 8 = 1+7 | ||
| A=101 | 3 = 2+1 | 6 = 2+4 | 9 = 2+7 | ||
| A=110 | 4 = 3+1 | 7 = 3+4 | 10 = 3+7 |
完整 20 行(与 Lin 论文 Table II 逐项一致,已数值验证):
| $J$ | A | $I_a$ | $J_a$ | B | $I_b$ | $J_b$ | $J$ | A | $I_a$ | $J_a$ | B | $I_b$ | $J_b$ | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 111 | 7 | 1 | 000 | 0 | 0 | 11 | 011 | 3 | 1 | 100 | 4 | 10 | |
| 2 | 011 | 3 | 1 | 001 | 1 | 1 | 12 | 101 | 5 | 2 | 100 | 4 | 10 | |
| 3 | 101 | 5 | 2 | 001 | 1 | 1 | 13 | 110 | 6 | 3 | 100 | 4 | 10 | |
| 4 | 110 | 6 | 3 | 001 | 1 | 1 | 14 | 001 | 1 | 1 | 101 | 5 | 13 | |
| 5 | 011 | 3 | 1 | 010 | 2 | 4 | 15 | 010 | 2 | 2 | 101 | 5 | 13 | |
| 6 | 101 | 5 | 2 | 010 | 2 | 4 | 16 | 100 | 4 | 3 | 101 | 5 | 13 | |
| 7 | 110 | 6 | 3 | 010 | 2 | 4 | 17 | 001 | 1 | 1 | 110 | 6 | 16 | |
| 8 | 001 | 1 | 1 | 011 | 3 | 7 | 18 | 010 | 2 | 2 | 110 | 6 | 16 | |
| 9 | 010 | 2 | 2 | 011 | 3 | 7 | 19 | 100 | 4 | 3 | 110 | 6 | 16 | |
| 10 | 100 | 4 | 3 | 011 | 3 | 7 | 20 | 000 | 0 | 1 | 111 | 7 | 19 |
结构一目了然:排序是外层按 $I_b$ 升序、内层按 $I_a$ 升序;每个 $I_b$ 块的大小 $=\binom{3}{3-n^B_\uparrow}$(能配上它的 A 配置数,即从前 3 个 A 位里选 $3-n^B_\uparrow$ 个放 $\uparrow$)。幻灯片把 $J=2,3,4$ 标成粉色、$J=11,12,13$ 标成蓝色——这两组正好是”同一个 B 配置(分别是 001 和 100)配三个 A 配置”。
怎么用:给定一个 6 位基矢整数 $i$:
Ia = PickBit(i, 0, 3) # 低 3 位 = 配置 A |
NA = 3 # N = 6, N_up = 3 |
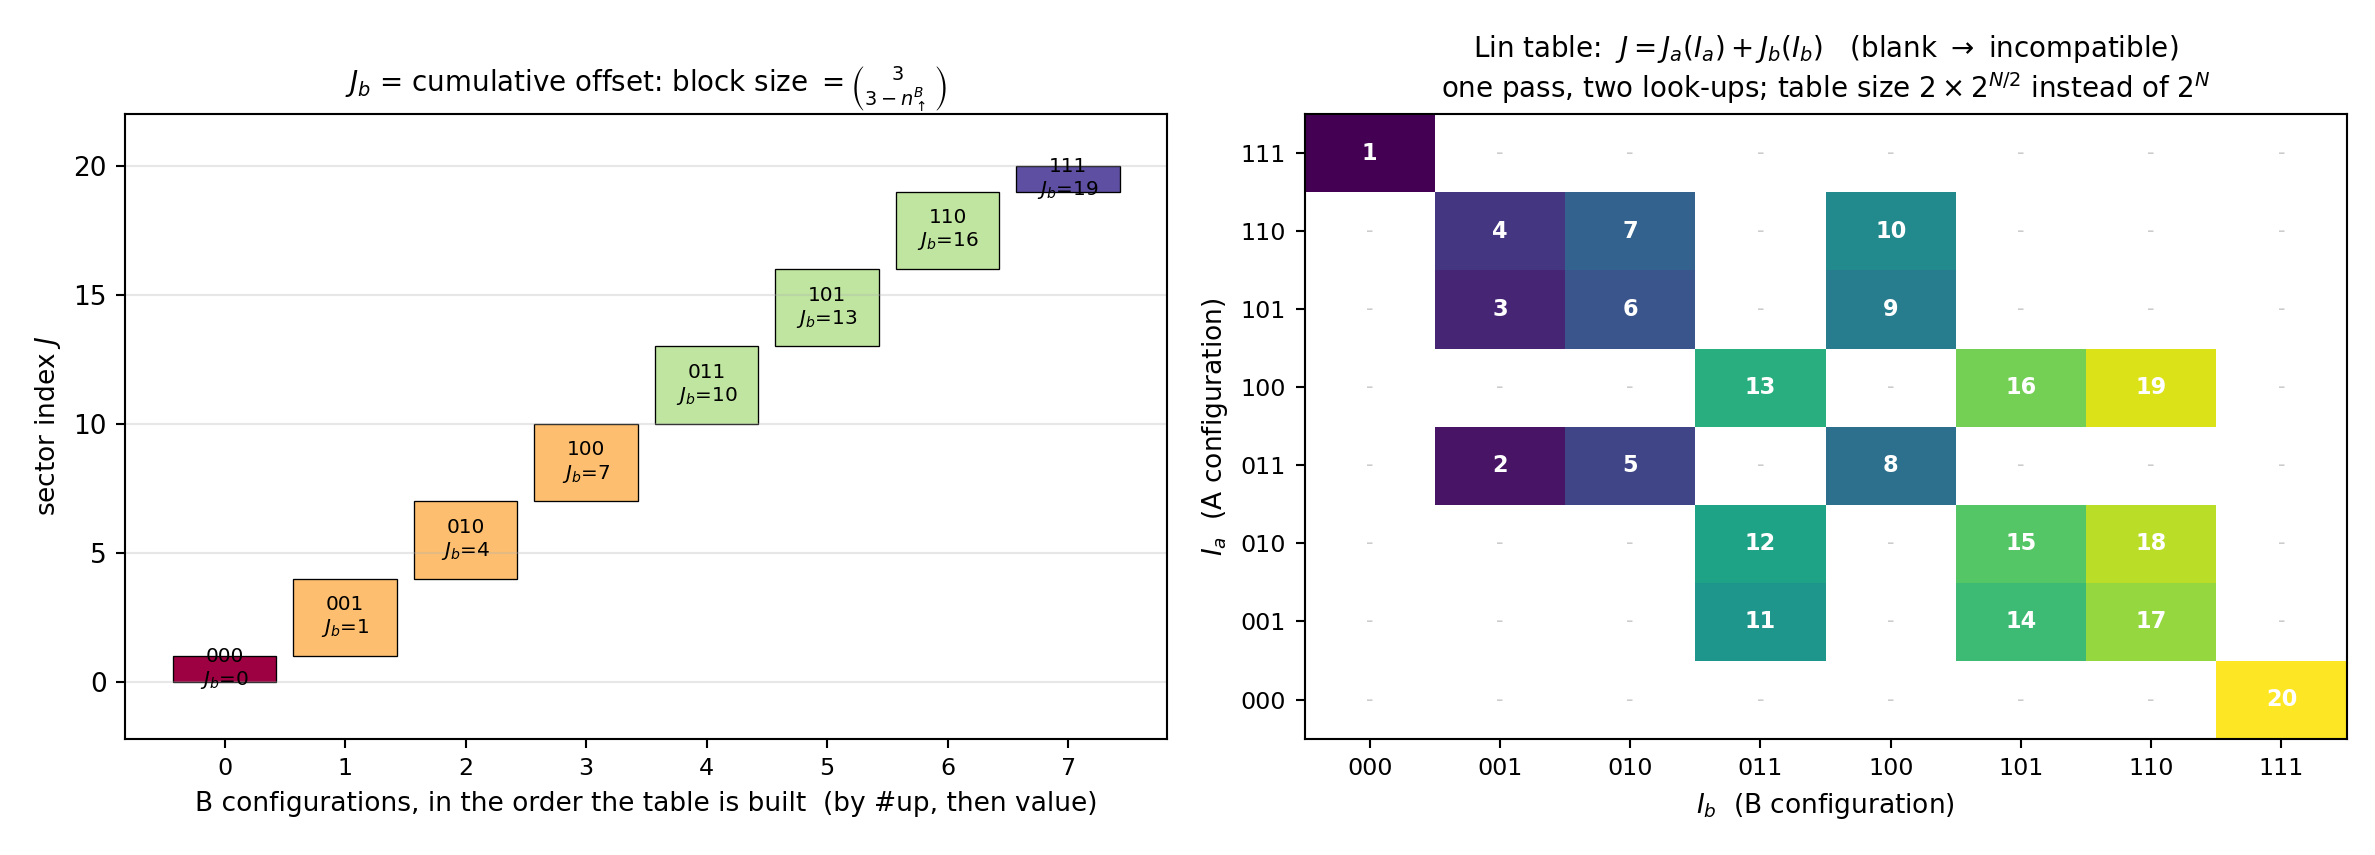
右图这张 $8\times8$ 的表就是讲义第 19–20 页那四张小表的合并版:行是 $I_a$、列是 $I_b$、格子里是 $J$;短横线表示”这个组合凑不出 3 个 $\uparrow$,不合法”。可见 $J$ 从 1 排到 20,而且是按块整齐排列的——同一个 $I_b$ 的三个格子($J=2,3,4$ 或 $11,12,13$)在图上正好并排,这就是讲义里被标成粉/蓝的那两组。
左图把”块”的来历画了出来:$J_b$ 就是前面所有块的大小累加,块的大小 $=\binom{3}{3-n^B_\uparrow}$。例如 $I_b=001$(含 1 个 $\uparrow$)要配 2 个 $\uparrow$ 的 A 段,所以块大小是 $\binom32=3$。
怎么用($O(1)$ 的查找):
Ia = PickBit(i, 0, 3) # 低 3 位 |
对照讲义 Table II 逐项检查:$J=1$ 对应 $(111,000)$、$J=20$ 对应 $(000,111)$、中间 $J=2,3,4$ 是 $I_b=001$ 的三连块——全部吻合。
为什么这样能”两次读取”? 因为 $J_a$ 只依赖 A 段(一张 $2^3=8$ 项的表),$J_b$ 只依赖 B 段(另一张 8 项的表)。表的总大小是 $2\times2^{N/2}$,而不是 $2^N$。
易错(最容易差 1 的地方):$J_a$ 从 1 开始,$J_b$ 从 0 开始——这个”不对称”是故意的:$J_b$ 是”前面的块有多大”(偏移),$J_a$ 是”块内第几个”(名次),两者相加才是从 1 开始的名次。
易错(off-by-one):论文用的是 1-based 下标($J = 1,\dots,20$);写代码时通常要减 1 变成 0-based。这是 Lin 表实现里最常见的 bug。
易错:四张表的行是 A 配置、列是 B 配置(或反之),每张表只对应一种 $N^A_\uparrow$ 的取值。不要试图用一张表覆盖所有情况。
性能:Lin 表只解决”查找”这一件事。它不改变矩阵的稀疏性,也不改变对角化的复杂度;它省的是每次矩阵-矢量乘法里查表的时间。在 $10^9$ 维的问题里,这一项是主要开销。
优化:A/B 的切分点不一定要在正中间。最优切分要平衡两张表的大小和查找次数,常见做法是让 $2^{N_A}\approx2^{N_B}$(即 $N_A\approx N_B$)。
推广(幻灯片底部留的思考题”how about higher spins? bosons?”):
- 高自旋($S=1,3/2,\dots$):每个格点有 $2S+1$ 个态,不再是”一位比特”,需要多个比特或”混合进制”表示;$J_a$、$J_b$ 的构造要推广为”按每段的占据数分布分块”。思路一样,但表要多几维。
- 玻色子(Holstein 模型的声子):每个格点的声子数原则上无上限,必须截断到 $n_{\max}$;”粒子数守恒”仍然是 $U(1)$,所以分块思路仍然适用,但”每段能配多少种 A 配置”要重新算。
费米子系统
Hubbard 模型与算符顺序约定
(第一讲已给;严格说还有 $-\mu\sum_{i\sigma}n_{i\sigma}$。)费米子算符满足反对易关系:
为什么要”固定约定”? 因为反对易关系使得算符的顺序有物理意义:交换两个产生算符会多出一个 $-1$。为了在代码里唯一地确定这个符号,必须事先约定一个标准的算符顺序。本讲选的约定是:所有 $\uparrow$ 的产生算符放在 $\downarrow$ 的产生算符的左边,同一自旋内按格点编号升序。于是 $N=4$ 的例子可以写成
前三个是 $\uparrow$(格点 0, 2, 3),后两个是 $\downarrow$(格点 1, 3)。
比特布局:把整个 $2N$ 位整数分成两段——低 $N$ 位放 $\uparrow$,高 $N$ 位放 $\downarrow$:
验证幻灯片的例子:
- $\uparrow$ 在格点 $\{0,2,3\}$:$n_\uparrow = 2^0+2^2+2^3 = 1+4+8 = 13 = 1101_2$ ✓
- $\downarrow$ 在格点 $\{1,3\}$:$n_\downarrow = 2^1+2^3 = 2+8 = 10 = 1010_2$ ✓
- $n = 13 + 16\times10 = 13+160 = 173 = (10101101)_2$ ✓
这解释了幻灯片上”$\downarrow$ 写在左边、$\uparrow$ 写在右边”的排版:整数写成二进制时高位在左,而高 $N$ 位正是 $\downarrow$。
易错(最容易搞混的一对):“算符串里 $\uparrow$ 在左” 和 “比特串里 $\downarrow$ 在左” 恰好相反,一个是符号约定、一个是整数编码,幻灯片刻意把两者并排展示。不要记混。
重要:Hubbard 模型有两个 $U(1)$ 守恒量——$N_\uparrow$ 与 $N_\downarrow$ 分别守恒(跃迁项 $c^\dagger_{i\sigma}c_{j\sigma}$ 保持 $\sigma$ 不变)。所以扇区数是 $(N+1)^2$,比自旋模型的 $N+1$ 多得多。这也解释了为什么 Hubbard 的 ED 只能做到 20–24 个格点(前面”规模极限”一节)。
带符号的基矢操作
这是本讲最容易写错的一页。核心思想只有一条:
在费米子基矢里插入或删除一个算符时,要数一数”它左边有几个占据的算符”,每有一个就乘一个 $-1$。
这条规则的来源是 Jordan–Wigner 变换(第一讲的二次量子化一节):费米子算符 = 自旋算符 × 一条”符号弦”。
$N$ 格点系统里”有用”的四条操作:
粉色方框突出的是 $\downarrow$ 情形里多出来的那一项 $\sum_{k=0}^{N-1}n_{k\uparrow}$。 逐条看:
- $\uparrow$ 的插入/删除:只数 $\uparrow$ 的占据数。因为按约定所有 $\uparrow$ 都在最左边,插入/删除 $\uparrow$ 时只需要跨过它左边的 $\uparrow$。$c^\dagger_{i\uparrow}$ 插入到第 $i$ 位时,左边有 $\sum_{k<i}n_{k\uparrow}$ 个 $\uparrow$,所以要乘 $(-1)^{\sum_{k<i}n_{k\uparrow}}$。
- $\downarrow$ 的插入/删除:除了跨过左边的 $\downarrow$,还要跨过全部的 $\uparrow$(因为 $\uparrow$ 全部在 $\downarrow$ 的左边),所以要多乘一个 $(-1)^{\sum_k n_{k\uparrow}}$。
用比特语言说:
$\hat H$ 本身也可能带来额外符号。幻灯片给了一个很好的例子:
第一个等号是把 $c_{0\downarrow}$ 作用在 $c^\dagger_{0\downarrow}|0\rangle$ 上(抵消,系数 1);第二个等号是交换两个产生算符要出负号——这正是”标准顺序”约定的意义:只要你把算符重排成标准顺序,符号就自动对了。
易错(最常见的症状):忘记 $\downarrow$ 的那个额外因子 $\sum_k n_{k\uparrow}$。症状是:$\hat H$ 的本征值不对、或者不同扇区之间”看起来”不守恒。
怎么验证:用一个已知答案的小例子。比如 $2$ 格点 Hubbard 的 $U=0$ 极限——单粒子能级必须是单键的 $\pm t$;四格点环 $U=0$ 极限的单粒子能级必须是 $\{-2,0,0,+2\}$(每档 2 个自旋态)。任何符号错误都会立刻破坏它。
易错:”数左边有几个”里的”左边”是指格点编号更小(在标准顺序下),不是指”比特串里更靠左”。本讲约定:算符串顺序是 $\uparrow$ 在前、$\downarrow$ 在后;同一自旋内按格点编号升序。
性能:
PopCntBit在这里再次派上用场——$\sum_{k}n_{k\uparrow}$ 就是”$\uparrow$ 段整段的 popcount”,用一次PopCntBit(n & ((1<<N)-1))就得到。重要:符号必须在”每一次矩阵元计算”里都算一遍,不能只在构造基矢时算一次——因为符号依赖于具体的算符(哪个格点、哪个自旋)。
单一全局比特串:更稳的写法
上面那套”$\uparrow$ 在左、$\downarrow$ 在右 + 额外因子”的约定,正确但容易记错。实践中有一个更稳的写法:用一条全局的 $2N$ 位比特串表示全部自旋轨道,把轨道按全局编号排序。
设自旋轨道编号 $p = i + N\sigma$($\sigma=0$ 为 $\uparrow$,$1$ 为 $\downarrow$),即 bit $0\sim N-1$ 是各格点的 $\uparrow$、bit $N\sim2N-1$ 是各格点的 $\downarrow$。Fock 态按轨道编号递增填充,于是任何产生/湮灭算符携带的符号统一为
即”排在轨道 $p$ 前面的已占据轨道数的奇偶性“。代码就三行:
def create(n, p): # c_p^+ 作用在 |n>,返回 (新态, 符号) |
为什么这个写法更好? 因为跨自旋的相对符号由同一个公式自动给出,不需要手工在张量积里拆分 $S^+S^-$ 时拆正负号——而那正是最容易出错的地方。U(1) 扇区也直接由 popcount(n & 0x3F) 和 popcount(n >> 6) 给出。
两个约定在数学上完全等价(都能给出正确的 $\hat H$),但会给出相差整体符号或扇区内重排的本征矢。同一份代码里必须固定用一种,混用会导致关联函数($\langle S_i\cdot S_j\rangle$ 这类需要 $S^+S^-$ 的量)符号错乱。
本课程的作业($2\times3$ 梯子上的扩展 Hubbard 模型)用的就是这个”单一全局比特串”方案。
求解与测量
怎么把矩阵解出来:完全对角化 vs 迭代对角化
拿到 $\hat H$ 的 $(row,col,value)$ 三元组之后,剩下的问题就是线性代数。这里只讲”选哪种、代价多少”;具体的迭代算法(Lanczos、变分法、格林函数)是第 1 章下半场(ED II)的内容,见下一讲 03 迭代对角化与谱函数。
完全对角化:求出矩阵全部 $D$ 个本征值与全部本征矢。算法是 Householder 三对角化 + 隐式 QR 迭代,代价时间 $O(D^3)$、内存 $O(D^2)$(因为要存下 $D\times D$ 的本征矢矩阵)。
迭代对角化:只求少数几个本征值。核心是”矩阵-矢量乘法 + 子空间迭代”,不需要矩阵元,只需要 $\hat H$ 对矢量的作用——这正是前面”程序结构”里 needs only operations 的含义。迭代次数通常只有几十到几百,每次矩阵-矢量乘法 $O(\mathrm{nnz})$,总时间大致 $O(D)$ 到 $O(D^2)$,而内存降到 $O(D)$。
| 完全对角化 | 迭代对角化 | |
|---|---|---|
| 时间 | $O(D^3)$ | $O(D)\sim O(D^2)$ |
| 内存 | $O(D^2)$ | $O(D)$ |
| 得到什么 | 全部 $D$ 对 $(\{E_n\},\{\lvert\psi_n\rangle\})$ | 指定的少数几个(如最低 $k$ 个) |
| 适用 | $D\lesssim10^4$ | $D\lesssim10^{9}$(配合对称性与稀疏性) |
具体的内存账:$D=2^{12}=4096$ 时,本征矢矩阵要 $4096^2 = 1.7\times10^7$ 个复数(双精度 16 字节)约 270 MB,时间是秒级。$D=2^{16}=65536$ 时,本征矢矩阵要 $65536^2\times16\ \mathrm{B} = \mathbf{68\ GB}$——内存就爆了。所以”完全”对角化只适用于小系统。
什么时候需要全谱? 这决定了前面”完备性”那条理由的实际价值:
| 你想算什么 | 需要全谱吗 |
|---|---|
| 基态能量、基态关联函数 | ✗ 只要最低几个本征对 |
| 有限温度、态密度、力学量比热 | ✓ 必须全谱($Z$ 要遍历所有本征值) |
| 动力学谱函数 $A(\mathbf k,\omega)$ | ✓ 全谱(除非只算低能部分) |
| 实时演化 $e^{-i\hat Ht}$(谱分解) | ✓ 全谱(或用 Krylov 近似) |
| 熵、自由能 | ✓ 全谱 |
matrix-free:只保留 $\hat H v$ 这个操作。连稀疏矩阵都不存,只写一个 apply_H(v) -> H @ v。内存只要 $O(D)$(几个矢量),代价是每次”作用”都现场算一遍。这在 $D=10^9$ 时是生死之别,而且允许把 $\hat H$ 按对称性扇区分块作用、或用矩阵乘积算符(MPO)的形式给出——这是 DMRG 与 ED 的接口。
易错(matrix-free 最大的风险):没有矩阵可以检查厄米性。如果
apply_H写错了,求解器会给出看起来正常但实际错误的结果。对策:先在小系统上用稀疏/稠密版本验证同一个apply_H是对的(对 $\hat H v$ 逐元素比对),再上大系统。易错:迭代求基态要用代数最小(smallest algebraic)作为收敛判据。用”最小模”(smallest magnitude)对最小本征值收敛极慢甚至失败——这是初学者最常见的性能坑。
易错:迭代算法默认用随机初值,所以每次运行结果会有 $10^{-12}$ 量级的微小差异。要完全可复现,给它一个固定的初始矢量。
有限温度:白送的热平均
有限温度在 ED 里是”白送“的——因为你已经拿到了全部本征值与本征矢:
这是 ED 相对于 DMRG/QMC 的一大优势:DMRG 只能给低能态,QMC 在有限温度要做虚时间演化,而 ED 只要谱在手,任意温度、任意观测量都是几行代码。
例子:4 格点环 Hubbard 的填充曲线
用
(注意这里的 $J$ 是跃迁振幅,一般文献写成 $t$——同一个字母在前面”哈密顿量矩阵的构造”一节是 Heisenberg 交换、在这一节是 Hubbard 跃迁,看公式里有没有 $c^\dagger c$ 就能区分。)
电荷密度:
$U=0$ 时阶梯为什么出现在 $\mu = -2, 0, +2$? 4 格点环的紧束缚能级是 $\varepsilon_k = -2J\cos(2\pi k/4)$,$k=0,1,2,3$,
(实测确认)。每个能级带 2 个自旋自由度,所以:
| $\mu$ 区间 | 填充的电子数 | $\langle n\rangle$ |
|---|---|---|
| $\mu < -2$ | 0 | 0 |
| $-2 < \mu < 0$ | 2($k=0$ 能级) | 0.5 |
| $0 < \mu < 2$ | $2+4 = 6$(加上简并能级) | 1.5 |
| $\mu > 2$ | 8 | 2 |
这就是幻灯片上那个三级阶梯,跳跃位置正好是能带边 $\pm2$ 和简并能级 0(已数值验证)。右侧的能带示意图画的就是这个图像。
$U$ 增大后发生了什么? 库仑排斥把能级推开、产生关联能隙。数值验证(4 格点环,$T\to0$,$J=1$):
| $U$ | $\langle n\rangle = 1$(半满)的平台范围 | 平台宽度 |
|---|---|---|
| 0 | (无平台) | 0 |
| 2 | $\mu\in[0.5,\ 1.5]$ | 1.0 |
| 4 | $\mu\in[0.75,\ 3.25]$ | 2.5 |
| 10 | $\mu\in[1.25,\ 5.0]$ | 3.75 |
平台宽度随 $U$ 单调增长、趋向带宽 $W = 4J = 4$(有限尺寸效应)。半满时的 Mott 平台就是第一讲讲的 Mott 绝缘体:$\mu$ 在能隙里变化时填充不变。 对应的电荷能隙(固定 $N$ 扇区的精确结果):
| $U$ | $E_0(3)$ | $E_0(4)$ | $E_0(5)$ | $\Delta_c$ |
|---|---|---|---|---|
| 0 | $-4.0000$ | $-4.0000$ | $-4.0000$ | 0.0000(金属) |
| 2 | $-3.2093$ | $-2.8284$ | $-1.2093$ | 1.2384 |
| 4 | $-2.7522$ | $-2.1027$ | $+1.2478$ | 2.7012 |
| 8 | $-2.3246$ | $-1.3202$ | $+5.6754$ | 5.9914 |
| 12 | $-2.1407$ | $-0.9391$ | $+9.8593$ | 9.5967 |
$U=0$ 时能隙严格为零(4 格点环半满确实是金属,费米面落在 $\varepsilon=0$ 的简并能级上),$U$ 一开就出现正能隙并趋于 $U$。这在 4 个格点上就完整复现了第一讲的”Mott 绝缘体”物理。
NS, bonds = 4, [(0, 1), (1, 2), (2, 3), (3, 0)] |
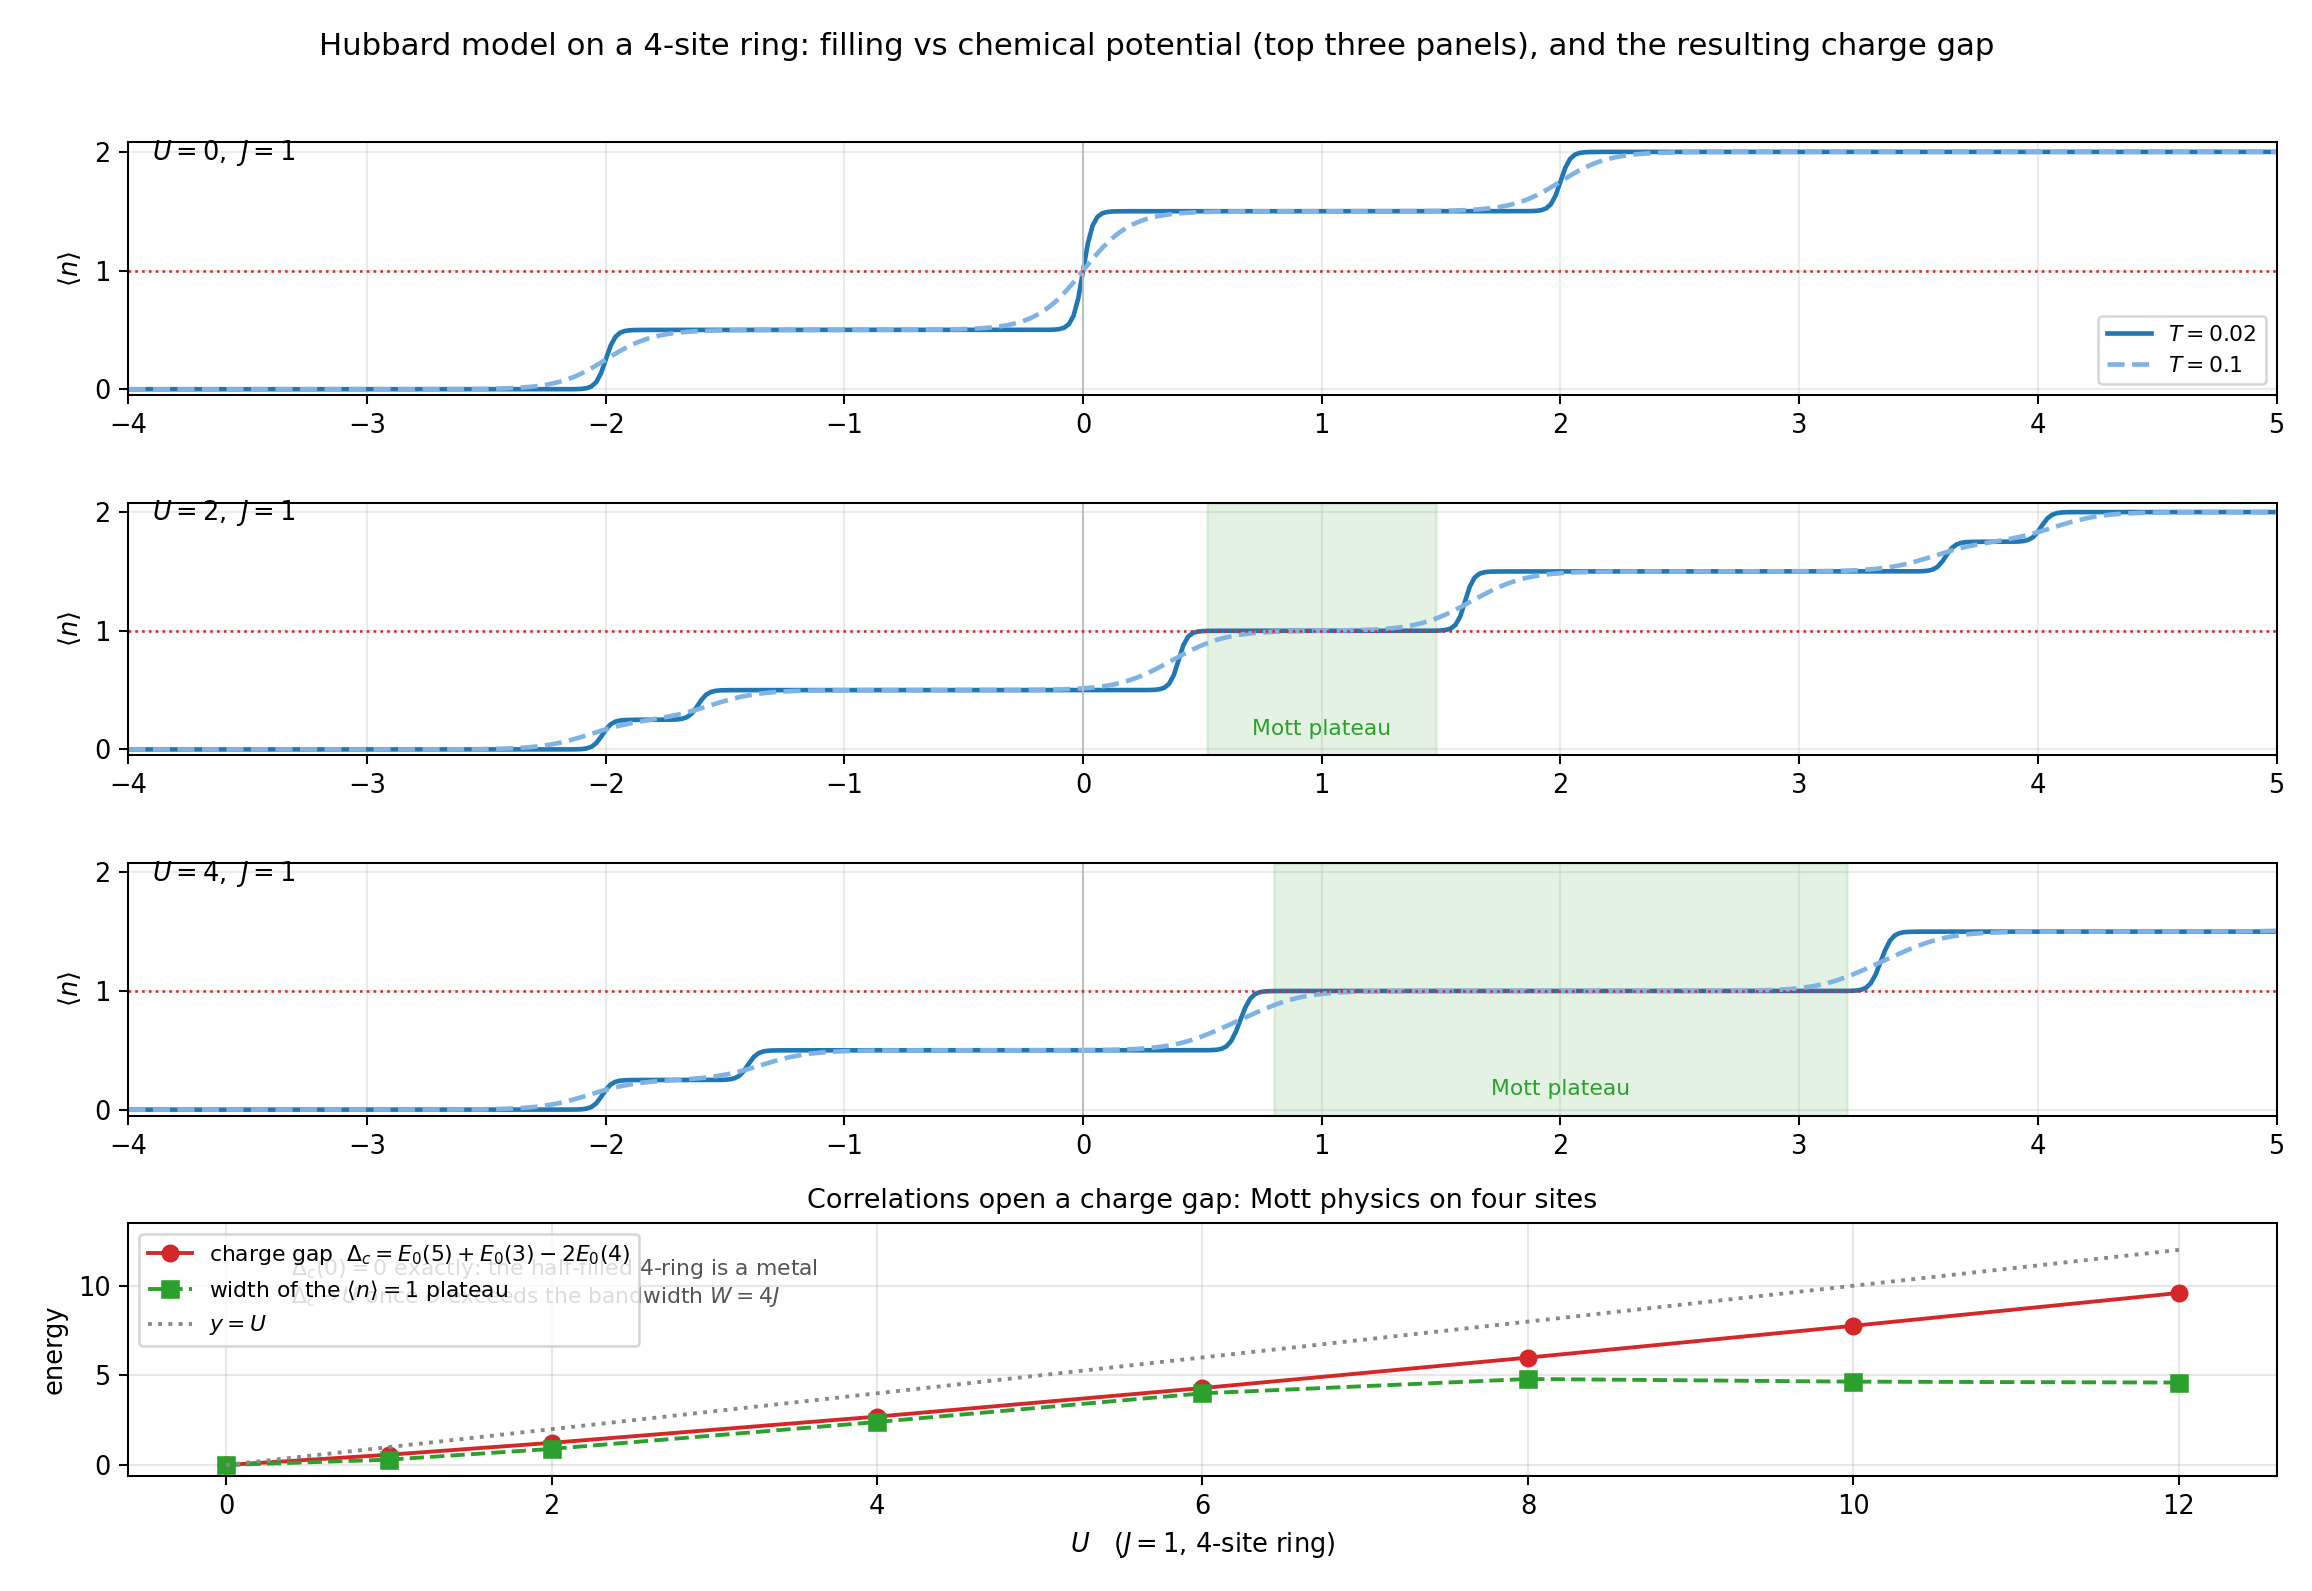
上面三幅就是讲义第 23 页那三张图($U=0,2,4$),实线 $T=0.02$、虚线 $T=0.1$:
- $U=0$:三级阶梯,跳跃点在 $\mu=-2,\ 0,\ +2$,平台高度 $0,\ 0.5,\ 1.5,\ 2$。这是能带论的答案:能级是 $-2,0,0,+2$,每个带 2 个自旋态。虚线($T=0.1$)把阶梯抹圆——这就是”有没有能隙”的实验判据。
- $U=2$:台阶变多、变平,半满处出现一个 $\langle n\rangle=1$ 的平台。
- $U=4$:平台拉长到 $\mu\in[0.75,\ 3.25]$,宽度 2.5,向 $U$ 靠拢但受带宽 $W=4J$ 限制。
最下面把这件事翻译成能量:电荷能隙 $\Delta_c$ 在 $U=0$ 时严格为零(半满 4 环确实是金属,费米面就落在 $\varepsilon=0$ 的简并能级上),$U$ 一开就变正并趋向 $U$。第一讲说”Mott 绝缘体的能隙完全来自相互作用”,这 4 个格点就是完整的证明。
一个容易写错的地方(我在写这段代码时踩到了):$\langle n\rangle$ 是对角算符 $N=\hat n$ 在本征态里的期望值,不是 $\hat H$ 的本征值。所以要写 $\sum_n p_n\sum_m |v_{mn}|^2 n_m$,代码里就是
p @ ((v**2).T @ Nop)——那个.T不能省。省掉它算出来的是”用 Fock 态编号当权重”的垃圾,但对角线那一项看起来还挺合理,很容易蒙混过关。
“温度”的作用:虚线($T=0.1$)把阶梯”抹圆”了。在 $\beta\Delta E\gg1$ 时 $T=0.01$ 的实线几乎就是 $T=0$ 的阶梯;温度升高后热激发越过能隙,阶梯变成平滑曲线。这是区分”能隙”和”无能隙”的一个实验判据。
易错:$\langle n\rangle$ 的取值在 $[0, 2]$(每格点最多 2 个电子),不是 $[0,1]$。算出来超过 2,一定是算符定义错了。
易错:完全对角化才”白送”有限温度。如果只做 Lanczos(只求少数低能态),高温下需要很多态才收敛,这时要改用有限温度 Lanczos(FTLM)或典型态方法(TPQ)。
易错:加化学势 $\mu$ 只改变对角元($-\mu\sum n$),不改变扇区结构,所以可以在每个 $(N_\uparrow,N_\downarrow)$ 扇区里独立算,然后按 $\mu$ 加权汇总。
磁化与磁化率
$a$、$b$ 两个子格的总磁化:
均匀磁化(铁磁序的序参量)与交错磁化(反铁磁序的序参量):
- $m_u$ 是整个体系的净磁矩,对应均匀外场 $h\sum_iS^z_i$ 的响应;
- $m_s$ 是 $a$、$b$ 子格的反号之和,对应交错场 $h\sum_i(-1)^iS^z_i$ 的响应。
磁化率 $\chi = \left.\frac{dm}{dh}\right|_{h=0}$。幻灯片给的是用涨落表示的公式(涨落–耗散定理的特例):
即一般地 $\chi = \frac{\beta}{N}\mathrm{Var}(M)$。这个公式极其有用:它把”对外场的响应”变成了”零场下的涨落”,不需要真的加磁场,只要在 $h=0$ 下算 $M^2$ 的热平均即可。推导(一行):
图里的物理:居里定律
幻灯片的图是 $2\times2$ Hubbard 模型(4 个格点的最小方格)、$J=1$、$U=30$、$\mu=1.5$,画的是 $1/\chi$ 对 $T$。强 $U$ + 接近半满 $\Rightarrow$ 每个格点近似有一个局域磁矩。局域磁矩的标志就是居里定律 $\chi = C/T$,即 $1/\chi \propto T$(直线)。数值验证:
| $T$ | $1/\chi_u$ | $1/\chi_s$ |
|---|---|---|
| 0.5 | 2.51 | 2.14 |
| 1.0 | 5.02 | 4.55 |
| 2.0 | 10.39 | 9.90 |
| 3.0 | 16.06 | 15.58 |
| 5.0 | 27.77 | 27.33 |
| 7.0 | 39.82 | 39.41 |
| 10.0 | 58.61 | 58.25 |
线性拟合 $1/\chi \approx 5.91\,T - 1.18$,即 $C \approx 0.169$、$\Theta_{CW} \approx +0.20$。与幻灯片的图一致:$1/\chi$ 随 $T$ 近似线性上升,$T=10$ 时约 57–59,两条曲线几乎重合。
NS, bonds = 4, [(0, 1), (1, 2), (2, 3), (3, 0)] |
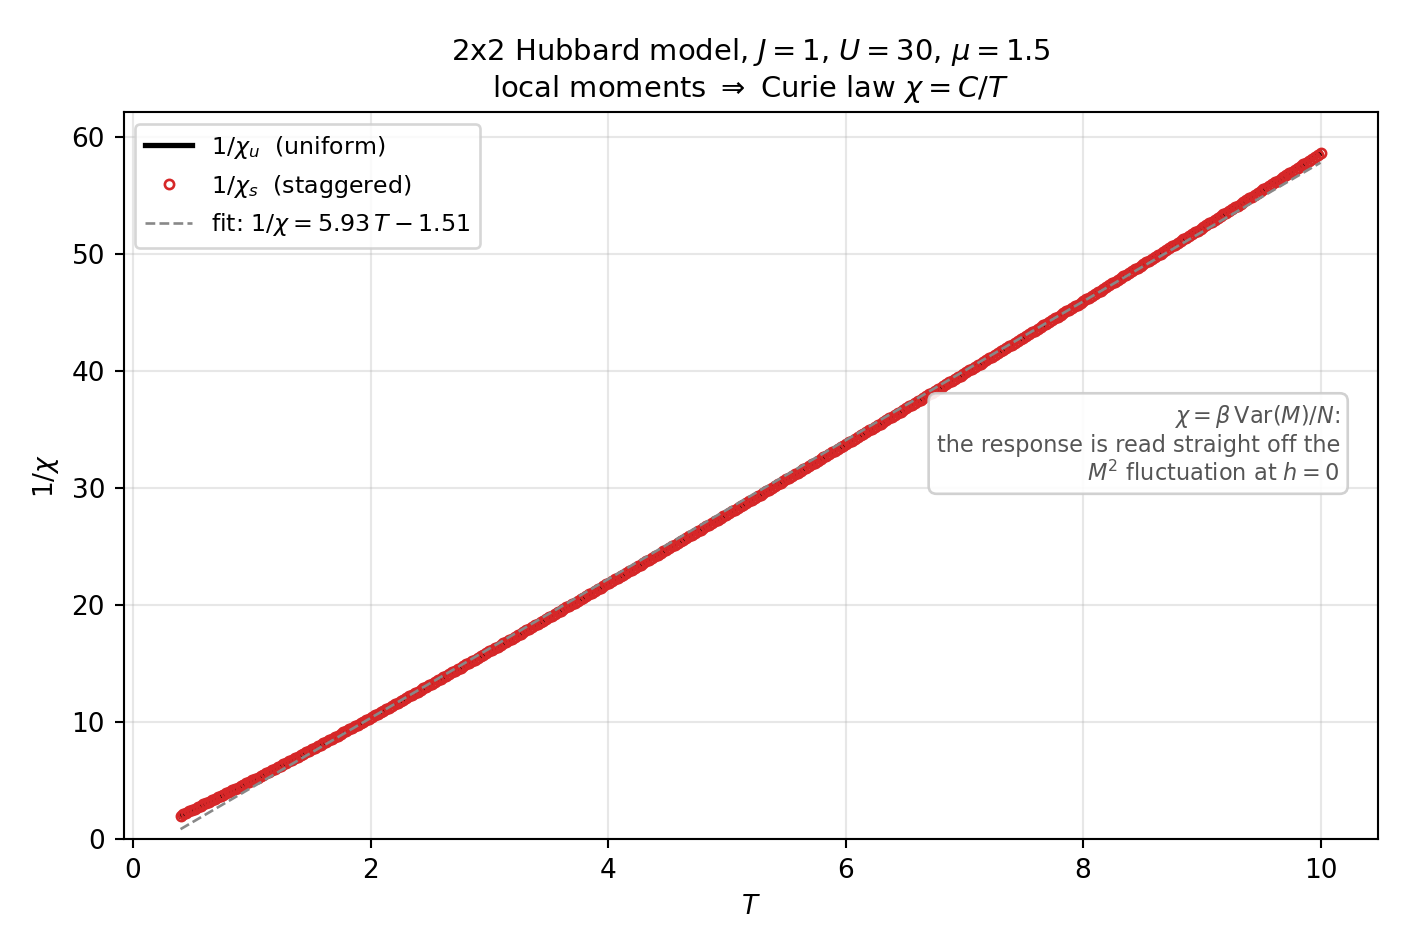
读图:$1/\chi$ 是一条直线——这就是居里定律 $\chi=C/T$,直线的斜率是 Curie 常数(拟合得 $C\approx0.169$),截距给出 Curie–Weiss 温度($\approx+0.2$,弱铁磁倾向)。$T=10$ 时 $1/\chi\approx58$,与讲义图上的”约 57”一致。
为什么这条直线是”强关联”的证据? $U=30$ 配 $\mu=1.5$ 让每个格点近似带一个局域磁矩,而 $\chi=\beta\mathrm{Var}(M)/N$ 里 $\chi\propto1/T$ 等价于”$\mathrm{Var}(M)$ 不随温度变“——这正是自由局域磁矩的定义。——对比 $U=0$:那时电子是 itinerant 的,$\chi$ 趋于 Pauli 常数,$1/\chi$ 会趋于 0 而不是直线上升。
黑线与红圈几乎重合,说明在这个小簇上均匀与交错磁化率差别很小($2\times2$ 太小,反铁磁关联还没长出来)。在大格子上两者才会分开:$1/\chi_s$ 外推到正截距(Néel 温度 $T_N$),$1/\chi_u$ 外推到负截距($\Theta_{CW}<0$)。
为什么 $\chi_u$ 与 $\chi_s$ 几乎重合? 因为 $2\times2$ 太小,反铁磁关联还没来得及”长出来”。在大格子上,$1/\chi_s$ 会外推到正的截距(Néel 温度 $T_N$),而 $1/\chi_u$ 外推到负的截距(Curie–Weiss 温度 $\Theta_{CW}<0$)。
这就是 ED 算磁化率的套路:小簇上算 $\langle M^2\rangle$,得到 $1/\chi(T)$,再外推(或做有限尺寸标度)到热力学极限。
易错:$1/\chi$ 的斜率给出 Curie 常数 $C$,截距给出 Curie–Weiss 温度。判断”是否形成长程序”看截距的符号:正截距 = 反铁磁($\chi_s$),负截距 = 铁磁($\chi_u$)。
易错:公式里的 $\beta = 1/(k_BT)$,所以 $\chi\propto1/T$ 的居里定律在 $\chi = \beta\,\mathrm{Var}(M)/N$ 里就是”$\mathrm{Var}(M)$ 不随 $T$ 变化“——这正是”自由局域磁矩”的特征。
易错:$M_a$、$M_b$ 的定义依赖二分格子。三角格子、笼目格子不是二分格,”交错磁化”要用更一般的波矢(例如 $\sqrt3\times\sqrt3$ 序)。
实时演化
形式解与 Krylov 加速
含时薛定谔方程支配演化:
$\hat H$ 不显含时间时,”积分”一次得到形式解:
关键观察:指数算符 $e^{-i\hat Ht/\hbar}$ 在能量本征基里是对角的! 把初态按本征态展开 $|\psi(0)\rangle = \sum_n C_n|\psi_n\rangle$,每个分量只是乘上一个相位:
这就是”ED 做实时演化”的全部原理:一旦有谱,演化就是”给每个分量转相位”。
但为什么还要 Lanczos? 因为对 $D=10^9$ 的系统,既不能完全对角化,也不能直接把 $e^{-i\hat Ht}$ 的矩阵作用上去。这时用 Krylov 方法:
- 以 $|\psi(0)\rangle$ 为起点,构造 Krylov 空间 $\mathcal K_m = \mathrm{span}\{|\psi_0\rangle, \hat H|\psi_0\rangle, \hat H^2|\psi_0\rangle, \ldots, \hat H^{m-1}|\psi_0\rangle\}$;
- 在这个 $m$ 维小空间里把 $\hat H$ 三对角化(Lanczos),得到一个小矩阵 $T_m$;
- 在小空间里做 $e^{-iT_mt}$($m\times m$ 矩阵,$m\le20$ 就够);
- 投影回去得到 $|\psi(t)\rangle$。
为什么 $m\le20$ 就够? 因为短时间演化只需要低能谱的信息,而 Krylov 空间天然地”捕获”了与初态耦合最强的那些本征分量。时间越长需要的 $m$ 越大;但即使如此 $m\sim10^2$ 也远小于 $D$。
易错:$e^{-i\hat Ht/\hbar}$ 是幺正的($\hat H$ 厄米时),所以总概率守恒:$\big|\,|\psi(t)\rangle\big| = 1$。如果你的数值结果范数漂移,说明算法不稳——这是一个免费的检查。
易错:注意 $C_n = \langle\psi_n|\psi(0)\rangle$ 的共轭顺序:”本征态在左、初态在右”。写反了相当于算 $\langle\psi(0)|\psi_n\rangle = C_n^$,*相位方向反了。
易错:时间步长——用谱分解时 $t$ 可以任意大(相位是精确的);用时间步进(Crank–Nicolson、Runge–Kutta)时,步长受 $\Delta t\lesssim1/|\hat H|$ 限制。
实例一:高斯波包与色散
一维紧束缚环(玻色/单自旋费米都行):
初态是一个高斯波包:
($N_0$ 是包中心,$\alpha$ 控制宽度——$\alpha$ 小则包宽、$\alpha$ 大则包窄,$\Omega$ 是归一化常数。)
傅里叶变换后色散为 $\varepsilon_k = -2J\cos k$,$k = 2\pi m/N$,带宽 $W = 4J$。群速度:
这解释了幻灯片上两幅图的全部差别:
| 初态 $k_0$ | $v_g$ | 物理图像 |
|---|---|---|
| $0$(带底) | $0$ | 波包不动,但会扩散(色散) |
| $\pi/2$(拐点) | $2J$(最大) | 波包以最大速度弹道传播 |
实空间越窄 ⇒ 动量空间越宽(傅里叶变换的不确定性关系),这正是中间那两张”棒棒糖”图宽度不同的原因。
# 注意:单粒子在 N 个格点上,希尔伯特空间只有 N 维 -> 完全对角化是白送的 |
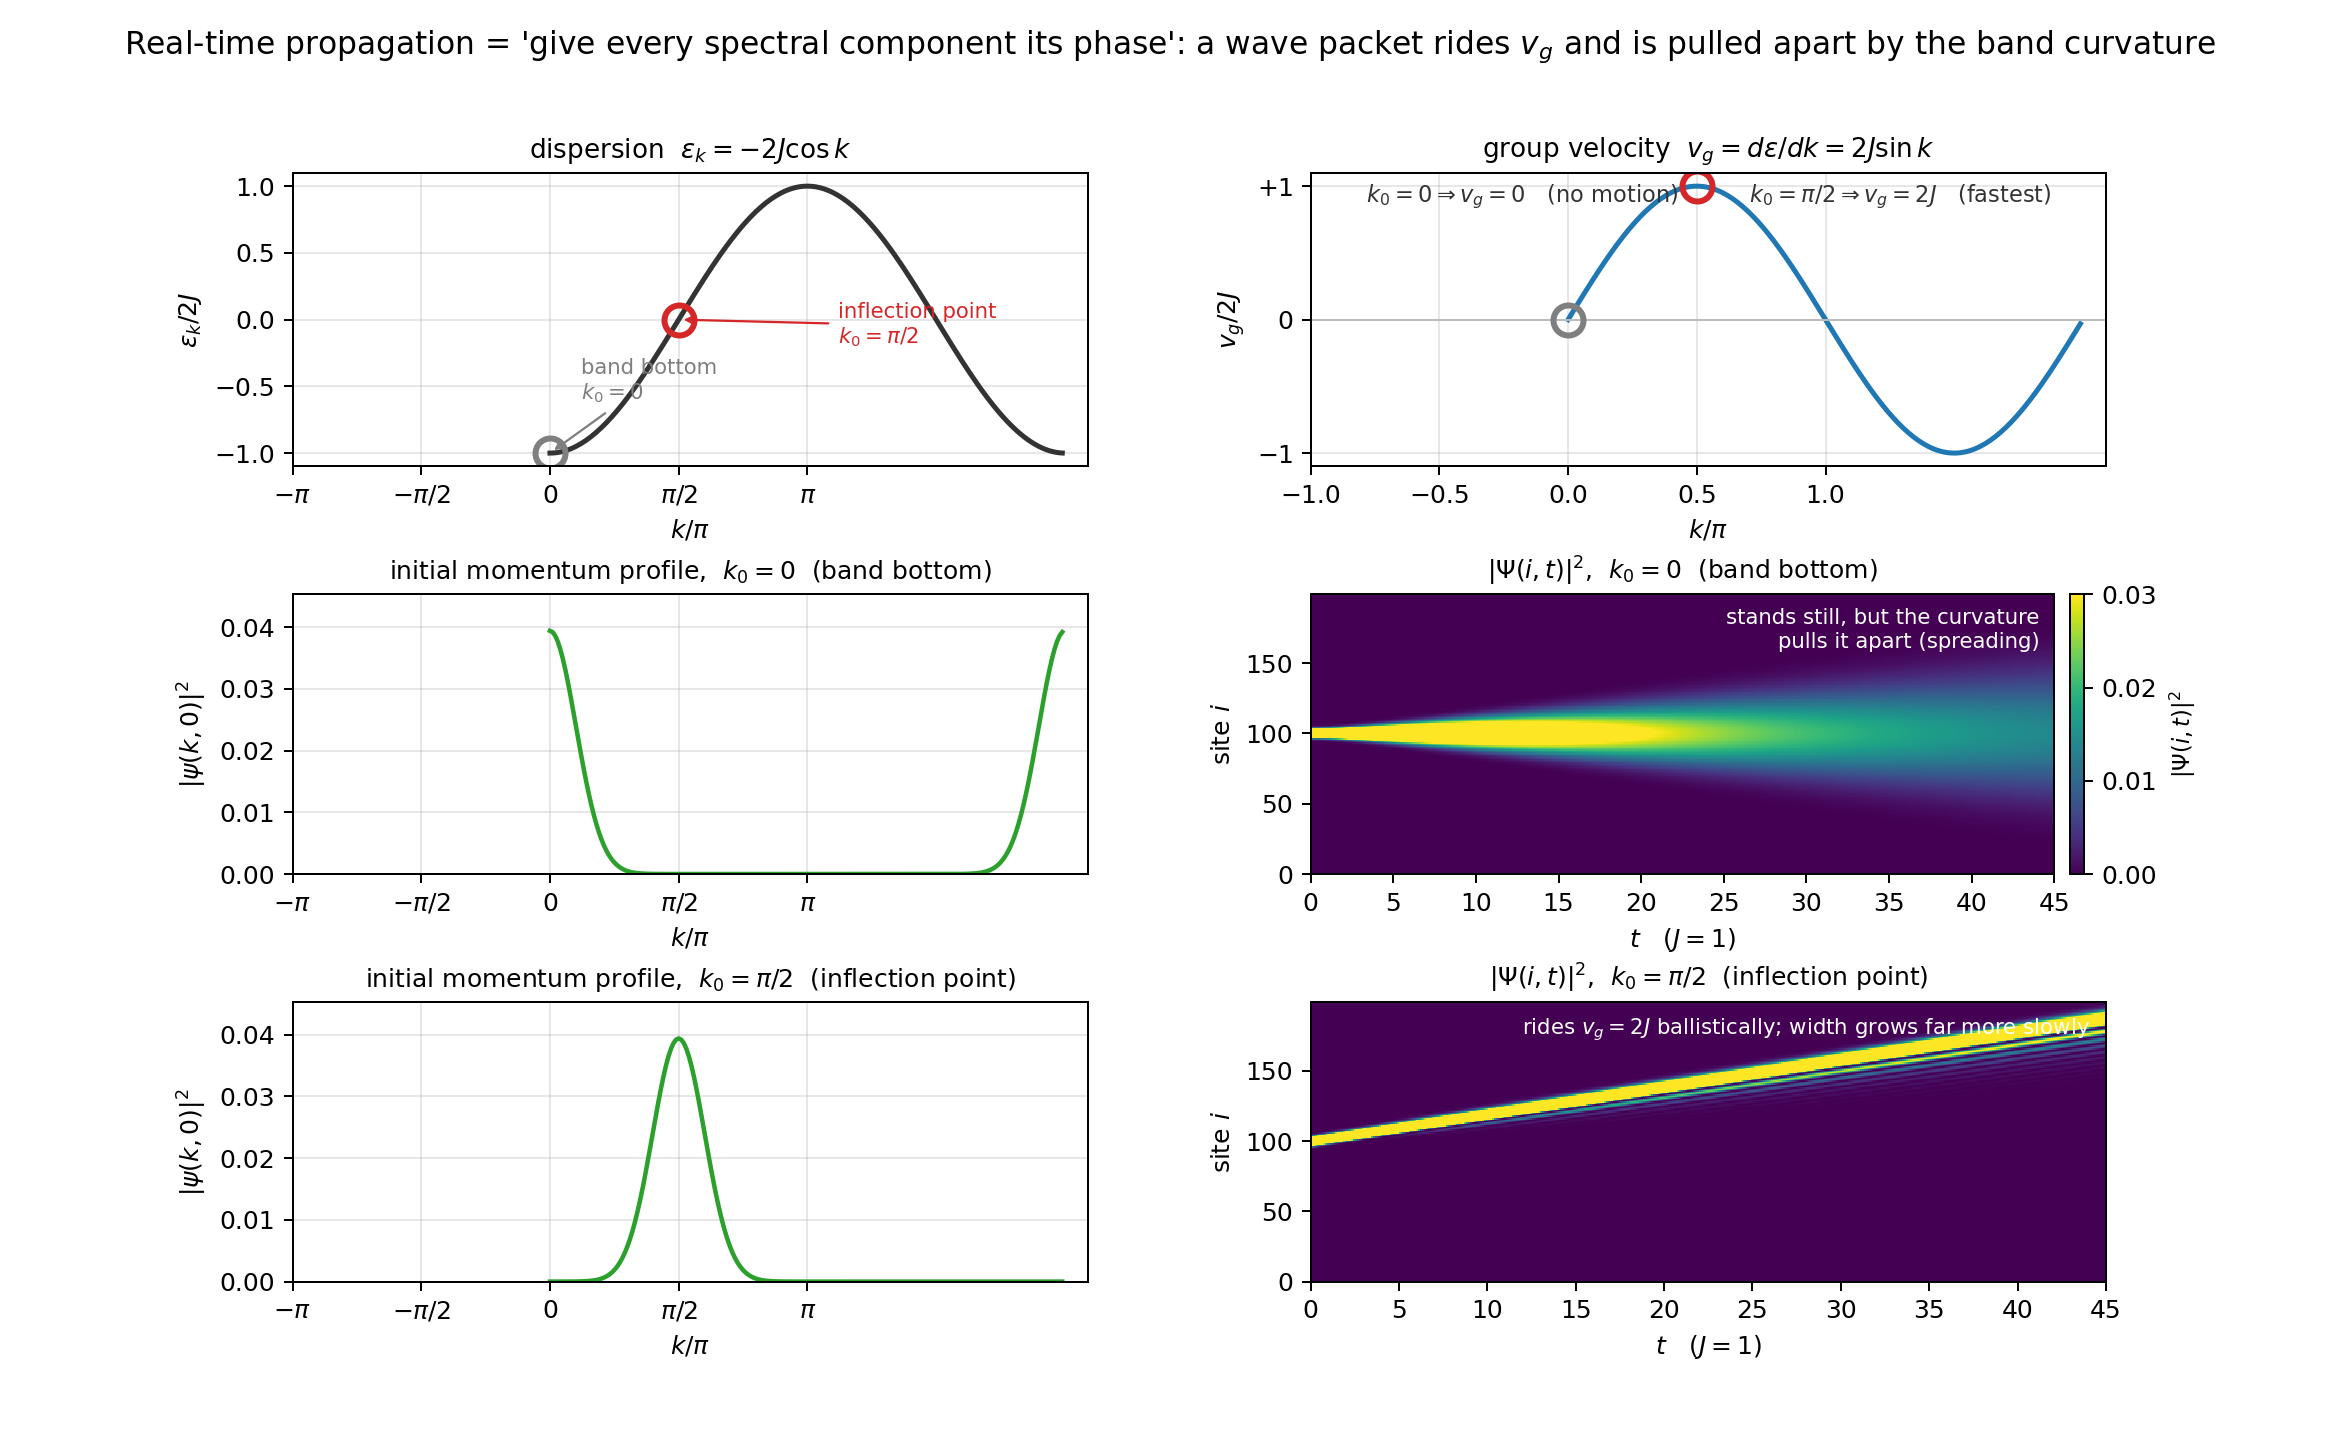
这里有一个漂亮的”数值 $\to$ 物理”闭环:单粒子在 $N$ 个格点上,希尔伯特空间只有 $N$ 维(不是 $2^N$!),所以 $N=200$ 的”完全对角化”是白送的——$200\times200$ 的稠密矩阵,毫秒级。实时演化的每一步都是精确的,没有任何数值误差。
读图(四行两列):
- 第一行左:色散 $\varepsilon_k=-2J\cos k$,红圈在 $k_0=\pi/2$(拐点,$\varepsilon=0$),灰圈在 $k_0=0$(带底,$\varepsilon=-2J$)。
- 第一行右:群速度 $v_g=2J\sin k$。灰圈 $v_g=0$、红圈 $v_g=2J$(最大)。
- 第二行:$k_0=0$。动量分布窄而高、集中在带底;热图上波包原地不动、但随时间从亮线慢慢摊开。
- 第三行:$k_0=\pi/2$。动量分布宽而矮;热图上波包以最大速度斜着跑过去,而且几乎不散开。
物理解读:散不散开只取决于包在动量空间有多窄 + 色散有多弯。$k_0=0$ 处色散有极大曲率($d^2\varepsilon/dk^2=2J\cos0=2J\neq0$),包内不同 $k$ 的速度差 $\sim2J\,\delta k$ 把它撕开;$k_0=\pi/2$ 处曲率恰为零($\cos\pi/2=0$),色散在拐点附近是线性的,所有分量速度相同 $\Rightarrow$ 刚性平移。
易错:幻灯片图上 $\varepsilon_k$ 的纵轴只画到 $\pm1$,而公式给出 $\varepsilon_k = -2J\cos k$。也就是说图里画的是 $\varepsilon_k/2J = -\cos k$(纵轴以带宽的一半为单位)。关键不是刻度,而是形状:最小值在 $k=0$、最大值在 $k=\pm\pi$、拐点在 $k=\pm\pi/2$。
实例二:非扩散波包与飞行量子比特
环上穿一个磁通 $\Phi$(Peierls 替换):
沿环走一圈相位累积 $2\pi\Phi$,效果等价于给波包一个动量 $k_0 = 2\pi\Phi/N$。
“非扩散波包”(non-spreading wave packet)是这一页的核心物理。一般的高斯波包会扩散(不同 $k$ 分量的群速度不同,包会越变越宽)。但在这条余弦能带上,如果初态是”动量空间的高斯包”并选择合适的 $k_0$,波包在传播过程中几乎不扩散:
- 在拐点附近($k_0\approx\pi/2$),色散近似线性:$k=\pi/2$ 处展开 $\varepsilon_k = -2J\cos k \approx 2J(k-\pi/2)$,线性色散意味着所有分量速度相同($v_g = 2J$)$\Rightarrow$ 不扩散;
- 更准确地说,这是一个”自相似”的相干态,其形状在演化中保持不变。
幻灯片上的 3D 曲面图 $|\Psi(i,t)|^2$ 画得很清楚:一条沿对角线的窄脊,波包从 $i\approx1$ 出发随时间平移到 $i\approx100$,脊的宽度几乎不变。
“固态飞行量子比特”(solid-state flying qubit)是把这件事推向应用的设想:用一个不扩散的波包(例如自旋 $\uparrow/\downarrow$ 两个分量)在固体里传输量子信息。这是本讲授课教师本人的 2006 年工作(S. Yang, Z. Song, C. P. Sun, Phys. Rev. A 73, 022317 (2006))。
量级估计:$v_g = 2J\sin k$ 在 $k_0=\pi/2$ 处是 $2J$(格点/单位时间)。绕 100 格点的环跑一圈需要 $100/2J = 50/J$,对应图上 $t=0.5$。所以 $t\in[0,1]$ 大致是”绕环两圈”的演化,波包会与自身相遇、干涉。
易错:幻灯片的图注写的是 “zero-momentum GWP”($k_0=0$),但同一图注又给了 $\Phi = N/4$,而正文 $k_0 = 2\pi\Phi/N$ 会把 $\Phi=N/4$ 换算成 $k_0 = \pi/2$。这两者不自洽,很可能是引用论文图注时把另一幅图的文字一起抄了过来。读图时以 $\Phi=N/4$、$k_0=\pi/2$ 为准(图里那个波包明显在跑,不是静止的)。
概念辨析:磁通的作用不是”只改一个相位”。Peierls 替换把跃迁相位 $e^{i2\pi\Phi/N}$ 引进哈密顿量,等价于把能带整体在动量空间平移,于是波包的中心动量变成 $k_0 = 2\pi\Phi/N$,群速度随之改变。(单粒子概率密度确实对规范变换不变,但那是”换规范”,不是”换磁通”——换磁通是换物理。)
实例三:自干涉与量子复兴
开边界条件下,波包演化会产生三个现象:
- 开边界的反射与 $\pi$ 相移。在开边界处波包被反射。对这条链($\varepsilon_k = -2J\cos k$,$k_0 = \pi/2$),反射会带来一个 $\pi$ 的相位跳变——示意图里那个倒置的波包就是它。这个 $\pi$ 相移是”硬壁边界条件”的普遍特征(与无限深势阱里波函数在壁上为零同理)。
- 自干涉(self interference)。因为系统有限,波包绕一圈(或反射回来)后会与”自己”相遇并干涉,于是 $|\Psi(i,t)|^2$ 出现振荡条纹。
- 量子复兴(quantum revival)。有限系统的能谱是离散的,所以演化是准周期的:经过一段时间后各个相位 $e^{-iE_nt}$ 重新对齐,波包恢复到初始形状。复兴时间由能谱的(近似)等间距决定:面板 (c) 的时间范围($0\sim8$,单位 $100/J$)比 (a)(b) 大一个量级,正是为了看到复兴。
物理意义:
- 三者都是有限尺寸效应的直接可视化,也是”为什么小系统不能用热力学极限的语言描述”最好的例子;
- 量子复兴在冷原子、超导量子比特、离子阱里都已经被实验观测到,是”量子相干性”的漂亮演示;
- 反射的 $\pi$ 相移 + 自干涉合起来说明:在有限链上,”飞行量子比特”必须考虑边界的相干反射——这是把上一节的设想变成器件时要解决的问题。
N, k0, alpha = 100, np.pi / 3, 20.0 |
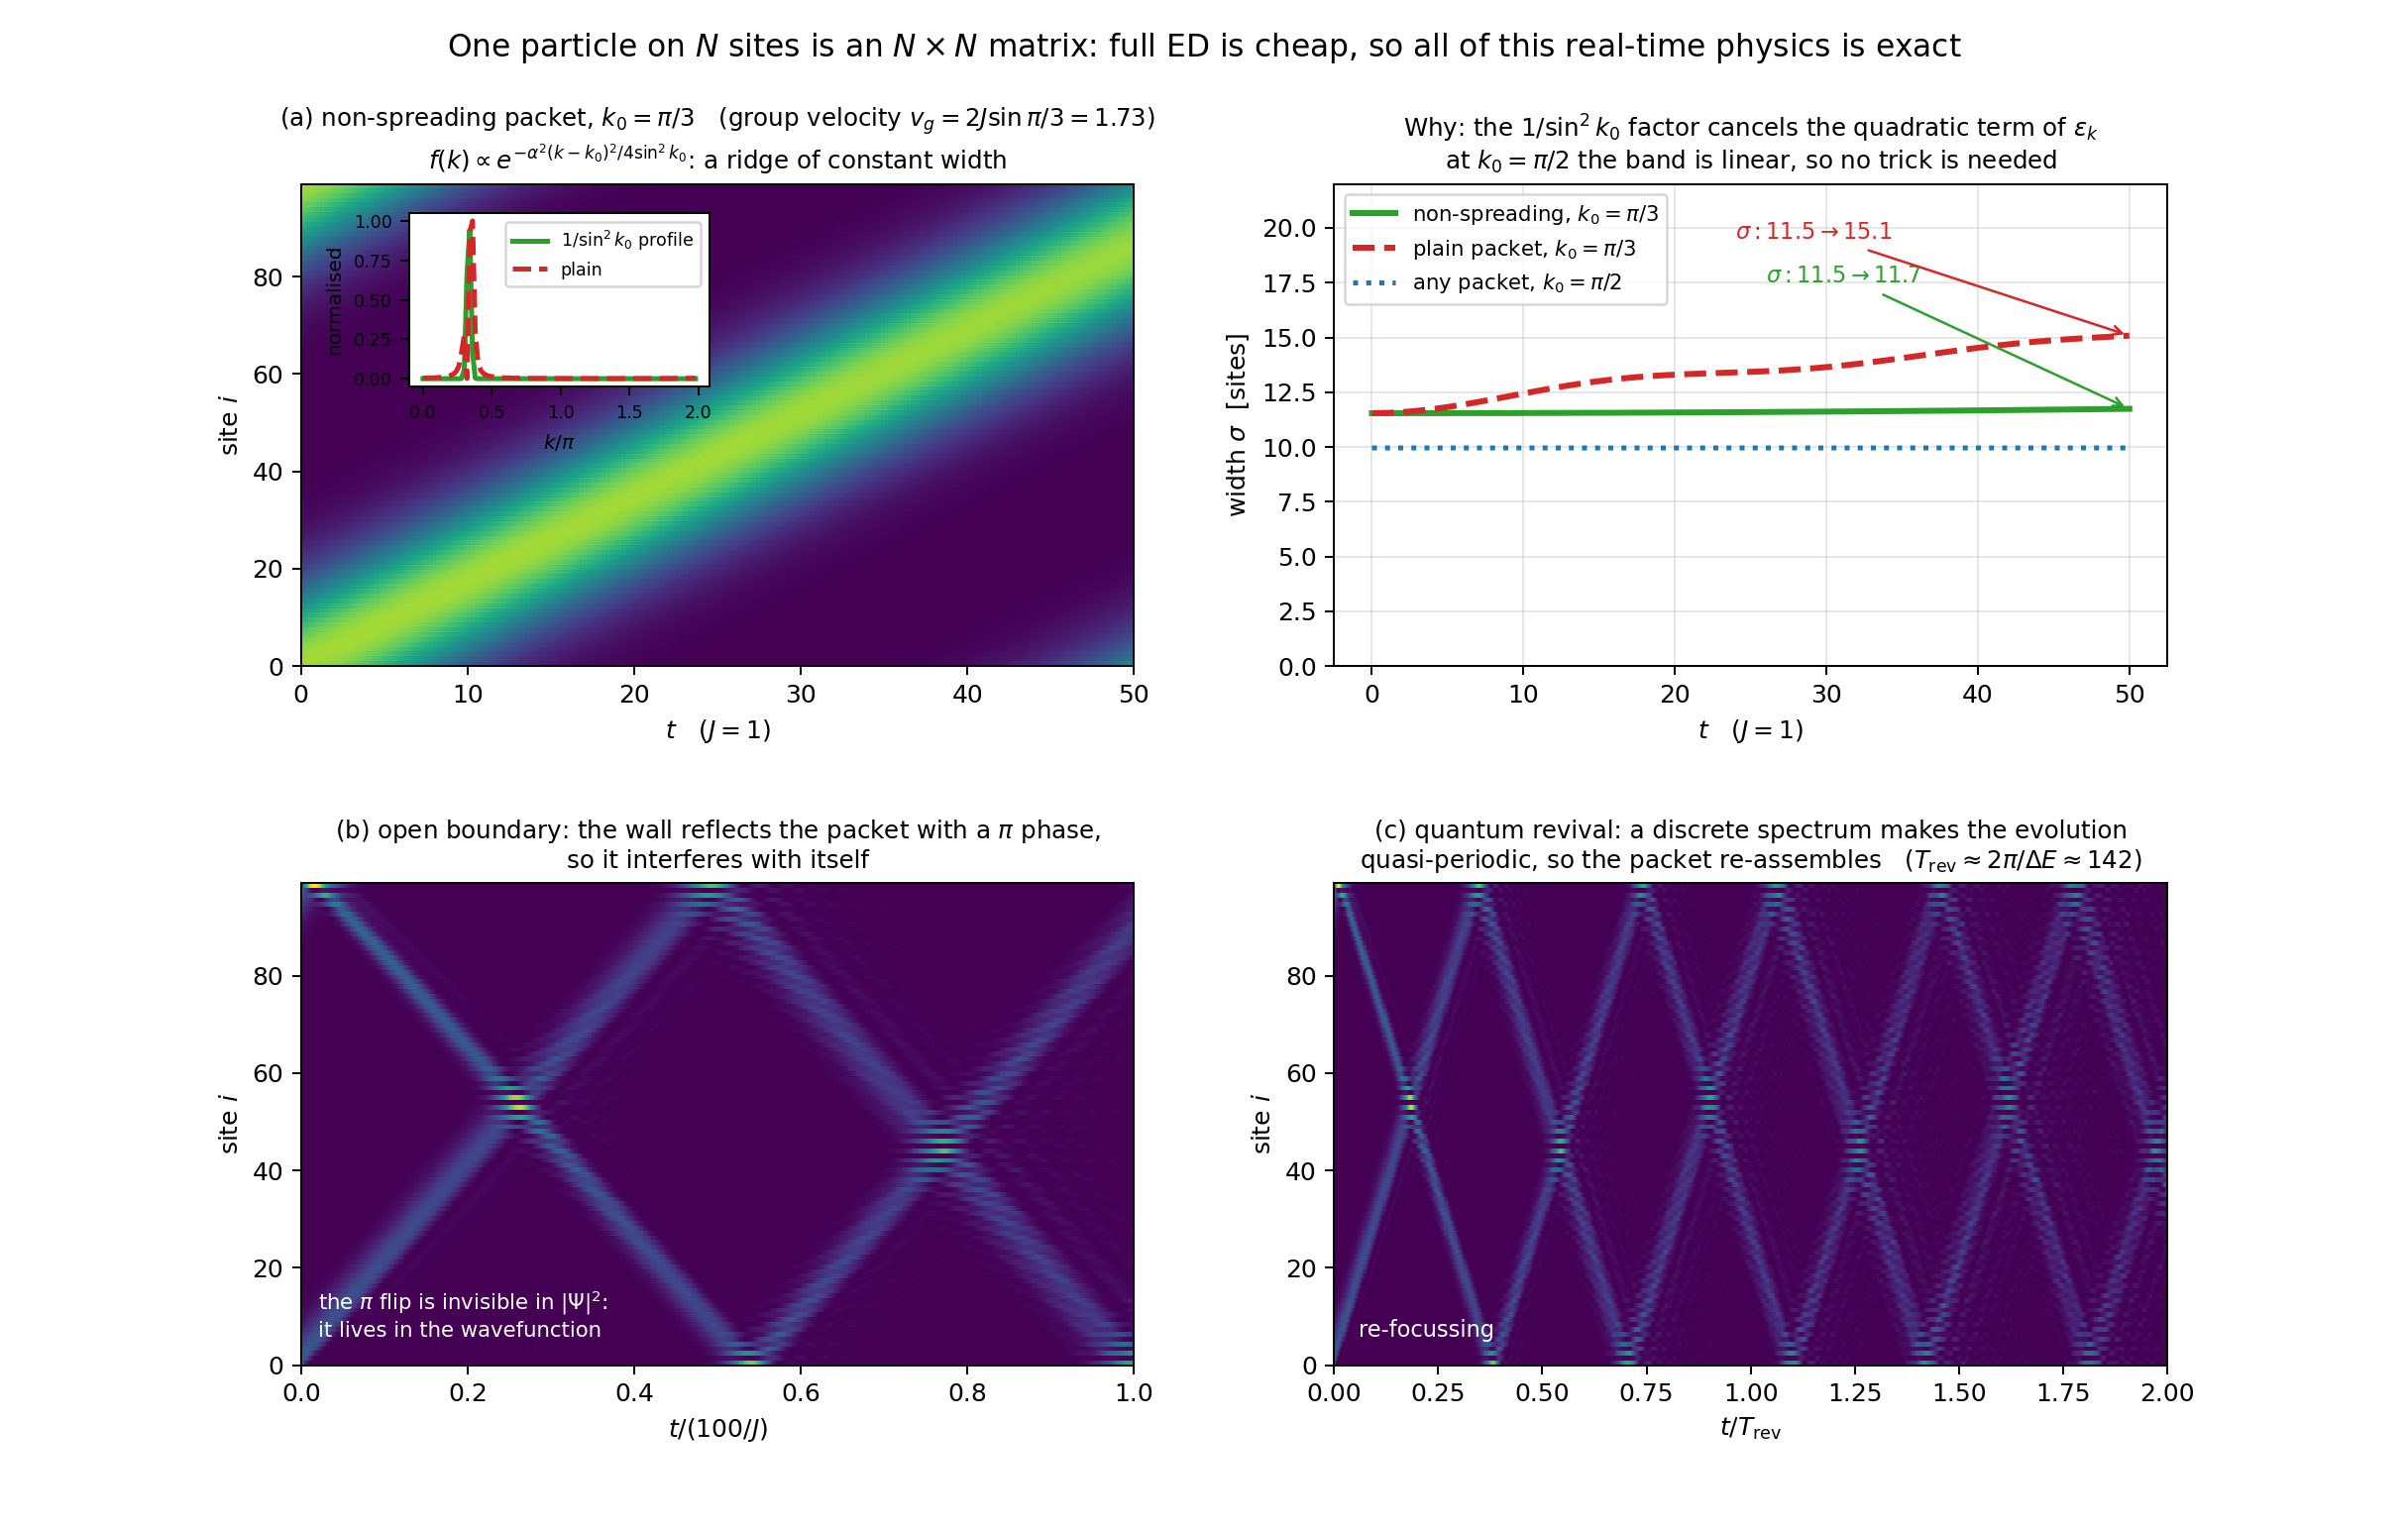
左上(a)+ 右上:这张图把”非扩散波包”讲清楚了,而且给了一个它到底为什么成立的解释:
- 热图上是一条宽度几乎不变的斜脊,速度正好 $v_g=2J\sin(\pi/3)=1.73$($t=50$ 走了 86.5 个格点 ✓)。
- 右上把两种初态的包宽 $\sigma(t)$ 画在一起:绿色(非扩散构造)从 $11.5$ 变到 $11.7$(涨了 1.7%),红色(同样初始宽度的普通高斯)从 $11.5$ 变到 $15.1$(涨了 31%)。
- 蓝线($k_0=\pi/2$ 的任意波包)是完全不动的——因为那里色散是线性的,根本不需要任何技巧。
所以论文那个 $1/\sin^2k_0$ 因子的作用是:把动量分布预先拉宽/压窄 $\propto1/\sin k_0$,恰好抵消掉色散的二阶项 $\frac12\varepsilon’’(k_0)\,\delta k^2$。$1/\sin^2k_0$ 这个 $\sin$ 正是 $\varepsilon’’$ 的倒数。这才是”非扩散”的机制,而不是某种神秘的自相似态。
左下(b)开边界:波包撞墙、反射、与自己干涉——图中那两个 X 形交叉点就是”正波包”和”反射波包”相遇的地方,交叉点上细密的条纹是干涉。反射带一个 $\pi$ 相位跳变(硬壁边界的普遍特征),但注意:模方 $|\Psi|^2$ 看不见这个 $\pi$——相位只影响干涉条纹的位置,不影响强度。
右下(c)量子复兴:能谱是离散的,所以演化准周期。图里能看到波包碎裂成多个极大、又重新聚拢,周期约 $T_{\rm rev}\approx142$(用 $2\pi/\mathrm{median}(\Delta E)$ 粗估,$J=1$、$N=100$ 开链)。量子相干性在这里是可以被看见的,而且已在冷原子与超导比特实验中被观测到。
易错:三张 3D 图的纵轴刻度不同((a) 到 0.15、(b) 到 0.2、(c) 到 0.05)。不要直接比较峰高,要看”包是否保持形状”。
易错:$\pi$ 相移在 $|\Psi|^2$ 上看不出来(相位不影响模方),它只体现在波函数本身(以及干涉条纹的位置)上。所以示意图用”倒置的波包”来表示相位的反号,而不是模方的变化。
非厄米哈密顿量
厄米哈密顿量($\hat H = \hat H^\dagger$)的本征态是正交归一的:$\langle\psi_m|\psi_n\rangle = \delta_{mn}$,单位算符是 $\sum_n|\psi_n\rangle\langle\psi_n|$。非厄米哈密顿量($\hat H \neq \hat H^\dagger$)破坏了这个性质:
- 左右本征矢不同:右本征矢 $|F_n\rangle$ 满足 $\hat H|F_n\rangle = \omega_n|F_n\rangle$,左本征矢 $\langle G_n|$ 满足 $\langle G_n|\hat H = \omega_n\langle G_n|$(等价地 $\hat H^\dagger|G_n\rangle = \omega_n^*|G_n\rangle$)。
- 本征值可以是复数:$\omega_n\in\mathbb{C}$。虚部有明确的物理意义:$\mathrm{Im}\,\omega_n < 0$ 表示衰减(耗散),$>0$ 表示增益。
- 本征矢不正交:$\langle F_m|F_n\rangle \neq 0$($m\neq n$),而且可能出现例外点(exceptional point)——本征值与本征矢同时简并,本征矢塌缩成一个(Jordan 块)。
“双正交基”的解决办法:把左右本征矢配对使用。定义双正交归一化 $\langle G_m|F_n\rangle = \delta_{mn}\langle G_n|F_n\rangle$,就得到
第二个公式就是非厄米版的”谱分解演化”,与厄米公式逐项对应:
| 厄米 | 非厄米 | |
|---|---|---|
| 本征方程 | $\hat H\lvert \psi_n\rangle = E_n\lvert \psi_n\rangle$ | $\hat H\lvert F_n\rangle = \omega_n\lvert F_n\rangle$,$\langle G_n\rvert\hat H = \langle G_n\rvert\omega_n$ |
| 本征值 | $E_n$ 实 | $\omega_n$ 复 |
| 正交性 | $\langle\psi_m\lvert \psi_n\rangle = \delta_{mn}$ | $\langle G_m\rvert F_n\rangle = \delta_{mn}\langle G_n\rvert F_n\rangle$ |
| 单位算符 | $\sum_n\lvert \psi_n\rangle\langle\psi_n\rvert$ | $\sum_n\lvert F_n\rangle\langle G_n\rvert/\langle G_n\rvert F_n\rangle$ |
| 时间演化 | $\sum_n\lvert \psi_n\rangle e^{-iE_nt}\langle\psi_n\rvert$ | $\sum_n\lvert F_n\rangle e^{-i\omega_nt}\langle G_n\rvert/\langle G_n\rvert F_n\rangle$ |
“this in principle solves all the dynamics“——这就是它值得一讲的理由。非厄米哈密顿量在今天非常活跃:
- 耗散系统:开放量子系统、冷原子中的粒子损失、光子晶体、波导 QED;
- $\mathcal{PT}$ 对称系统:本征值可以是实的($\mathcal{PT}$ 对称破缺相变),以及例外点附近的奇异响应(传感器、单向传输);
- 非厄米趋肤效应:开边界下本征态全部局域在边界上(体-边对应被破坏);
- 物理实现:光学/声学超材料、电路、冷原子。
易错:$\omega_n^$ 里的星号来自 $(\langle G_n|\hat H)^\dagger = \hat H^\dagger|G_n\rangle = (\omega_n\langle G_n|)^\dagger = \omega_n^|G_n\rangle$。别漏掉星号。
易错:$\langle G_n|F_n\rangle \neq 0$ 是必需的(非简并时通常成立),否则分母为零、双正交基失效——这正是例外点附近的困难。
极好的自动检查:本征值是复数时,”能量”不再是可观测量。如果你是在做一个封闭系统的 ED 却得到了复数本征值,多半是 $\hat H$ 写错了(不厄米)——例如费米子符号漏了、或者矩阵元行列写反了。
特例:厄米情形下 $|G_n\rangle = |F_n\rangle$,分母变成 1,一切回到前面的公式。
作业与评分
本次作业是在 $2\times3$ 梯子(6 格点,开边界)上的扩展 Hubbard 模型上做精确对角化:
固定参数 $t=1$、$U=4$、$V=1$、$\mu=4$。要点:
- 对称性:利用 $[\hat H,\hat N_\uparrow] = [\hat H,\hat N_\downarrow] = 0$,按 $(N_\uparrow,N_\downarrow)$ 分块。$N_\uparrow,N_\downarrow$ 各可取 $0\sim6$,所以共 $(6+1)^2 = 49$ 个块,每个块的维数都非零($\binom{6}{N_\uparrow}\binom{6}{N_\downarrow}$);最大块 $(3,3)$ 的维数是 $20\times20 = 400$,而 $\sum_{\text{所有块}}\dim = 4^6 = 2^{12} = 4096$ ✓。直接对角化 $4096\times4096$ 稠密矩阵是被禁止的,必须逐块做。
- 费米子符号:用”单一全局 12 位比特串”(轨道 $p = i + 6\sigma$),符号统一为 $(-1)^{\mathrm{popcount}(n\ \&\ (2^p-1))}$。
- 要计算的量包括:$(3,3)$ 块最低 8 个本征值与简并度、全系统最低 20 个本征值、$\langle n_i\rangle$ 与 $\langle S^z_i\rangle$、$\langle n_{i\uparrow}n_{i\downarrow}\rangle$ 与平均双占据 $D$、键上 $\langle\vec S_i\cdot\vec S_j\rangle$、键上 $\langle n_in_j\rangle$ 与连通关联、$\langle \hat S^2_{tot}\rangle$、以及自旋能隙与电荷能隙。
提交三样东西(通过清华网络学堂):源码 + 详细说明(基本原理 / 源码解释 / 结果分析)+ 与 AI 的对话记录。截止时间 9 月 27 日 23:00。
评分标准:
| 项目 | 分值 |
|---|---|
| 源码可执行 | +10 |
| 源码给出正确结果 | +20 |
| 源码可读性高 | +10 |
| 说明文档:基本原理 | +10 |
| 说明文档:源码解释 | +10 |
| 说明文档:结果分析 | +10 |
| 说明文档写得清楚易懂 | +10 |
| 与 AI 的对话记录 | +20 |
| 未使用 $U(1)$ 对称性 | −20 |
| 时间分:当天交 / 迟交 | +5 / 每天 −1 |
| 自驱分:新想法或额外结果 | +10 |
几个观察:
- 总分基数 100,再加上时间分(+5)与自驱分(+10)作为加分,减去 $U(1)$ 的 −20。
- “正确结果 +20” 与 “AI 记录 +20” 并列最大单项——这门课最看重的还是算对。而”算对”的标准就是前面那张验证清单(已知极限、对称性、求和规则、两种方法对照)。
- 说明文档总共 40 分,与源码的 40 分恰好相等。传达的信息很清楚:”能跑”只完成了一半,”讲清楚”才算完成。
- $U(1)$ 是硬性要求(−20)。不做 $U(1)$ 的代价是维数大 $\sqrt{\pi N/2}$ 倍($N=40$ 时约 8 倍);若用完全对角化,时间还要再乘 $(\pi N/2)^{3/2}$(约 500 倍),在大系统上根本跑不动。
- 自驱分 [+$10$]:鼓励你多做一点——多算一个物理量、做一次有限尺寸标度、加一个对称性、和文献对比。这是”从完成作业到做研究”的那一步。
易错:”did not use $U(1)$ symmetry [−20]”是扣分不是”不加分”。也就是说,即使代码完全正确,只要没有用 $U(1)$,最高只能拿 80 分。
易错:自驱分需要在说明文档里明确写出你额外做了什么,否则老师可能看不到。
附:复现用的代码工具箱
上面每张图的代码都调用了下面这些函数。把它们抄到一个文件里(例如 ed.py),后面所有图就都能直接跑。整份工具箱只有八十来行,却撑起了本讲全部 9 张图。
"""ED toolbox shared by every reproduction in this lecture.""" |
用法:
exec(open("ed.py", encoding="utf-8").read()) # 或把 ed.py 放在同目录直接 import |
三点提醒:
- 比特约定全部集中在这里:
ReadBit忘了>> n、SetBit/ClearBit的掩码、以及 $n=\sum_i n_i2^i$(格点 $i$ = 第 $i$ 位)。改任何一处都会同时影响所有图——这也是为什么把它抽成一个工具箱而不是每张图各写一遍。 HeisenbergCOO把 $J$ 做成了参数(默认 1),所以换耦合只要改调用。make_hubbard的自旋轨道编号是 $p=i+NS\sigma$,费米子符号统一由create/annihilate里那一句popcount(n & ((1<<p)-1))给出——这就是”单一全局比特串”方案,跨自旋的相对符号不需要手工拆。circ_sigma是环上的圆标准差(用 $\left|\sum_j p_j e^{i2\pi j/N}\right|$ 定义),只有在周期边界上才对。用普通的 $\sqrt{\mathrm{Var}}$ 在环上会算出完全错误的宽度,因为波包绕回来时那个”方差”会被算成 $\sim N^2$——我在做非扩散波包那张图时就先踩了这个坑。
附:ED 代码自查清单
写完 ED 代码,按这个顺序过一遍。每一条都是免费的:
| # | 检查 | 怎么做 | 期望 |
|---|---|---|---|
| 1 | 已知极限 | $N=2$ 单键 | $E_0 = -3/4$ |
| 2 | 已知极限 | $N=4$ 环 Heisenberg | $E_0 = -2$,谱 $\{-2,-1,0,+1\}$,简并 $1,3,7,5$ |
| 3 | 已知极限 | Hubbard $U=0$,4 格点环 | 单粒子能级 $\{-2,0,0,+2\}$;$\mu$–$n$ 阶梯在 $\mu=-2,0,2$ |
| 4 | 已知极限 | Heisenberg $N=4$ 环的 $E_0/N$ | $-0.5J$(对比第一讲 Bethe ansatz 的一维极限 $-0.4431J$) |
| 5 | 求和规则 | $\mathrm{Tr}\,\hat H$ | $=0$ |
| 6 | 厄米性 | (H - H.T).nnz |
== 0 |
| 7 | 稀疏度 | H.nnz vs $N\cdot2^{N-1} + 2^N$ |
环上严格相等 |
| 8 | 扇区守恒 | 每个 $(N_\uparrow,N_\downarrow)$ 块内 $N_\uparrow$、$N_\downarrow$ 是否恒定 | 恒定 |
| 9 | 维数守恒 | 各扇区维数求和 | $=2^N$(自旋)或 $=2^{2N}$(Hubbard) |
| 10 | 幺一性 | $\lVert\psi(t)\rVert$ 随 $t$ | 恒为 1 |
| 11 | 两种方法对照 | 稠密 eigh vs 稀疏 eigsh |
本征值一致到 $10^{-12}$ |
| 12 | 交叉验证 | ED vs 第一讲的严格解(3 格点 Heisenberg:$E_0=-J$,二重简并,$S=\frac12$) | 一致 |
附:常见错误清单
写 ED 代码前先读一遍。前 10 条是本讲反复强调的。
- 格点编号方向搞反。本讲:格点 $i$ = 第 $i$ 位,格点 0 在最右边。若与第一讲的
np.kron路线混用,格点顺序会反,所有局域量都错且不报错。 - `Nl = 2Ns
写成2Ns`*(应为 $2^N$)。 ReadBit忘了>> n,返回 0 或 $2^n$,导致 $S^z_i = \mathrm{ReadBit} - 0.5$ 变成 $-0.5$ 或 $2^n - 0.5$。- 对角元被错误地放进
if里,只有”自旋相反”的基矢才有对角元,漏掉 $+\frac14$ 的贡献。 - 环上漏掉最后一条键 $(N-1,0)$(或反过来,在开链上多加了一条)。
- 非对角元的行、列写反。实厄米 $\hat H$ 时矩阵不变($\hat H^T = \hat H$),谱不会错;但复厄米 $\hat H$ 时写反等于用了 $\hat H^*$,关联函数与时间演化都会错。
eig与eigh混用。哈密顿量是厄米的,用eigh/eigsh;eig返回复数且不排序。which='SM'找基态。应该用'SA'(对eigsh)。- 费米子符号。$\downarrow$ 的插入/删除多一个 $\sum_k n_{k\uparrow}$ 因子;忘了它,本征值会错。
- Lin 表的 off-by-one。$J_a$ 从 1 开始、$J_b$ 从 0 开始;论文用 1-based,代码用 0-based。
- 用普通移位代替循环移位做平移,破坏周期性边界。
- 位运算优先级。
x & 1 == 1会被解析成x & (1 == 1),永远加括号。 - 不检查厄米性。matrix-free 时没有矩阵可查,建议在构造完后用稠密小系统验证
(H - H.T).nnz == 0。 - 不用 $U(1)$ 对称性。最大扇区维数只有 $2^N/\sqrt{\pi N/2}$,也就是用 $U(1)$ 能省 $\sqrt{\pi N/2}$ 倍($N=40$ 时约 8 倍)——这正是作业里”不用 $U(1)$ 扣 20 分”的原因。
- 不写验证。只算出一个数就交作业。必须做上面那张自查清单。
附:延伸阅读
精确对角化的方法综述
- H. Q. Lin, Exact diagonalization of quantum-spin models, Phys. Rev. B 42, 6561 (1990). —— Lin 表的原始论文。
- J. Schnack, Exact diagonalization techniques, in Computational Many-Particle Physics, LNP 739, Springer (2008). —— 综述章节。
- A. Weiße, H. Fehske, Exact diagonalization techniques, Rev. Comput. Chem. 23, 529 (2008). —— 另一种综述,含大量实现细节。
- N. Laflorencie, D. Poilblanc, Algorithms for spin systems, in Strongly Correlated Systems: Numerical Methods, Springer (2013).
Krylov / Lanczos
- C. Lanczos, J. Res. Natl. Bur. Stand. 45, 255 (1950).
- R. B. Lehoucq, D. C. Sorensen, C. Yang, ARPACK Users’ Guide, SIAM (1998). ——
eigs/eigsh的底层。 - T. J. Park, J. C. Light, Unitary quantum time evolution by iterative Lanczos reduction, J. Chem. Phys. 85, 5870 (1986).
费米子符号与 Hubbard 模型
- J. Hubbard, Proc. R. Soc. Lond. A 276, 238 (1963).
- E. H. Lieb, F. Y. Wu, Phys. Rev. Lett. 20, 1445 (1968).
- J. E. Hirsch, Phys. Rev. B 31, 4403 (1985). —— 早期 ED + QMC。
非厄米物理
- C. M. Bender, S. Boettcher, Phys. Rev. Lett. 80, 5243 (1998). —— $\mathcal{PT}$ 对称的开创性工作。
- Y. Ashida, Z. Gong, M. Ueda, Non-Hermitian physics, Adv. Phys. 69, 249 (2020). —— 综述。
- E. J. Bergholtz, J. C. Budich, F. K. Kunst, Rev. Mod. Phys. 93, 015005 (2021).
实时演化 / 波包
- S. Yang, Z. Song, C. P. Sun, Non-spreading wave packet and solid-state flying qubit, Phys. Rev. A 73, 022317 (2006). —— 本讲实例的原始工作。
- A. Weichselbaum, S. Capponi, P. Lecheminant, A. M. Tsvelik, A. Delft, Unified approach to the time evolution of one-dimensional quantum systems(综述)。
参考书
- H. Fehske, R. Schneider, A. Weiße (eds.), Computational Many-Particle Physics, LNP 739, Springer (2008).
- A. Avella, F. Mancini (eds.), Strongly Correlated Systems: Numerical Methods, Springer SSS 176 (2013).
第三讲(ED II)会接着讲:如何用 $U(1)$ / 平移对称性把维数再压下去(动量空间 ED)、如何做动力学关联函数与谱函数、如何用有限尺寸标度把结果外推到热力学极限。