05 密度矩阵重整化群与矩阵乘积态
- 本讲在课程中的位置
- 一句话概括本讲
- 三条线、一张地图
- 约定表
- 主线一:NRG 为什么失败
- 主线二:纠缠给”重要”下定义
- 主线三:一维的面积律
- 主线四:传统 DMRG
- 主线五:MPS 与 MPO
- 怎么知道做对了
- 为什么值得,边界在哪
- 作业要点与评分
- 校检清单
- 附:复现用的代码工具箱
- 延伸阅读与作业
本讲在课程中的位置
第四讲的结尾,你那台 ED 机器已经能对 $N=20$ 的开边界 XXZ 链给出
再往上走一步,$N=24$ 的扇区维数是 $2.7\times10^6$,$N=32$ 是 $6.0\times10^8$。这不是”慢一点”的问题,是”再也跑不动”的问题。 ED 的墙不在算法,在维度:它老老实实地保存了整个希尔伯特空间。
前四讲一直在做同一件事:在不丢信息的前提下把矩阵变小。对称性把 $2^N$ 切成扇区,平移对称性再切一刀,Lanczos 只碰向量不碰矩阵。这些手段有一个共同点——它们都是精确的,最后得到的还是同一个 $E_0$。
第五讲换了一个问题。它第一次允许你丢掉东西:
能不能只保留”重要的”态,把剩下的扔掉,而误差可控?
这是整个量子多体数值方法的分水岭。ED 的一切都建立在”基是完备的”之上;DMRG 的一切都建立在”基可以不完备,但要选对”之上。选错了,你会得到第四讲作业里那条 $J_2$ 扫描的假相变;选对了,$N=100$ 的一维链可以算到 $10^{-10}$。
一句话概括本讲
用约化密度矩阵(= Schmidt 分解 = SVD)给”重要”下定义:一个态重要,不是因为它的能量低,而是因为它在真实基态里权重大;按这个标准截断,一维的 $\chi$ 只要几十,误差就掉到 $10^{-8}$。
这句话里有两个”不是”:
- 不是按能量截断——那是 NRG 的做法,Wilson 用它在 Kondo 问题上拿了诺贝尔奖,但换一个体系就崩;
- 不是”截断就一定错”——截断的误差有明确的下界(被丢掉的 Schmidt 权重),你可以随时量它。
三条线、一张地图
本讲有 32 页幻灯片,但真正的逻辑只有三步:
| 问题 | 幻灯片 | 答案 | 关键词 |
|---|---|---|---|
| 为什么不能按能量截断? | 第 3–9 页 | 块的低能态在接缝处”归零”,拼不出光滑的基态(kink) | NRG、fixed-free |
| 那按什么截断? | 第 12–21 页 | 按 Schmidt 值 / 约化密度矩阵的本征值 | SVD、$\rho_A$、Eckart–Young |
| 具体怎么算? | 第 22–30 页 | 超块 + 一次增长(infinite)+ 左右扫描(finite) | 块算符、discarded weight |
然后还有一条幻灯片目录里有、正文没展开的线:第 2 页列了”MPS and MPO””MPS algorithms”。这不是可有可无的补充——传统 DMRG 的”块”和 MPS 的”张量”是同一个对象的两种记法,看懂这层等价,你才知道第六讲的张量网络在干什么。本讲会把这条线补完。
和前四讲的关系,一句话:
| 讲 | 手段 | 代价 | 结果 |
|---|---|---|---|
| 02–04 | 对称性、稀疏、Lanczos | 维数仍是指数,只是底数小了 | 精确,$N\lesssim 20$ |
| 05 | 按纠缠截断 | 不再精确,但误差可测 | $N\sim10^2$(一维) |
| 06 | 张量网络(PEPS/MERA) | 二维也要截断,且更贵 | $N\sim10^3$(二维窄条) |
约定表
承接前四讲,新增部分用粗体:
| 量 | 本讲约定 |
|---|---|
| 模型 | 开边界 $J_1$–$J_2$ XXZ 链,$N$ 个格点,$J_1=1$,$\Delta=1$ |
| 哈密顿量 | $H=J_1\sum_{j=0}^{N-2}\mathbf S_j\cdot\mathbf S_{j+1}+J_2\sum_{j=0}^{N-3}\mathbf S_j\cdot\mathbf S_{j+2}$($\Delta=1$ 时即海森堡型) |
| 基矢 | 比特 $j$ = 格点 $j$(0 是最低位),$b_j=1$ ↔ 自旋向上 |
| 扇区 | $S^z_{\rm tot}=0$;块基矢带 $q=2S^z$ 标签 |
| 边界 | 开边界,求和不回绕;周期值只用于校检对照 |
| 保留维数 | $\chi$(文献里也写 $m$、$D$):块基矢截断到的维数 |
| discarded weight | $\varepsilon=1-\sum_{i\le\chi}\lambda_i^2/\sum_i\lambda_i^2$,被丢掉的 Schmidt 权重 |
| MPS 张量 | $A^{[i]}_{a s b}$:左键 $a$、物理指标 $s\in\{0,1\}$、右键 $b$ |
| MPO 张量 | $W^{[i]}_{\alpha\beta,ts}=\langle t\lvert \hat O\lvert s\rangle$:左键 $\alpha$、右键 $\beta$ |
| 数值环境 | numpy + scipy,双精度;$\chi\le64$,$N\le32$ 的实现在本讲附录 |
一个必须提前说清的记号陷阱:本讲的 $\chi$ 是”每个块保留几个态”,不是”每个 $q$ 扇区保留几个”。带 $q$ 标签时,$\chi$ 是跨扇区的总数。作业里若按扇区各留 $\chi$ 个,总维数会是 $\chi\times(\text{扇区数})$,结果会”好得不像话”——那不是算法的功劳,是你偷偷多留了态。
主线一:NRG 为什么失败
盒中粒子:把”截断”做得看得见
在讲 DMRG 之前,先看一个能用手算完的例子。一维盒中粒子,$[0,L]$ 上离散成 $L$ 个格点,二阶中心差分:
写成矩阵就是一条开边界紧束缚链:
单粒子本征值 $E_n=-2t\cos\frac{\pi n}{L+1}$,本征函数 $\psi_n(x)=\sin\frac{\pi n(x+1)}{L+1}$,在两端为零——这是”盒”的定义。
现在把链从中间切开,左半是”块”(block),右半是”环境”(environment)。注意左半的边界条件变了:它现在是一个长度 $L/2$ 的盒子,波函数在切口处也必须为零。这个”多出来的墙”就是后面一切麻烦的根源。
NRG 的五步
Wilson 的数值重整化群(NRG,1975)本来是为 Kondo 杂质问题设计的,流程极其简单:
- 把两个块拼起来,写出 $H’$;
- 对角化 $H’$,得到本征矢 $V_l$;
- 取能量最低的 $m$ 个本征矢,组成变换矩阵 $O$;
- 换基并截断:$H’’=O^\dagger H’O$,$T’’=O^\dagger T’O$;
- 用 $H’’$、$T’’$ 替换 $H$、$T$,重复。
这套流程的全部智慧在一句话里:保留能量最低的 $m$ 个态。 对 Kondo 问题它极其成功——因为杂质只和导带的一个端点耦合,低能物理确实由”最靠近费米面的那几个态”决定。
但把它原封不动地搬到一条平移不变的链上,就会出问题。
kink:失败不在能量,而在边界
问题可以一眼看穿。左块的 $m$ 个最低本征态都满足”在切口处为零”(它们是孤立左盒的本征态)。它们的任意线性组合也在切口处为零。而真实的基态 $\psi(x)=\sin\frac{\pi(x+1)}{L+1}$ 在切口处不为零——它要穿过接缝,延伸到右半去。
于是你拼出来的波函数必然长这样:左半段光滑,到接缝处突然掉到零,右半段从头开始。这就是幻灯片第 7 页画的 kink(折角)。
“要消掉这个 kink,就得保留几乎所有的态”——因为接缝处的跳变是一个局域的、高动的特征,它在能量本征基里展开时,系数 decay 得极慢。数值上:
| $L$ | $m=2$ | $m=4$ | $m=8$ | $m=16$ | $m=32$ |
|---|---|---|---|---|---|
| 10 | $8.6\times10^{-2}$ | $2.0\times10^{-2}$ | $1.8\times10^{-2}$ | — | — |
| 20 | $8.9\times10^{-2}$ | $3.3\times10^{-2}$ | $3.8\times10^{-2}$ | $1.7\times10^{-2}$ | — |
| 40 | $9.1\times10^{-2}$ | $4.0\times10^{-2}$ | $5.3\times10^{-2}$ | $2.8\times10^{-2}$ | $2.0\times10^{-2}$ |
(表中是相对误差 $\lvert E-E_{\rm exact}\rvert/\lvert E_{\rm exact}\rvert$,$E_{\rm exact}$ 为半满时的多体基态能量。)
读表:$m$ 从 2 加到 32,误差只从 $9\%$ 降到 $2\%$;而且不单调($L=40$ 时 $m=8$ 比 $m=4$ 还差)。一个”变分方法”误差不随保留态数单调下降,说明你保留的根本不是变分空间——每一步截断都在换基,后面的截断会把你前面辛苦留下的态再扔掉。
这就是”为什么 NRG 只对 Kondo 有效”的定量版本:它不是”低能截断”这一个想法错了,而是”低能”这个判据在平移不变体系里选错了态。
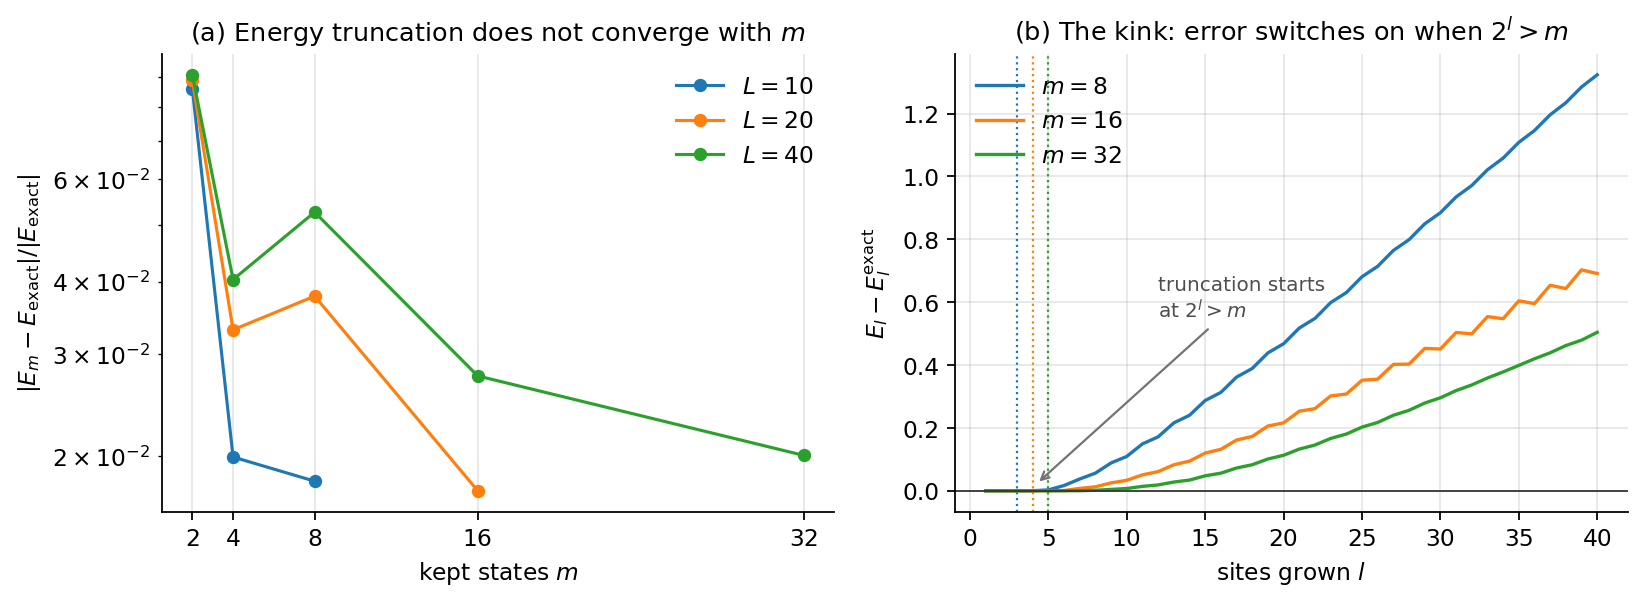
读图:(a) 相对误差随 $m$ 的变化——三条曲线都在 $10^{-2}$ 量级徘徊,没有指数收敛;(b) 机制:精确基态(灰)在接缝处连续,用左块最低几个本征态拼出的近似(蓝)在接缝处归零,形成折角。kink 不是数值噪声,是边界条件强加的。
fixed-free 补丁与它的极限
White 和 Noack 在 1992 年的第一篇 DMRG 论文里,先给了一个补丁:把不同边界条件的块态混起来。
具体做法(幻灯片第 9 页):把左块按切口处的边界条件分成四种——固定-固定、固定-自由、自由-固定、自由-自由,对应四个子矩阵 $H_{11},H_{12},H_{21},H_{22}$;从每个子问题里取最低的 $m/4$ 个态,拼成候选基,再正交化、换基:
这个补丁确实能消掉 kink:自由边界的那一半允许波函数在接缝处不为零,两种边界条件的态一混合,跳变就被磨平了。对自由粒子,它工作得不错。
但幻灯片紧接着给了一句极其重要的判词:
“connections to surrounding blocks are important! such method may not work for interacting systems.”
翻译成大白话:这个补丁是给”边界”打的,不是给”相互作用”打的。 它修的是”切口处的墙”,修不了”块内的关联”——相互作用体系里,块的低能态和环境的低能态纠缠在一起,你按”块自己”的能量选态,选的仍然是错的。
真正的出路不是换边界条件,是换判据。 这就是下一节:不看块的能量,看这个态在真实基态里占多大权重。
主线二:纠缠给”重要”下定义
Schmidt 分解就是 SVD
把 $N$ 个格点切成 $A$(左 $L$ 个)和 $B$(右 $N-L$ 个)。任意态可以写成
$C$ 是一个 $2^L\times 2^{N-L}$ 的矩阵。对它做奇异值分解:
这就是 Schmidt 分解。 幻灯片第 15–16 页花了整整两页说明”Schmidt 分解可以用 SVD 得到”——其实是一句话:对系数矩阵做 SVD,左奇异向量给 $A$ 的 Schmidt 基,右奇异向量给 $B$ 的,奇异值给权重。
三个必须记住的性质:
- $s_\alpha\ge0$,且 $\sum_\alpha s_\alpha^2=1$(归一化);
- $\lvert u_\alpha\rangle$ 与 $\lvert v_\alpha\rangle$ 各自正交:$U^\dagger U=\mathbb 1$,$V^\dagger V=\mathbb 1$;
- Schmidt 分解的项数 $r$ 就是纠缠的”秩”。乘积态 $r=1$;最大纠缠态 $r=2^{L}$(当 $L\le N/2$)。
约化密度矩阵与截断的最优性
对 $B$ 求迹,得到 $A$ 的约化密度矩阵:
$\rho_A$ 的本征值就是 $s_\alpha^2$,本征矢就是 Schmidt 基。 这一句把”纠缠””密度矩阵””SVD”三件事焊在了一起。
现在截断:只留前 $\chi$ 个 $s_\alpha$,扔掉其余的。误差是多少?
这不是”一种”截断误差,是最优截断误差(Eckart–Young 定理):在所有秩不超过 $\chi$ 的矩阵里,$C_\chi$ 离 $C$ 最近,且最近距离就是被丢掉的奇异值平方和。
这就是 DMRG 与 NRG 的全部区别,写成一行: NRG 保留”块哈密顿量能量最低”的态,DMRG 保留”$\rho_A$ 本征值最大”的态。前者最小化的是块自己的能量,后者最小化的是对真实基态的 Frobenius 误差。前者是局部判据,后者是全局判据。
为什么全局判据能赢?因为任意只作用在 $A$ 上的观测量,期望值只通过 $\rho_A$ 进入:
权重 $s_\alpha^2$ 小的态,对任何 $A$ 上的测量都几乎没有贡献。 扔掉它们,你损失的是 $10^{-8}$,不是”物理”。而块的低能态可能权重只有 $10^{-4}$——能量截断扔的正是这些”高权重但非最低能”的态。
数值:N=12 中点的 Schmidt 谱
$N=12$、$J_2=0$、开边界,在正中 $L=6$ 切开。精确基态 $E_0=-5.142090632841$,Schmidt 谱如下:
| $\alpha$ | $s_\alpha$ | $q=2S^z_A$ | $s_\alpha^2$ |
|---|---|---|---|
| 1 | 0.9317240613 | 0 | 0.868 |
| 2–4 | 0.2094662253 | $+2,0,-2$ | 0.0439 |
| 5–6 | 0.0088167550 | $\pm2$ | $7.8\times10^{-5}$ |
| … | … | … | … |
| 秩 | $r=64$ | — | — |
中点纠缠熵
读谱:第一个奇异值占了 $87\%$,接下来三个($q=+2,0,-2$,三重简并)各占 $4.4\%$,再往下掉了两个数量级。“只留 4 个态就能抓住 $99.98\%$ 的权重”——这就是 DMRG 在一维能工作的全部底气。
两个容易读错的地方:
- $q$ 标签不是可有可无的。第二个奇异值出现在 $q=\pm2$ 和 $q=0$ 两个扇区(三条简并),因为总 $S^z=0$ 要求左右 $q$ 相反。截断时若不分扇区,你会把三重简并拆开,破坏 $SU(2)$ 对称性,能量反而更差。
- 秩是 $64=2^6$,但”满秩”不等于”强纠缠”。左块有 6 个格点,只要每个左基矢都有非零权重,$C$ 就满秩;这只说明没有精确的零。真正的信息在衰减速度:前 4 个态占 $99.98\%$,第 5 个就掉到 $7.8\times10^{-5}$。
密度矩阵截断 vs 能量截断
现在做作业第 2 题:同一个 $N=12$、$J_2=0$ 的基态,左、右各留 $m$ 个态,在完整空间里投影 $H$,取最低本征值。两种选态方式:
- 密度矩阵:留 $s_\alpha$ 最大的 $m$ 个 Schmidt 态;
- 能量:留左块 $H_A$ 本征能量最低的 $m$ 个态(NRG 式)。
| $m$ | 投影空间维数 | 密度矩阵 $\lvert E-E_0\rvert$ | 能量 $\lvert E-E_0\rvert$ |
|---|---|---|---|
| 2 | 2 | $1.11\times10^{-1}$ | $1.55\times10^{-1}$ |
| 4 | 6 | $5.05\times10^{-4}$ | $1.07\times10^{-1}$ |
| 6 | 12 | $2.32\times10^{-4}$ | $6.48\times10^{-2}$ |
| 8 | 24 | $1.61\times10^{-5}$ | $3.00\times10^{-2}$ |
| 12 | 50 | $3.33\times10^{-6}$ | $2.05\times10^{-3}$ |
| 16 | 70 | $4.18\times10^{-8}$ | $5.71\times10^{-4}$ |
读表:$m\ge4$ 之后,密度矩阵截断比能量截断好 2–4 个数量级。$m=2$ 时两者接近,因为第二个 Schmidt 能级在 $q=-2,0,+2$ 三重简并,只留一个态时”留哪个”本身有歧义;$m\ge4$ 时三重简并被完整包含,趋势就干净了。
这不是”密度矩阵更聪明”,是”密度矩阵更诚实”:它衡量的是”这个态在真实基态里有多重”,而不是”这个态自己有多低”。能量截断会把一个能量低、但在基态里权重只有 $10^{-4}$ 的态当成宝贝留下,同时扔掉一个能量高、权重 $0.2$ 的态。
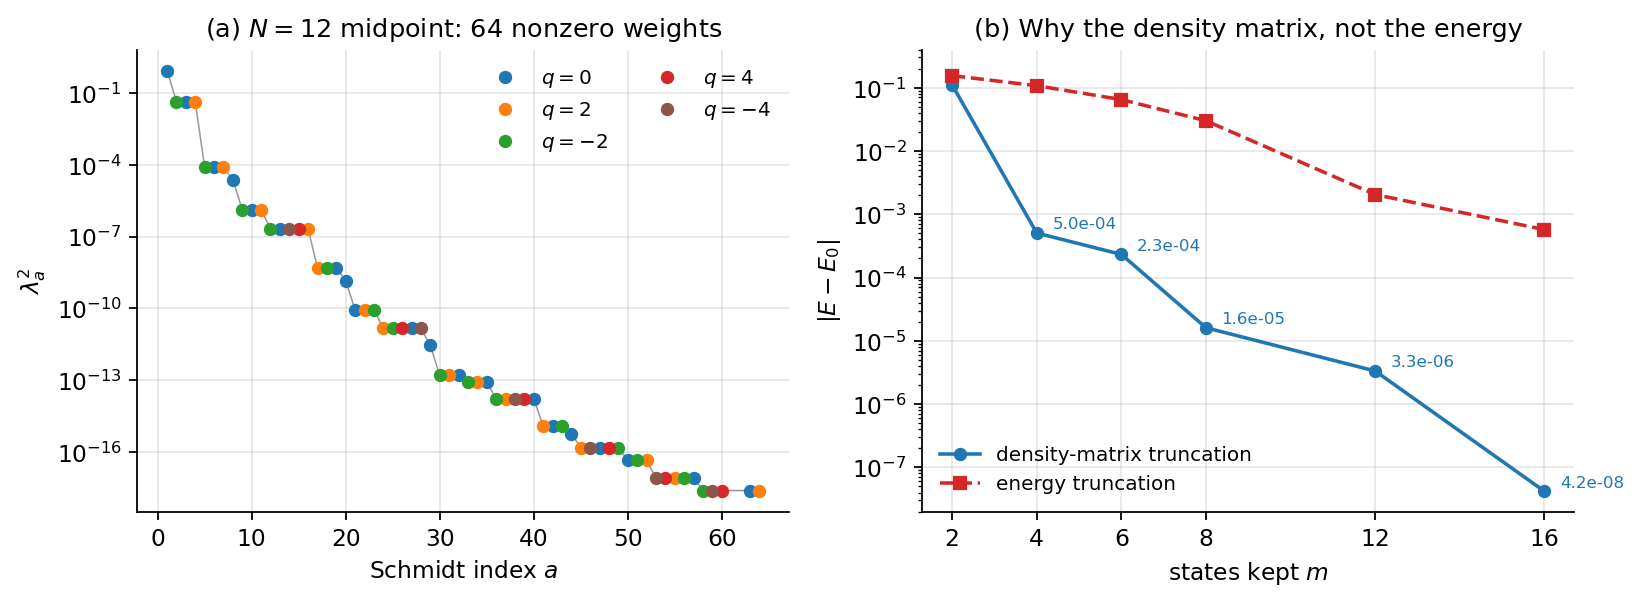
读图:(a) Schmidt 谱(对数纵轴),颜色标出 $q$ 扇区——三重简并清晰可见;(b) 两种截断的误差对比,密度矩阵截断(蓝)从 $m=4$ 起就贴着 $10^{-4}$ 往下走,能量截断(红)慢得多。
主线三:一维的面积律
随机态:体积律
在讲”为什么一维只要几十个态”之前,先看反面。
$N=16$ 的随机态(固定种子),中点 $S(8)=5.038292$。理论值(Page 修正):
随机态的纠缠熵正比于子系统的体积(这里是 $N/2$ 个格点,每个贡献 $\ln2$)。要精确表示它,Schmidt 秩需要 $2^{N/2}$——指数大。
基态:面积律
真实基态完全不同。$N=16$、$J_2=0$ 的基态,中点 $S(8)=0.592307$;整条曲线:
它不随 $l$ 增长(除了缓慢的对数修正),而是饱和在一个 $O(1)$ 的值上。这就是面积律:一维的”边界”是 0 维的两个点,所以纠缠只来自切口附近,与 $l$ 无关。
四种态的中点熵,一张表看完:
| 态 | $S(8)$ | 规律 |
|---|---|---|
| 乘积态 $\lvert\uparrow\uparrow\cdots\rangle$ | 0 | 面积律(平凡) |
| Néel 态 $\lvert\uparrow\downarrow\uparrow\downarrow\cdots\rangle$ | 0 | 面积律(平凡) |
| GHZ 态 $(\lvert\uparrow\cdots\rangle+\lvert\downarrow\cdots\rangle)/\sqrt2$ | $\ln2=0.693$ | 面积律 |
| 随机态 | 5.038 | 体积律 |
| XXZ 基态 | 0.592 | 面积律 |
“面积律”是 DMRG 存在的理由。 若基态满足面积律,$S$ 不随 $l$ 增长,$\rho_A$ 的谱就衰减得快,截断到 $\chi$ 的误差随 $\chi$ 指数小——一维就能用几十个态描述 $N=100$ 的链。
临界与有能隙
面积律在两种情形下表现不同:
- 有能隙(如 MG 点 $J_2=0.5$):$S(l)$ 饱和到常数,且常常是阶梯状的。$N=16$ 的 MG 点,$S(l)$ 在 $0$ 与 $\ln2$ 之间交替——因为基态是 singlet 的直积,每个切口最多切断一个 Bell 对。
- 临界($J_2=0$,$c=1$):$S(l)\sim\frac{c}{3}\ln l+\text{const}$,缓慢增长。$N=16$ 上这个对数增长还看不明显($0.69\to0.77$),但它是真实存在的——这也解释了为什么临界体系的 DMRG 比有能隙体系贵:$\chi$ 要随 $N$ 多项式增长,而不是饱和。
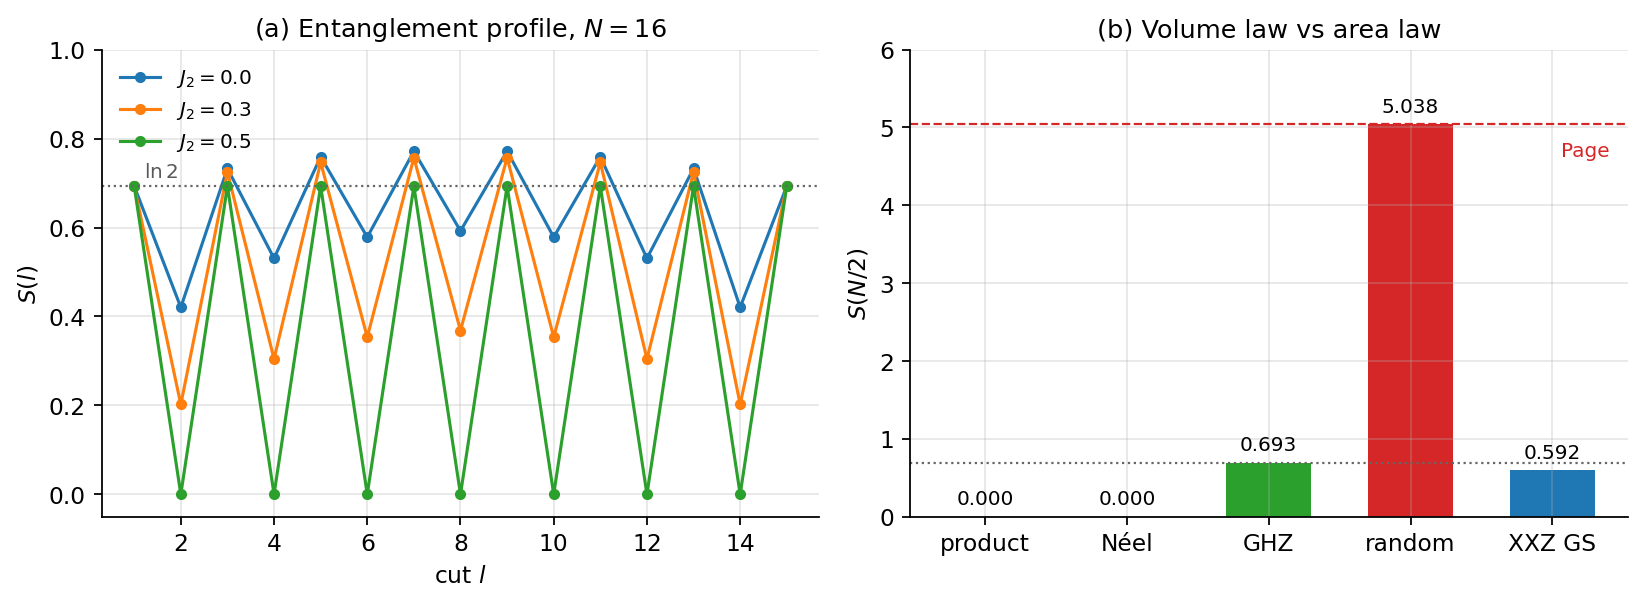
读图:(a) 三条剖面。$J_2=0$(蓝)在 $0.6$–$0.8$ 之间缓慢上升(临界,对数);$J_2=0.3$(橙)更低更平(能隙在打开);$J_2=0.5$(绿)严格在 $0$ 与 $\ln2$ 之间交替(MG 点,二聚体)。“能隙打开”在纠缠上的表现就是”剖面变低变平”。 (b) 四种参照态——乘积/Néel 是 0,GHZ 是 $\ln2$,随机态是 5.04(体积律),XXZ 基态紧贴面积律。
别把 (a) 里的 even-odd 振荡当成物理。 $S(8)=0.592$ 比 $S(7)=0.772$ 低,不是”中心纠缠更小”,而是开边界 $N=16$ 的奇偶效应:$l=8$ 把链切成两个偶数块,$q=0$ 扇区的权重更集中;$l=7$ 切成奇/偶,Schmidt 谱更”胖”。这个效应随 $N$ 增大而减弱,但在 $N=16$ 上不能忽略。做有限尺寸标度时,要么取 $l=N/2$ 固定奇偶性,要么对相邻两个切口取平均。
主线四:传统 DMRG
有了判据,就能造机器了。传统 DMRG 的”机器”是一个会长的块:左块从左往右长,右块从右往左长,中间留两个自由格点,每次长一格、截断一次。
块算符:为什么 J2 需要两套边缘算符
左块存的东西不多,但要刚刚够:
| 算符 | 作用位置 |
|---|---|
| $I$ | 整块恒等 |
| $H_A$ | 块内的 $J_1$、$J_2$ 键 |
| $S^z_1,S^+_1,S^-_1$ | 块最右端格点 |
| $S^z_2,S^+_2,S^-_2$ | 块次右端格点 |
前两行是”块自己”,后两行是”块伸出去的手”。为什么需要第二套手? 因为 $J_2$ 的作用距离是 2:
- 加一个新格点时,它与块的最右端有 $J_1$ 键,与次右端有 $J_2$ 键;
- 超块里还有两个距离为 2 的跨接键:左块最右端 ↔ 右自由格点、左自由格点 ↔ 右块最左端。
只留一套边缘算符,你会在”加格点”时漏掉 $J_2$,或者在超块里把跨接键计错。这不是实现细节,是 $J_2$ 与 $J_1$ 的本质区别:作用距离每加 1,块就要多背一套边缘算符(这也是为什么长程相互作用的 MPO 键维会变大的原因,见主线五)。
块增长(左块加一格):
新的边缘算符是
右块做镜像。
超块与一次增长
超块的基矢是四段拼起来的:
哈密顿量由五类项组成:
| 项 | 形式 | 系数 |
|---|---|---|
| 块内 | $H_A\otimes I\otimes I\otimes I_B$,$I_A\otimes I\otimes I\otimes H_B$ | 1 |
| $J_1$:$A$–$L$、$L$–$R$、$R$–$B$ | 三对边缘算符 | $J_1$($zz$ 带 $\Delta$,$+-$ 带 $1/2$) |
| $J_2$:$A$–$L$、$R$–$B$ | 用第二套边缘算符 | $J_2$ |
| $J_2$ 跨接:$A_{\rm last}$–$R$、$L$–$B_{\rm first}$ | 左块最右端 ↔ 右自由格点;左自由格点 ↔ 右块最左端 | $J_2$ |
| — | — | — |
每一项都是 $O_A\otimes o_L\otimes o_R\otimes O_B$ 的张量积,所以超块矩阵可以用 Kronecker 积直接拼出来——这就是”传统” DMRG 最朴素的地方:它不构造 MPS,它构造一个 $(4\chi^2)\times(4\chi^2)$ 的矩阵。
一次增长的全部动作:
- 构造超块 $H$,对角化(或 Lanczos)求基态 $\Psi_{a s_L,s_R b}$;
- 把系数重排成矩阵 $M_{(a s_L),(s_R b)}$,按 $q$ 分块做 SVD;
- 留最大的 $\chi$ 个奇异值,得到 $U$(左)与 $V$(右);
- 用 $U$ 投影扩大的左块($O_{\rm new}=U^\dagger O_{\rm full}U$),用 $V$ 投影右块;
- 记录 $E$、$E/N$、$\varepsilon$。
注意第 4 步的方向:右扫时只更新左块(用 $\rho_L$),左扫时只更新右块(用 $\rho_R$)。同一次增长里,你只有一个块是”新”的,另一个用的是上一次存下来的旧基。 这句话是理解 finite DMRG 的钥匙。
infinite DMRG
从”左 1 格 + 右 1 格 + 中间 2 个自由格点”出发($N=4$),每次左右各加一格,$N=4,6,8,\ldots$。$\chi=32$、$J_2=0$:
| $N$ | 块大小 | 实际 $\chi$ | $E$ | $E/N$ | $\varepsilon$ | $E_{\rm ED}$ | $\lvert E-E_{\rm ED}\rvert$ |
|---|---|---|---|---|---|---|---|
| 4 | 1 | 2 | $-1.616025403784$ | $-0.4040063509$ | 0 | $-1.616025403784$ | $2\times10^{-16}$ |
| 6 | 2 | 4 | $-2.493577133888$ | $-0.4155961890$ | 0 | $-2.493577133888$ | $4\times10^{-16}$ |
| 8 | 3 | 8 | $-3.374932598688$ | $-0.4218665748$ | 0 | $-3.374932598688$ | $2\times10^{-15}$ |
| 10 | 4 | 16 | $-4.258035207283$ | $-0.4258035207$ | 0 | $-4.258035207283$ | $4\times10^{-15}$ |
| 12 | 5 | 32 | $-5.142090632841$ | $-0.4285075527$ | $3.3\times10^{-13}$ | $-5.142090632841$ | $2\times10^{-15}$ |
| 14 | 6 | 32 | $-6.026724661828$ | $-0.4304803330$ | $7.8\times10^{-11}$ | $-6.026724661862$ | $3\times10^{-11}$ |
| 16 | 7 | 32 | $-6.911737137904$ | $-0.4319835711$ | $1.1\times10^{-11}$ | $-6.911737145575$ | $8\times10^{-9}$ |
读表:$N\le12$ 时块维数还没撞到 $\chi=32$ 的天花板($2,4,8,16,32$),所以没有截断,能量与 ED 逐位重合到机器精度——这是对”超块 + 块算符”这套机器最硬的检验。$N=14$ 起开始真截断,$\varepsilon\sim10^{-11}$,能量误差 $10^{-11}$ 到 $10^{-9}$。
$\varepsilon$ 列里有两件事要看:$N=12$ 的 $3.3\times10^{-13}$ 不是零——块从 16 长到 32 时正好撞上天花板,SVD 从 64 个奇异值里留 32 个,所以有一次真实截断。而 $N=14$ 的 $\varepsilon$ 比 $N=16$ 还大,这不违反单调性:每一步截断的都是不同尺寸的块,误差不是随 $N$ 单调的。
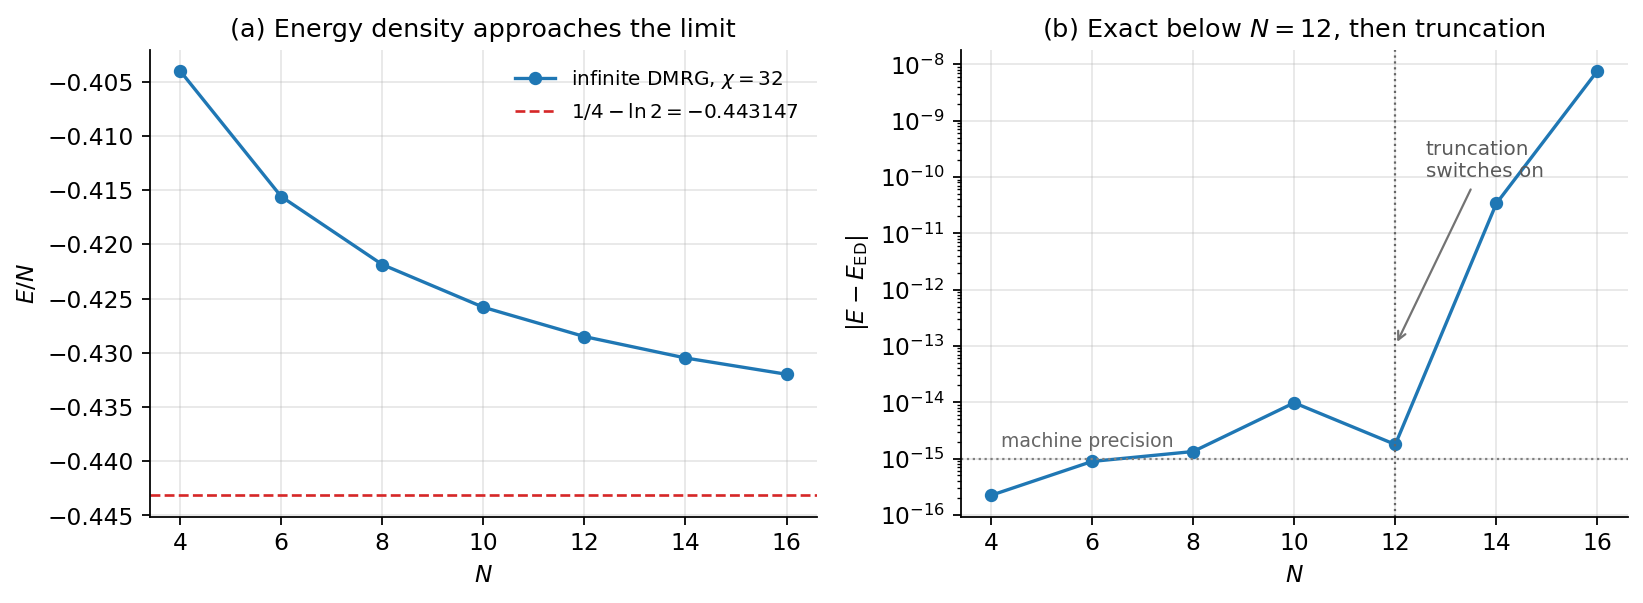
读图:(a) $E/N$ 随 $N$ 单调下降,虚线是热力学极限 $\frac14-\ln2$——infinite DMRG 每加一格就靠近极限一点,但永远到不了,因为有限链的边界能按 $1/N$ 衰减;(b) 与 ED 的差在 $N\le12$ 是 $10^{-15}$(无截断,机器精度),$N=14$ 之后跳到 $10^{-11}$–$10^{-9}$(开始真截断)。这条”跳变”就是截断开始生效的位置,它出现在块维数撞上 $\chi$ 的那一步。
finite DMRG:为什么必须扫描
infinite 算法有一个隐藏的不对称:它左右同步长。到第 $N$ 步时,左块和右块一样大,中间两个自由格点——这个”超块”是一个无限链的局部,不是你要的那个有限链。
finite 链的边界效应是真实的:两端的格点配位数少,基态在边缘的纠缠结构与体内不同。用”无限链的局部”优化出来的基去描述有限链,在边缘一定是错的。
finite DMRG 的做法是左右扫描:
- 右扫:固定右块(用之前存下的、尺寸合适的旧基),左块一格一格吸收左自由格点并截断;
- 左扫:反过来,固定左块,右块吸收右自由格点;
- 重复,直到能量不再变化。
关键在于每次只有一侧被截断,另一侧用上一次扫描留下的基。信息就这样一波一波地从一端传到另一端——“扫描”不是”多算几遍”,是”让两端的边界条件都进入基”。
$N=20$、$\chi=32$:
| $J_2$ | 方法 | $E$ | $\lvert E-E_0\rvert$ | 最大 $\varepsilon$ |
|---|---|---|---|---|
| 0 | ED | $-8.682473334399$ | 0 | — |
| 0 | infinite | $-8.682473274467$ | $6.0\times10^{-8}$ | — |
| 0 | sweep 0 | $-8.682473319650$ | $1.47\times10^{-8}$ | $9.9\times10^{-10}$ |
| 0 | sweep 1 | $-8.682473319650$ | $1.47\times10^{-8}$ | $9.9\times10^{-10}$ |
| 0.3 | ED | $-7.796938545212$ | 0 | — |
| 0.3 | infinite | $-7.796938526716$ | $1.85\times10^{-8}$ | — |
| 0.3 | sweep 0 | $-7.796938542724$ | $2.48\times10^{-9}$ | $1.5\times10^{-10}$ |
| 0.3 | sweep 1 | $-7.796938542724$ | $2.48\times10^{-9}$ | $1.5\times10^{-10}$ |
读表:扫描把误差降了 4–7 倍,然后一步都不再动——第二次扫描与第一次逐位相同,说明在 $\chi=32$ 下已经到达该截断的变分极限。“扫描不降了”不是”收敛了”,是”这个 $\chi$ 到顶了”:真正判断 $\chi$ 够不够,要看 $\varepsilon$(下一节)。
一个容易误解的地方:作业文档里还会同时报告
E_end与E_min。E_min是扫描过程中某一步的最低能量,E_end是最后一步。变分原理保证 $E\ge E_0$,但不保证 $E$ 随扫描单调下降——基在变,投影空间不嵌套。所以E_min可以比E_end低一点点(这里低 $10^{-9}$ 量级)。报告结果时报E_end,诊断收敛时看E_min与E_end的差。
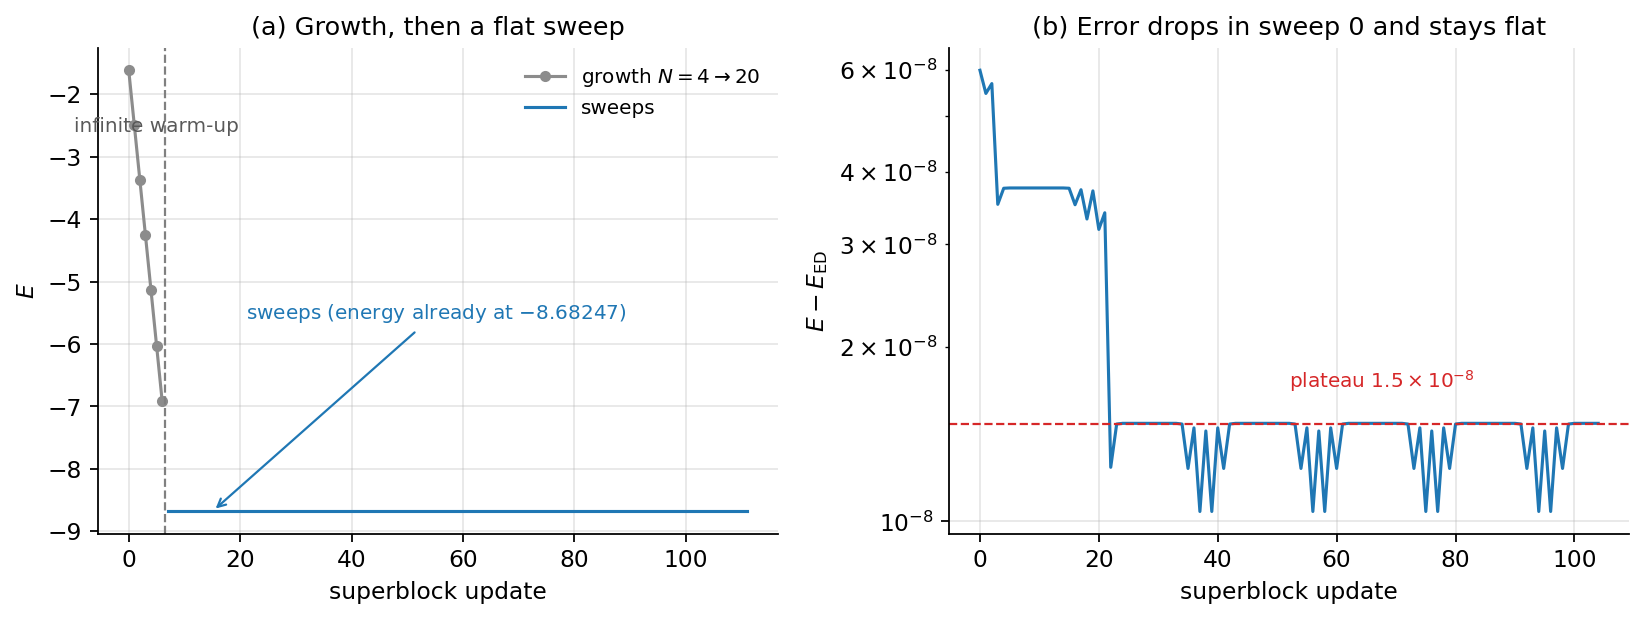
读图:横轴是”扫描步”(每个点更新一个格点),纵轴是当前超块的基态能量。虚线之前是 infinite 预热,能量随 $N$ 增长一路下降;虚线之后是有限链的扫描,能量在 $10^{-9}$ 的尺度上收敛。注意纵轴的范围——收敛后的起伏比”从 infinite 到 sweep”的那一跳小两个数量级。
χ 收敛:discarded weight 是主判据
$N=20$、$J_2=0$,把 $\chi$ 从 2 扫到 32:
| $\chi$ | $E$ | $\lvert E-E_0\rvert$ | $\varepsilon_{\max}$ |
|---|---|---|---|
| 2 | $-7.780705244136$ | $9.0\times10^{-1}$ | $4.6\times10^{-2}$ |
| 4 | $-8.654625014039$ | $2.78\times10^{-2}$ | $1.19\times10^{-3}$ |
| 8 | $-8.682024944859$ | $4.48\times10^{-4}$ | $1.89\times10^{-5}$ |
| 16 | $-8.682468365409$ | $4.97\times10^{-6}$ | $5.75\times10^{-7}$ |
| 32 | $-8.682473319650$ | $1.47\times10^{-8}$ | $9.91\times10^{-10}$ |
两个量一起看:能量误差与 discarded weight 同步下降,而且 $\lvert E-E_0\rvert$ 总是比 $\varepsilon$ 大 1–2 个数量级——这不是巧合:$\varepsilon$ 是波函数的权重损失,能量误差是它的线性响应($\delta E\sim\varepsilon\times$ 能隙尺度)。所以看到 $\varepsilon\sim10^{-9}$,就可以预期能量误差在 $10^{-8}$ 量级。
为什么 $\varepsilon$ 比”相邻两次扫描的能量差”可靠? 因为能量可能暂时平台化,而波函数仍远离本征态——两个不同的态可以有相同的能量(简并、或偶然)。$\varepsilon$ 直接度量”你扔掉了多少波函数”,不依赖能量。
判断 $\chi$ 够不够,顺序是这样的:
- 先看 $\varepsilon_{\max}$:它要小于你想要的精度(比如 $10^{-8}$);
- 再看能量随 $\chi$ 的下降是否已经”拐平”;
- 最后才看相邻扫描的能量差——它只是”扫描收敛了”的证据,不是”$\chi$ 够了”的证据。
顺序颠倒,你会得到一个自信的错误答案。
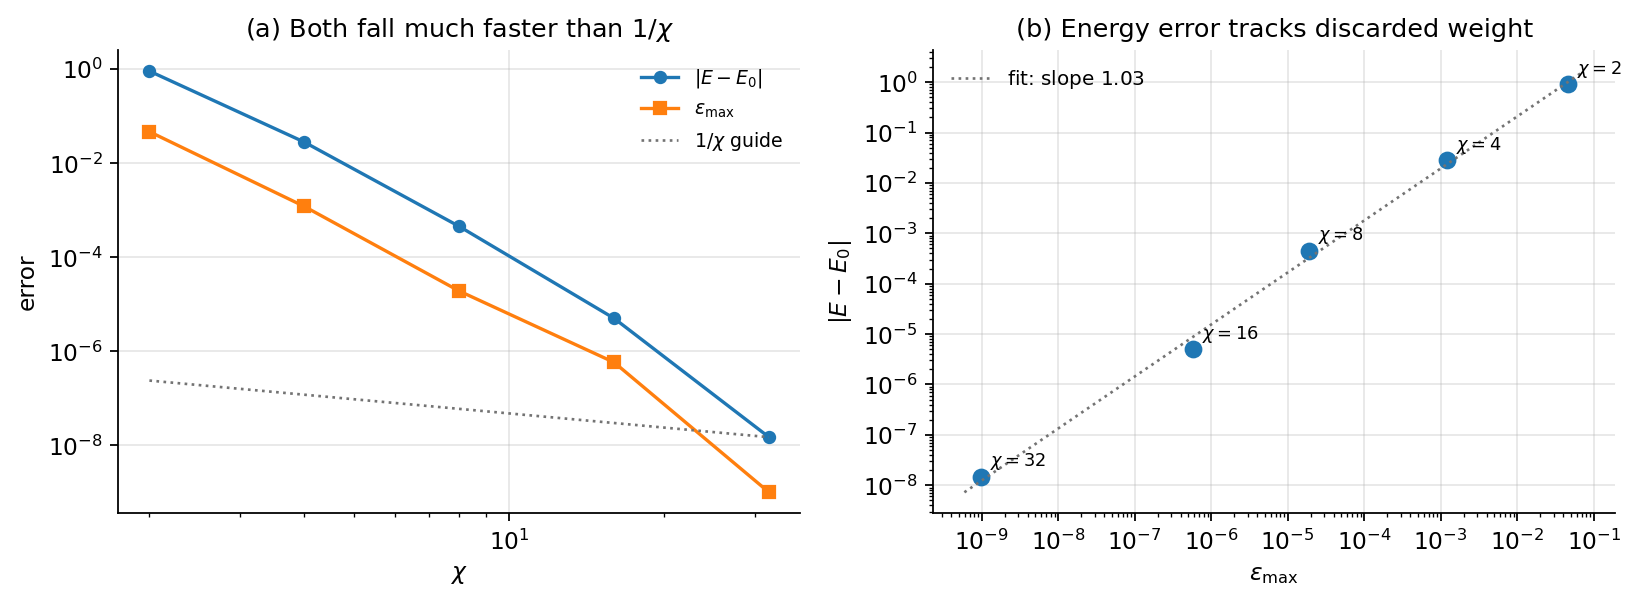
读图:(a) 双对数下 $\lvert E-E_0\rvert$ 与 $\varepsilon_{\max}$ 几乎平行下降,斜率比 $1/\chi$ 陡得多——这是选做 2 的”反面教材”:虚线 $1/\chi$ 明显偏平,拿它外推会低估 $\chi$ 的需求;(b) 把 (a) 换成 $\lvert E-E_0\rvert$ 对 $\varepsilon$ 的散点,五个点落在一条斜率约 $1$ 的直线上——能量误差就是 discarded weight 的线性响应,这句话在这里被数据直接证实。
主线五:MPS 与 MPO
幻灯片第 2 页的目录列了”MPS and MPO””MPS algorithms”,但正文到第 30 页的 finite DMRG 就停了。这不是超纲,是同一件事的另一种写法。 不补上这一节,你会以为 DMRG 是”一套关于块的技巧”;补上之后你会发现,它只是”张量网络变分”的第一个实例。
把波函数写成张量链
$N$ 个自旋的波函数有 $2^N$ 个系数 $C_{s_1\cdots s_N}$——一个 $N$ 阶张量。张量链(MPS)的写法是把它拆成一串矩阵的乘积:
其中 $a_0=a_N=1$(开边界),中间每个键的维数叫键维 $\chi$。
这不是近似,是恒等式——任何态都能这样写,只要键维足够大。做法就是逐次 SVD:把 $C$ 看成矩阵,SVD 出第一个张量,把剩下的奇异值乘进余下的部分,再对余下的部分做同样的事(附录里的 mps_from_state 就是这个循环)。
关键问题是键维要多大。 对一般的态,第 $l$ 个键的维数等于左右两半的 Schmidt 秩,最大到 $2^{N/2}$——和 ED 一样大,没有任何好处。MPS 的威力全部来自:基态的 Schmidt 谱衰减得快,所以 $\chi$ 可以远小于 $2^{N/2}$。
这正是上一节面积律的另一种说法。面积律不是”一个关于熵的观察”,它是”MPS 可以很小”的物理原因:边界小 → 纠缠小 → Schmidt 谱衰减快 → 几十个态就够。
规范自由度与混合规范
MPS 有一个规范自由度:在任意一个键上插入 $X X^{-1}$,
物理态不变。这不是麻烦,是工具——你可以用它把张量变成”正交”的。
- 左规范:$\sum_{s}A^{[i]\,s\dagger}A^{[i]\,s}=I$(把张量看成 $(\chi_{i-1}d)\times\chi_i$ 的矩阵,列正交);
- 右规范:$\sum_{s}A^{[i]\,s}A^{[i]\,s\dagger}=I$;
- 混合规范:$i$ 左边全左规范、右边全右规范,只有第 $i$ 个张量是”中心”。
混合规范是 DMRG 的全部秘密所在。 在混合规范下,中心的那个张量 $\Theta^{[i]}$ 就是 Schmidt 分解的系数矩阵:它的奇异值就是第 $i$ 个键上的 Schmidt 值。于是
不需要碰整个波函数,只要对这个 $(\chi_{l-1}d)\times\chi_l$ 的矩阵做一次 SVD。 附录里的 mps_from_state 就是”从左往右逐键 SVD、把奇异值乘给右边”的循环;把中心往右移一格,就得到下一个切口的纠缠谱。
这一点值得停下来想三秒:在 ED 里算 $S(l)$ 要重排 $2^N$ 个系数、做一次 $2^l\times2^{N-l}$ 的 SVD,$N=40$ 根本不可能;在 MPS 里它是一次 $\chi d\times\chi$ 的 SVD,代价与 $N$ 无关。同一个物理量,两种表示,代价差了指数量级。
截断就是一次 SVD
MPS 的截断极其干净:把中心张量看成矩阵 $\Theta_{(\chi_{l-1}d),\chi_l}$,SVD,留前 $\chi$ 个奇异值,把 $S V^\dagger$ 乘给右边。丢掉的权重
与主线二的 $\varepsilon$ 是同一个数——因为 $\rho_A=\Theta\Theta^\dagger$,它的本征值就是 $s_\alpha^2$。“密度矩阵截断”与”MPS 键维截断”是同一句话的两种方言。
数值上,把 $N=16$、$J_2=0$ 的精确基态直接做 MPS 分解,在每个键上截断到 $\chi$:
| $\chi$ | $\lvert E-E_0\rvert$ | 累计 discarded weight |
|---|---|---|
| 2 | $3.10$ | $4.81\times10^{-1}$ |
| 4 | $9.87\times10^{-2}$ | $1.09\times10^{-2}$ |
| 8 | $7.44\times10^{-4}$ | $7.87\times10^{-5}$ |
| 16 | $4.10\times10^{-6}$ | $4.41\times10^{-7}$ |
| 32 | $5.55\times10^{-9}$ | $4.72\times10^{-10}$ |
| 64 | $1.00\times10^{-13}$ | $4.68\times10^{-15}$ |
读表:$\chi$ 每翻一倍,误差掉 1–2 个数量级。注意这是”对精确态做截断”的结果,不是 DMRG 的结果——它是一个上界:DMRG 通过自洽优化,能用同样的 $\chi$ 做得更好(因为它不必保持”精确态的最佳投影”,它直接找变分最优)。
MPO:键维只与作用距离有关
既然态是矩阵乘积,算符能不能也写成矩阵乘积? 能:
MPO 的键维 $D$ 不随 $N$ 增长,只随相互作用距离增长。 这是它比”$2^N\times2^N$ 的矩阵”优越的全部原因。
构造方法是一个自动机:键指标记录”当前有什么算符已经发出、还没收尾”。对 $J_1$–$J_2$ 链,我用的通道是:
| 从 | 到 | 算符 | 含义 |
|---|---|---|---|
| 0 | 0 | $I$ | 什么都没发生 |
| 0 | 1,2,3 | $J_1S^+,J_1S^-,J_1\Delta S^z$ | 开始一条 $J_1$ 键 |
| 1,2,3 | 7 | $\tfrac12S^-,\tfrac12S^+,\Delta S^z$ | 在下一个格点收尾 |
| 0 | 4,5,6 | $J_2S^+,J_2S^-,J_2\Delta S^z$ | 开始一条 $J_2$ 键 |
| 4,5,6 | 8,9,10 | $I$ | 等一个格点 |
| 8,9,10 | 7 | $\tfrac12S^-,\tfrac12S^+,\Delta S^z$ | 再下一个格点收尾 |
| 7 | 7 | $I$ | 哈密顿量已累积,继续传递 |
$D=11$($1+3+6+1$)。这个构造不是最小的——用更聪明的编码可以压到 5–8 维;但”$D$ 与 $N$ 无关、只与距离有关”这个结论不受影响。你要记住的是这个 scaling,不是一个具体的数字。
为什么”等一个格点”要单独一个通道? 因为 MPO 的张量是位置无关的(每个格点用同一个 $W$)。如果”开始”和”等待”共用一个通道,那么在每个格点上你都可以”立刻收尾”,$J_2$ 就会被错误地当成 $J_1$。这正是我自己实现时踩过的坑:第一版 $D=8$,把 $J_2$ 的 $S^+S^-$ 变成了近邻跳跃,MPO 与稀疏 $H$ 的差恰好是 $0.5$(一个 $J_2/2$ 的跳跃项)。“位置无关”是 MPO 的优点,也是它最容易写错的地方。
验证方式只有一个:把 MPO 全收缩成矩阵,与稀疏 $H$ 逐元素比。 我的实现:
| $N$ | $\max\lvert H_{\rm MPO}-H_{\rm sparse}\rvert$ |
|---|---|
| 4 | $5.6\times10^{-17}$ |
| 6 | $1.1\times10^{-16}$ |
| 8 | $2.2\times10^{-16}$ |
| 10 | $8.9\times10^{-16}$ |
到机器精度。 这一步不做,后面的 MPS-DMRG 全是空中楼阁。
two-site DMRG:两种语言的同一件事
现在把 MPS 与 MPO 拼起来,做变分优化:固定其余张量,只优化相邻的两个(”two-site”),因为两站点更新可以同时调整键维(截断发生在这一步)。
对 $\Theta^{[i,i+1]}_{a s t b}$(左键、两个物理指标、右键),有效哈密顿量是
其中 $L,R$ 是左右环境张量(把已经优化好的部分与 MPO 收缩掉)。这就是一个 $\chi^2d^2$ 维的稀疏本征问题,用 Lanczos 求最低态;解出 $\Theta$ 后 SVD 拆开,截断到 $\chi$,继续下一对。
这套流程与传统 DMRG 一一对应:
| 传统 DMRG | MPS/MPO |
|---|---|
| 左块 $A$ 的基 | MPS 左键 $a$ |
| 块算符 $H_A$、$S^\alpha_1$、$S^\alpha_2$ | MPO 通道 $\alpha$ |
| 超块 $H$ | $L\cdot W\cdot W\cdot R$ |
| 约化密度矩阵 $\rho_L=MM^\dagger$ | $\Theta\Theta^\dagger$ |
| 按 $q$ 分块 SVD | 按扇区 SVD(可选) |
| discarded weight | 同一个 $\varepsilon$ |
| 块基变换 $O^\dagger O_{\rm full}O$ | 规范变换 + 截断 |
它们不是”两种方法”,是同一个变分问题的两套记账方式。 传统写法把”块”当黑箱,好处是直观、容易加对称性;MPS 写法把”键”显式化,好处是能推广到二维(PEPS)、能算纠缠、能接机器学习。第六讲的张量网络,就是把这张表里的”链”换成”图”。
数值上,我的 two-site MPS-DMRG 在 $N=16$、$\chi=32$ 给出
并且它顺带给出的纠缠剖面与 ED 逐点相同(这是必然的:同一个态,同一个 Schmidt 分解)。“顺带”这两个字很重要:在 ED 里算纠缠要额外的 $2^N$ 存储,在 MPS 里它是免费的副产品。
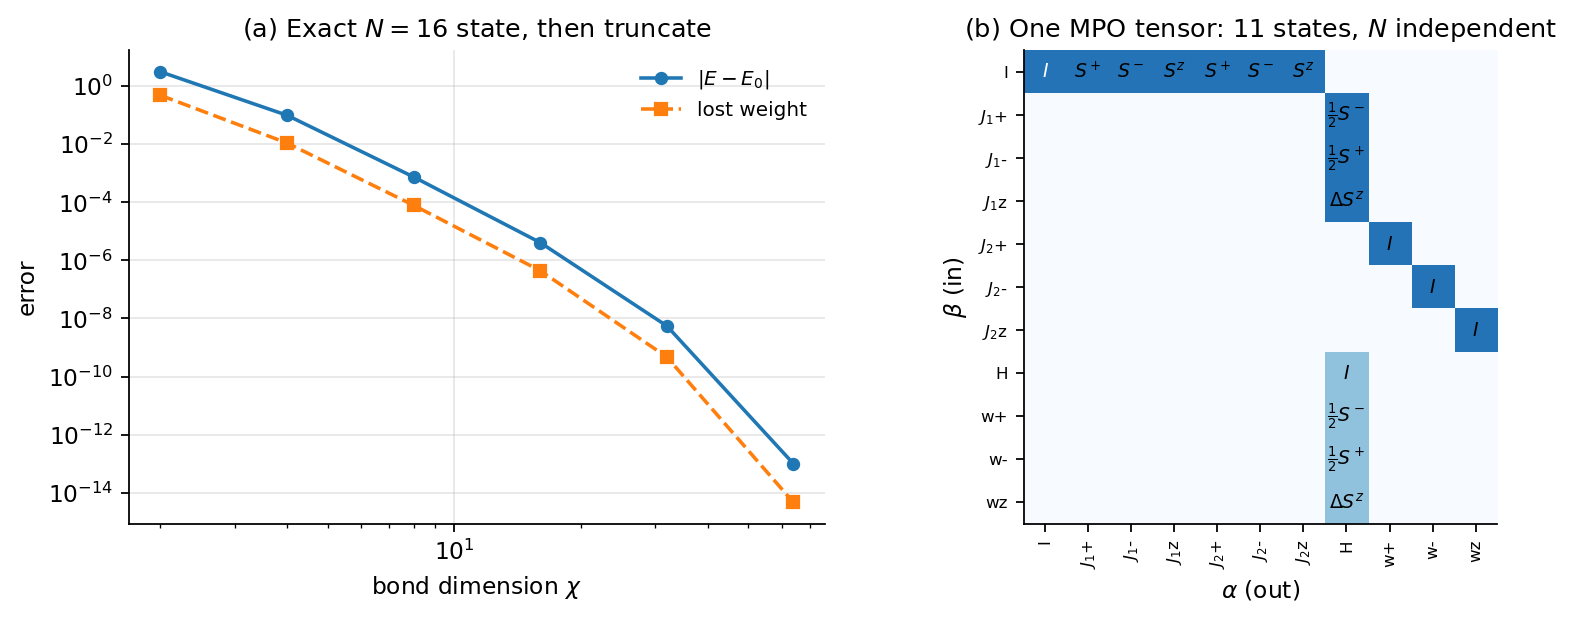
读图:(a) 对 $N=16$ 精确基态直接截断到 $\chi$ 的能量误差与累计 lost weight,两条线平行下降,$\chi=32$ 时分别是 $5.5\times10^{-9}$ 与 $4.7\times10^{-10}$;同一个 $\chi=32$,two-site DMRG 给 $2.3\times10^{-9}$,比”截断精确态”还低——因为它直接变分,不必忠于精确态。(b) 一个体点上的 MPO 张量 $W^{[i]}$:11 条通道,非零元的位置就是自动机的转移(从 $0$ 出发开键、等待一格、在 $7$ 收尾),$D=11$ 与 $N$ 无关。
怎么知道做对了
DMRG 有一句行话:“算出来的能量很低”不等于”算对了”。 变分方法天然给你一个下界以上的数,你可以用一个错的哈密顿量、一个错的边界条件、一个错的截断,得到一个”看起来很合理”的能量。所以这一节不是补充,是主线。
与 ED 逐条对照
第一层检验:在 ED 能做的尺寸上,DMRG 必须逐位重合。 $J_2=0$ 与 $J_2=0.3$:
| $N$ | $E_{\rm ED}(J_2=0)$ | $E_{\rm DMRG}(J_2=0)$ | $E_{\rm ED}(J_2=0.3)$ | $E_{\rm DMRG}(J_2=0.3)$ |
|---|---|---|---|---|
| 4 | $-1.616025403784$ | $-1.616025403784$ | $-1.524499799840$ | $-1.524499799840$ |
| 6 | $-2.493577133888$ | $-2.493577133888$ | $-2.304775495320$ | $-2.304775495320$ |
| 8 | $-3.374932598688$ | $-3.374932598688$ | $-3.087446257868$ | $-3.087446257868$ |
| 10 | $-4.258035207283$ | $-4.258035207283$ | $-3.871304707478$ | $-3.871304707478$ |
| 12 | $-5.142090632841$ | $-5.142090632841$ | $-4.655832991489$ | $-4.655832991489$ |
为什么前四行必须”逐位相同”而不是”接近”? 因为 $N\le12$ 时块维数还没撞到 $32$,$\varepsilon=0$,DMRG 只是把 ED 换了一种算法去做——中间没有任何近似,差一位都是 bug。这个检验能抓住:超块项漏写、$J_2$ 边缘算符用错、$q$ 标签对错、Kronecker 顺序错。
第二层:周期 vs 开边界。这是最容易被”看起来差不多”掩盖的错误:
| $N$ | 开边界 | 周期边界 | 差 |
|---|---|---|---|
| 4 | $-1.616025403784$ | $-2.000000000000$ | $0.384$ |
| 6 | $-2.493577133888$ | $-2.802775637732$ | $0.309$ |
| 8 | $-3.374932598688$ | $-3.651093408937$ | $0.276$ |
| 10 | $-4.258035207283$ | $-4.515446354492$ | $0.257$ |
开边界能量更高(边界格点配位数少),差值随 $N$ 减小。如果你把回绕项误加进去,$N=8$ 会得到 $-3.6511$ 而不是 $-3.3749$——差 $0.28$,大到不可能被当成截断误差。
MG 点:一个严格解
上面两层检验都拿 ED 当标尺。这一节换一个不依赖 ED 的严格解:Majumdar–Ghosh 点 $J_2=J_1/2$、$\Delta=1$,二聚体乘积态
是精确本征态,能量
它给了三条独立的判据:能量、残差、重叠。
| $N$ | $E_{\rm DMRG}$ | $-3N/8$ | 残差 $\lVert H\lvert D_0\rangle-E_0\lvert D_0\rangle\rVert$ | 重叠 |
|---|---|---|---|---|
| 8 | $-3.000000000000$ | $-3$ | $2.7\times10^{-15}$ | $1.000000000000$ |
| 10 | $-3.750000000000$ | $-3.75$ | $1.7\times10^{-15}$ | $1.000000000000$ |
| 12 | $-4.500000000000$ | $-4.5$ | $0$ | $1.000000000000$ |
| 14 | $-5.250000000000$ | $-5.25$ | $3.1\times10^{-15}$ | $1.000000000000$ |
| 16 | $-6.000000000000$ | $-6$ | $0$ | $1.000000000000$ |
残差比能量更狠:能量对波函数的误差是二阶的($\delta E\sim\delta\psi^2$),残差是一阶的。一个波函数可以有 $10^{-8}$ 的能量误差而残差只有 $10^{-8}$——反过来,残差 $10^{-15}$ 意味着波函数本身对了。所以”能量对上”只是必要条件,”残差对上”才是充分条件。
MG 点还给了纠缠的解析答案:每个切口最多切断一个 singlet,
$N=16$ 的数值:$[\ln2,0,\ln2,0,\ldots,\ln2]$,零是 $-10^{-16}$ 量级。这是本讲唯一一个”纠缠剖面可以手算”的例子,用它检验你的 $S(l)$ 代码(包括 $q$ 分块、归一化、$\ln$ 的底)最省事。
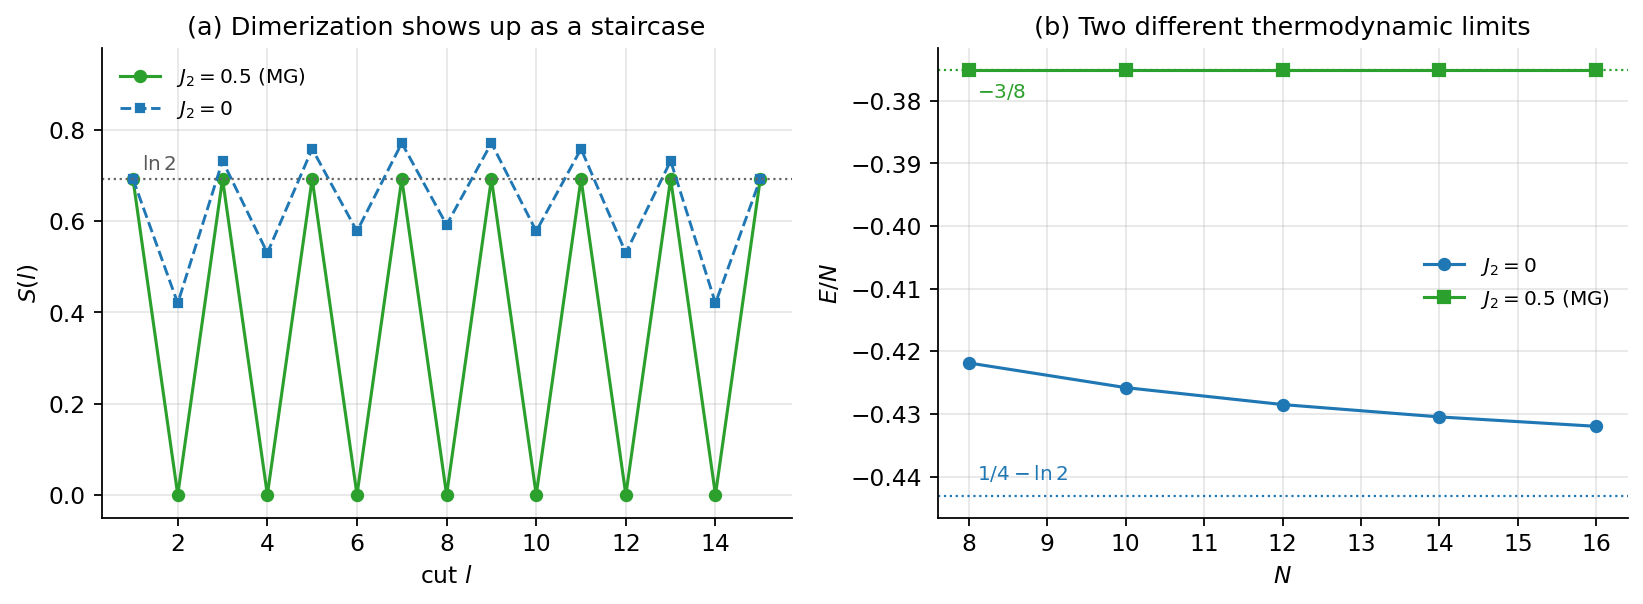
读图:(a) $J_2=0.5$ 的 $S(l)$ 是严格的 $0/\ln2$ 方波,$J_2=0$ 是缓慢上升的曲线——“二聚化”在纠缠上的签名就是方波;(b) $E/N$ 随 $N$ 趋于 $-3/8=-0.375$(MG 点)与 $-0.4431$($J_2=0$ 的海森堡极限),两条线分别收敛到各自的热力学值。
故意改错
第三层:主动把代码改错,看校检能不能抓住。 这是作业里的 --selfbreak。$N=8$、$J_2=0.3$:
| 故意错误 | 实测 $E$ | 是否被发现 | 抓的是哪类错 |
|---|---|---|---|
| 去掉 $J_2$ | $-3.374932598688$ | 是(差 $0.287$) | 漏键 |
| 加上周期回绕 | $-3.651093408937$ | 是(差 $0.564$) | 边界条件 |
| 翻转 $S^zS^z$ 符号 | $-1.617850746686$ | 是(差 $1.47$) | $zz$ 项系数 |
| 翻转 $S^xS^x+S^yS^y$ 符号 | $-3.596789850626$ | 是(差 $0.509$) | $xy$ 项系数 |
| $J_2$ 边缘算符用成 $S^\alpha_1$ | $-2.433508860620$ | 是(差 $0.129$) | 需要第二套边缘算符 |
最后一行值得单独说:把 $J_2$ 的边缘算符从”次右端”错写成”最右端”,能量只差 $0.13$——这是最危险的一类错,因为它”看起来像截断误差”。如果你只拿 $\chi=32$ 的 DMRG 去对一个没有 ED 的体系,这个错会一直陪着你。
反过来,有一类”错”永远抓不住,因为它根本不是错。 $J_2=0$ 时,把 $S^xS^x+S^yS^y$ 整体反号,整个谱一位都不变($N=8$:两种写法都给 $-3.374932598688$,差 $0$)。原因是二分晶格上的交替 $\pi$ 旋转($U=\prod_{j\ \rm odd}\sigma^z_j$)是精确对称性:每条近邻键两端宇称相反,$S^xS^x$ 与 $S^yS^y$ 同时变号。但 $J_2\ne0$ 时它不再是错——次近邻键两端宇称相同,$J_2$ 的 $xy$ 项不变号,于是 $-3.5968\ne-3.0874$。
这个细节说明:”校检通过”只说明”你的模型与参考模型在谱上等价”,不说明”你的代码逐行正确”。 等价变换(全局旋转、基的重排、$q\to-q$)不改变能量,却能改变波函数、关联函数、纠缠谱。要抓这类错,必须比对波函数(重叠、残差),不能只比能量。
为什么值得,边界在哪
一维:$\chi=32$ 已经到 $10^{-8}$
$J_2=0$、开边界,把 $N$ 推过 ED 的墙:
| $N$ | $\chi$ | $E$ | $E/N$ | $\varepsilon$ | 与精确值 |
|---|---|---|---|---|---|
| 20 | 32 | $-8.682473319650$ | $-0.4341236660$ | $9.9\times10^{-10}$ | ED: $1.5\times10^{-8}$ |
| 24 | 48 | $-10.453785760144$ | $-0.4355744067$ | $1.2\times10^{-11}$ | 无 ED |
| 32 | 64 | $-13.9973156192$ | $-0.4374161131$ | $6.9\times10^{-12}$ | 无 ED |
| $\infty$ | — | — | $-0.4431471806$ | — | $\tfrac14-\ln2$ |
热力学极限是解析的:自旋 $1/2$ 海森堡链的基态能量密度
$N=20$ 的 $-0.4341$ 离它还有 $2\%$——这不是 DMRG 的错,是有限尺寸的边界能。开边界链的能量密度按 $e(N)=e_\infty+a/N+\cdots$ 收敛,所以拿 $N=20,24,32$ 做 $1/N$ 外推,会非常接近 $-0.4431$:
| 外推方式 | 截距 | 与精确值的差 |
|---|---|---|
| $1/N$ 线性(20,24,32) | $-0.4429014$ | $0.06\%$ |
| $1/N$ 二次(20,24,32) | $-0.4431298$ | $0.004\%$ |
这就是”有限链 + 外推”的全部威力:只用 $N\le32$ 的链,就把热力学极限定到了 $10^{-4}$。注意外推的不是能量误差,是尺寸效应——$\chi$ 的误差 $10^{-12}$ 早就比尺寸效应小三个数量级了,所以这里的外推是可信的;反过来,如果 $\chi$ 不够,外推只会把截断误差放大。
$N=40$、$\chi=64$ 的报告值是 $E=-17.541473298258$、$E/N=-0.4385368325$——离极限还差 $1\%$,符合 $1/N$ 的预期。注意 $\chi$ 只需要 64,而 $N$ 从 20 涨到 40 翻了一倍。 这就是面积律的兑现:$N$ 指数增长,$\chi$ 几乎不变。
二维:面积律变成”周长律”,$\chi$ 指数爆炸
一维的面积律说”纠缠只来自切口”,切口是 0 维的两个点,所以 $S=O(1)$。二维的切口是一条线,长度 $L_y$,于是
把二维柱面(周长 $L_y$)压成一条 MPS 链,键维随 $L_y$ 指数增长。 这是 DMRG 在二维的根本困难,不是实现问题。
实际能做到的:$L_y=4$–$12$ 的柱面,$\chi$ 到 $10^3$–$10^4$,配合外推。这正是 2020 年代以来研究掺杂 Hubbard / $t$–$J$ 模型(条纹、赝能隙)的主力工具——不是因为它快,是因为它在窄柱面上仍然”几乎精确”。
边界在哪,一句话:
DMRG 的代价由纠缠决定。 一维有能隙:$S$ 饱和,$\chi$ 常数;一维临界:$S\sim\ln N$,$\chi\sim N$ 多项式;二维:$S\sim L_y$,$\chi\sim e^{L_y}$。
通往张量网络
把这张表再抽象一层,就是第六讲:
| DMRG | 张量网络 | |
|---|---|---|
| 态 | 矩阵乘积态(MPS,一条链) | PEPS(二维网格)、MERA(分层) |
| 截断 | 每次 SVD 到 $\chi$ | 每次 SVD/优化到 $\chi$ |
| 一维 | 近乎精确 | 等价于 DMRG |
| 二维 | 柱面近似 | 直接作用在二维,代价 $\chi^{O(L_y)}$ |
| 关键问题 | $\chi$ 够不够 | 收缩顺序、规范、边界 |
DMRG 是张量网络的”一维特例”;反过来,张量网络是 DMRG 的”任意图推广”。你在本讲学的 SVD 截断、规范、环境张量,一个都不会浪费。
作业要点与评分
作业(Lecture05_Homework):开边界 $J_1$–$J_2$ XXZ 链上的传统 DMRG,五个必做 + 两个校检 + 四个选做。
评分(100 分):
| 项 | 分值 | 说明 |
|---|---|---|
| 源码可运行 | +10 | run_all.py 一键跑通 |
| 结果正确 | +20 | 与本文表格对照 |
| 可读性 | +10 | 函数分节、命名清楚 |
| 笔记:原理 | +10 | 为什么是密度矩阵,不是能量 |
| 笔记:源码 | +10 | 逐段解释,不是贴代码 |
| 笔记:结果 | +10 | 表格 + 图 + 物理解读 |
| 笔记:好读 | +10 | 叙事、判断句、总结 |
| AI 使用日志 | +20 | 最大单项 |
| 不做截断 | −20 | 直接返回满维,等于没做 DMRG |
| 不报 discarded weight | −20 | 无法判断 $\chi$ 够不够 |
| 时间 | $+5$ / $-1$ 每天 | 按时交 |
| 自选加分 | +10 | 新想法、额外结果 |
两个 $-20$ 值得盯着看:它们正好对应本讲的两个核心——截断与误差度量。这门课用扣分告诉你:不做截断就不是 DMRG,不报 $\varepsilon$ 就等于没有误差棒。 反过来,AI 日志给到 $+20$,说明课程要的不是”你手写了多少行”,是”你知道每一行为什么这么写”。
五个必做(与本文一一对应):
- 超块:$N=4,6,8,10$ 与 ED 对照(主线四);
- 截断比较:密度矩阵 vs 能量,$m=2,\ldots,16$(主线二);
- infinite DMRG:$N\le16$ 与 ED 对照(主线四);
- finite DMRG:$N=20$、$J_2=0,0.3$(主线四);
- $\chi$ 收敛:$\chi=2,4,8,16,32$ 的能量与 $\varepsilon$(主线四)。
四个选做:纠缠剖面(主线三)、$1/\chi$ 外推、$N\ge40$、二聚化。
关于选做 2($1/\chi$ 外推)的一句提醒:用 $\chi=4,8,16,32$ 的能量对 $1/\chi$ 做线性外推,会得到比 $\chi=32$ 更差的”极限值”。原因不是数据错,是模型错:误差随 $\chi$ 的下降比 $1/\chi$ 快得多(本文数据每翻倍掉 1.5–2 个数量级),用 $1/\chi$ 拟合等于强行用一个慢函数去描述一个快衰减。外推之前先看 $\log$-$\log$ 斜率,这是所有”外推”的通则。
校检清单
按顺序做,每一条都能独立抓住一类错:
| # | 校检 | 期望 | 抓什么 |
|---|---|---|---|
| 1 | 厄米性 $\max\lvert H-H^\dagger\rvert$($N=8$) | 0 | 矩阵元/索引 |
| 2 | $N=2$ 全谱 | $\{-3J_1/4,\ J_1/4\times3\}$ | 键重复计数、$S^+S^-$ 系数 |
| 3 | 开边界 $N=4$ | $-1.616025403784$ | 回绕 |
| 4 | 开边界 $N=8$ | $-3.374932598688$ | 漏键/边界 |
| 5 | 周期 $N=8$ | $-3.651093408937$ | 边界条件混用 |
| 6 | infinite $N\le12$ | 与 ED 逐位相同 | 超块项、$q$ 标签 |
| 7 | MG 点残差 | $<10^{-12}$ | 波函数本身 |
| 8 | $\varepsilon$ 随 $\chi$ 单调下降 | 是 | 截断没生效 |
第 8 条最容易被忽略:如果 $\varepsilon$ 不随 $\chi$ 下降(或恒为 0),说明你要么没截断,要么截断写错了(比如按 $q$ 扇区各留 $\chi$ 个,总数远超 $\chi$)。$\varepsilon$ 是你唯一能”看见”截断的量,它必须动。
附:复现用的代码工具箱
下面这份代码独立于作业参考实现,覆盖本文所有数字:ED、Schmidt、截断比较、传统 DMRG(infinite/finite)、MPS 分解、MPO 构造与能量。约定与正文一致(比特 $j$ = 格点 $j$,$1$ = 向上,$q=2S^z$)。
# dmrg5.py -- 第五讲工具箱(精简版) |
块 DMRG(超块 + 增长 + 截断):
def site(): |
MPS/MPO:
def mps_from_state(psi, N, states, chi=None): |
复现本文数字的最短路径:
E0, psi, st, idx, H = gs(12) # -5.142090632841 |
延伸阅读与作业
三篇原始论文(幻灯片第 3 页):
- S. R. White and R. M. Noack, Density-matrix formulation of low-energy excitations of quantum systems, PRL 68, 3487 (1992).
- S. R. White, Density matrix formulation for quantum renormalization groups, PRL 69, 2863 (1992).——DMRG 的出生证明。
- S. R. White, Density-matrix algorithms for quantum renormalization groups, PRB 48, 10345 (1993).——finite DMRG 与扫描。
三篇综述,按需读:
- U. Schollwöck, The density-matrix renormalization group, Rev. Mod. Phys. 77, 259 (2005).——传统语言。
- U. Schollwöck, The density-matrix renormalization group in the age of matrix product states, Ann. Phys. 326, 96 (2011).——MPS 语言,本讲主线五的来源。
- R. Orús, A practical introduction to tensor networks, Ann. Phys. 349, 117 (2014).——通往第六讲。
作业(xxz_hw5):
run_all.py:必做 1–5 + 校检;run_all.py --optional:加选做 1–4;- 评分表见上一节,两个 $-20$ 是你最该盯住的。
如果你只记三件事:
- 截断的判据是约化密度矩阵的本征值(= Schmidt 值的平方),不是能量。 这是 DMRG 与 NRG 的全部分界。
- 一维基态满足面积律,所以键维只需几十。 二维是周长律,$\chi$ 指数爆炸——这是 DMRG 的边界,也是张量网络的起点。
- 永远报告 discarded weight。 没有 $\varepsilon$ 的能量没有误差棒;没有误差棒的结果,不是结果。